인지적 부채 - Linear의 CI 병목 개선 사례
https://linear.app/now/ci-bottleneck-reworked
2026.9.21
[AI coding has made CI a bottleneck, so we reworked ours to keep up]
인공지능 코딩 도구의 발전으로 소프트웨어 개발 속도가 빨라지면서 지속적 통합(CI) 병목 현상이 발생하자, 개발팀은 인프라 업그레이드와 공정 최적화를 통해 이 문제를 해결하고자 했습니다. 구체적으로는 하드웨어 및 툴체인 현대화, 불필요한 반복 작업 제거, 그리고 테스트 실행 효율성 극대화라는 네 가지 핵심 전략을 적용했습니다. 결과적으로 이러한 전방위적인 개선을 통해 풀 리퀘스트 대기 시간과 서버 자원 소모량을 대폭 절감함으로써, 급증하는 테스트 규모 속에서도 개발 효율성을 성공적으로 유지할 수 있었습니다.
Linear의 CI 병목 개선 사례 — 챕터별 분석
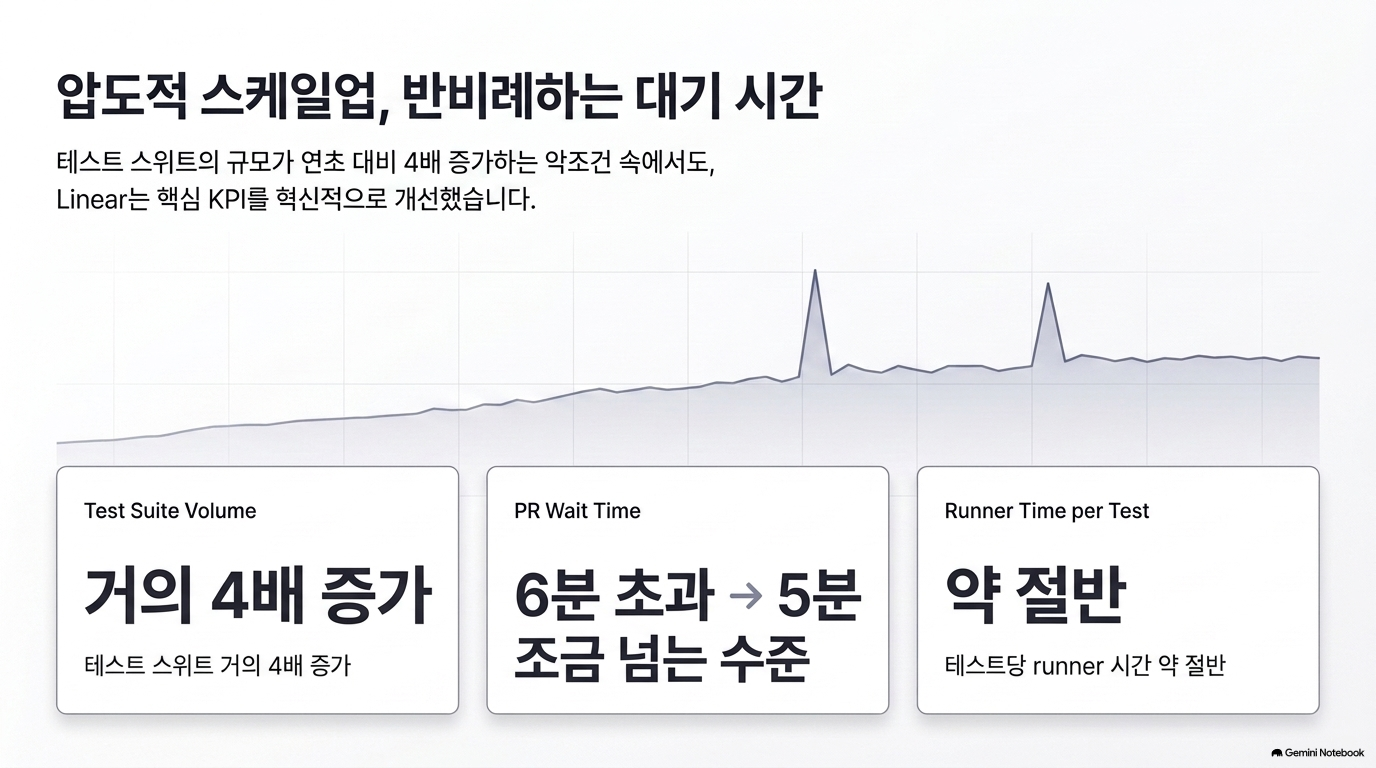
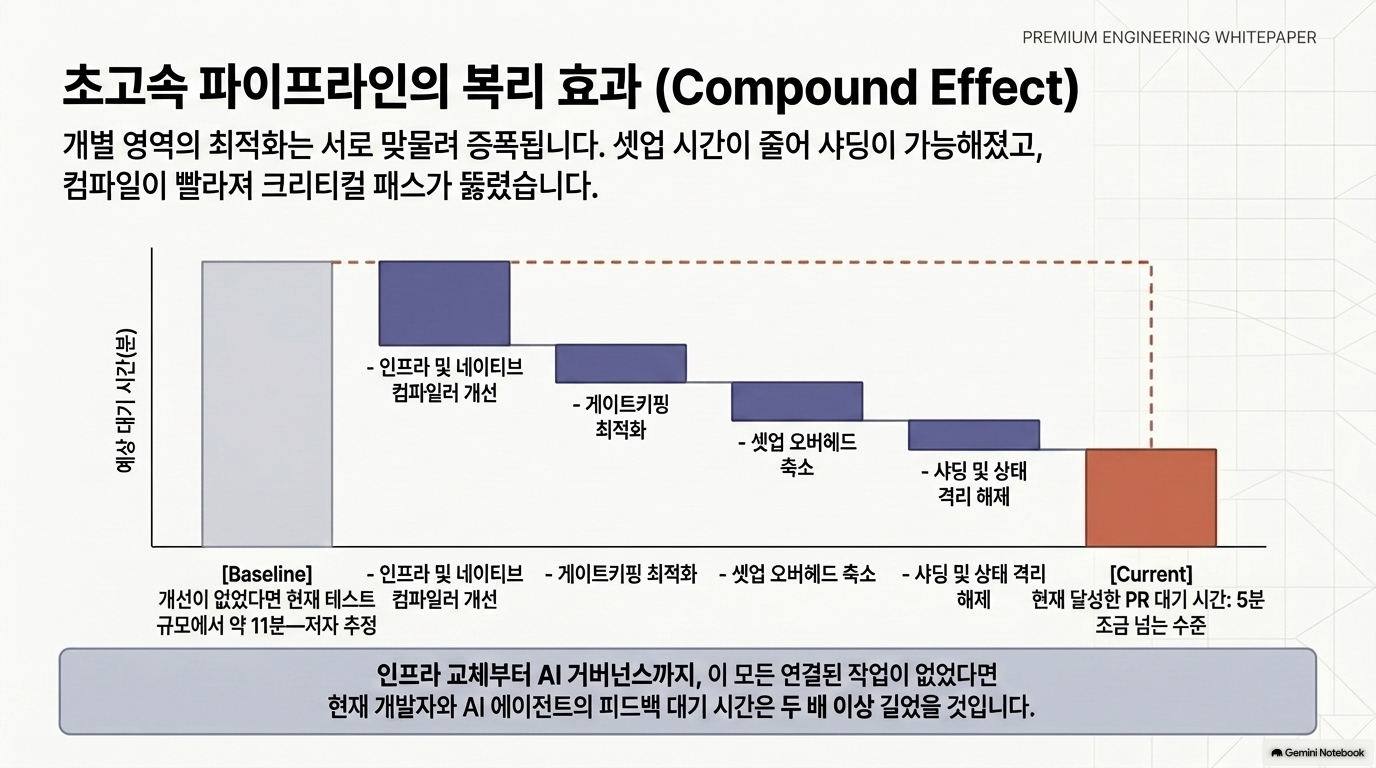
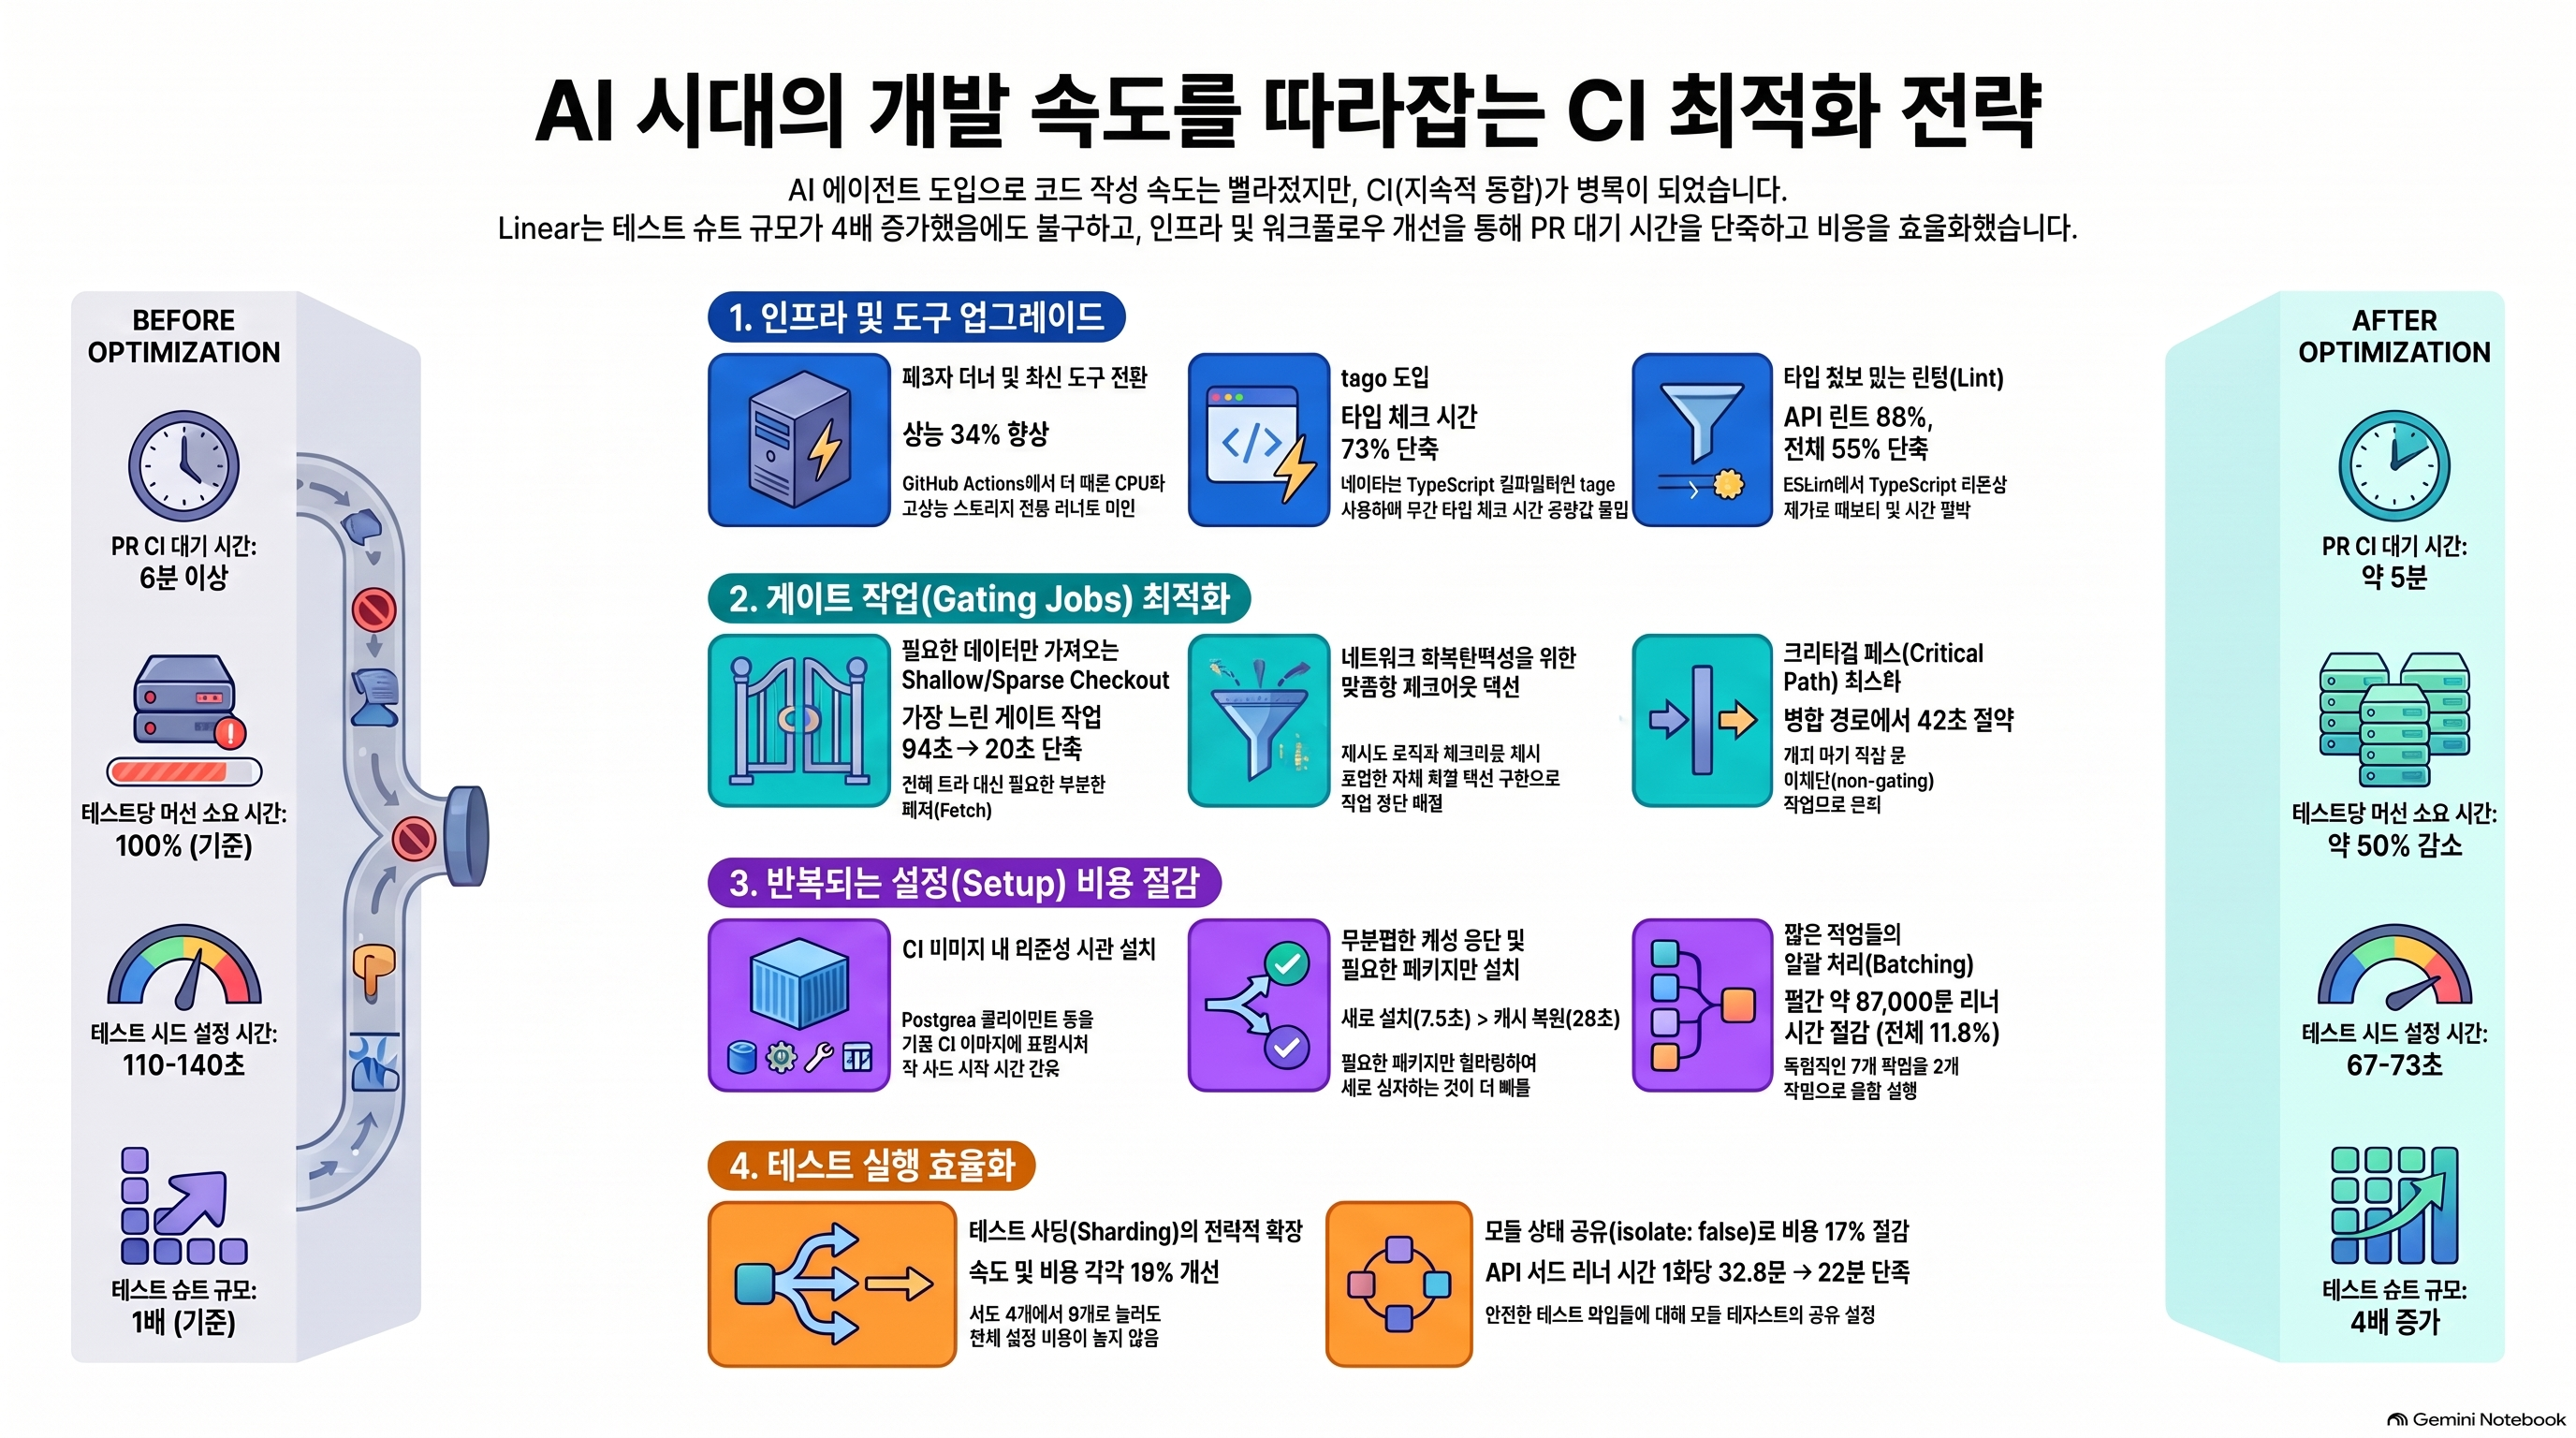
핵심 결론: 이 글은 “테스트를 더 빠르게 실행했다”는 단일 최적화 사례가 아닙니다. Linear는 PR이 결과를 기다리는 시간과 CI가 소비하는 runner 시간을 동시에 관리하면서, 선행 작업·반복 설정·테스트 분할 방식까지 파이프라인 전체를 재설계했습니다. 연초 대비 테스트 스위트가 거의 4배로 커졌는데도 PR 대기시간은 6분 초과에서 5분 조금 넘는 수준으로 줄었고, 테스트당 머신 사용시간은 대략 절반이 되었다고 보고합니다.[1]
1. 문제 정의: AI가 코드 생산보다 검증 수요를 더 빠르게 키운다
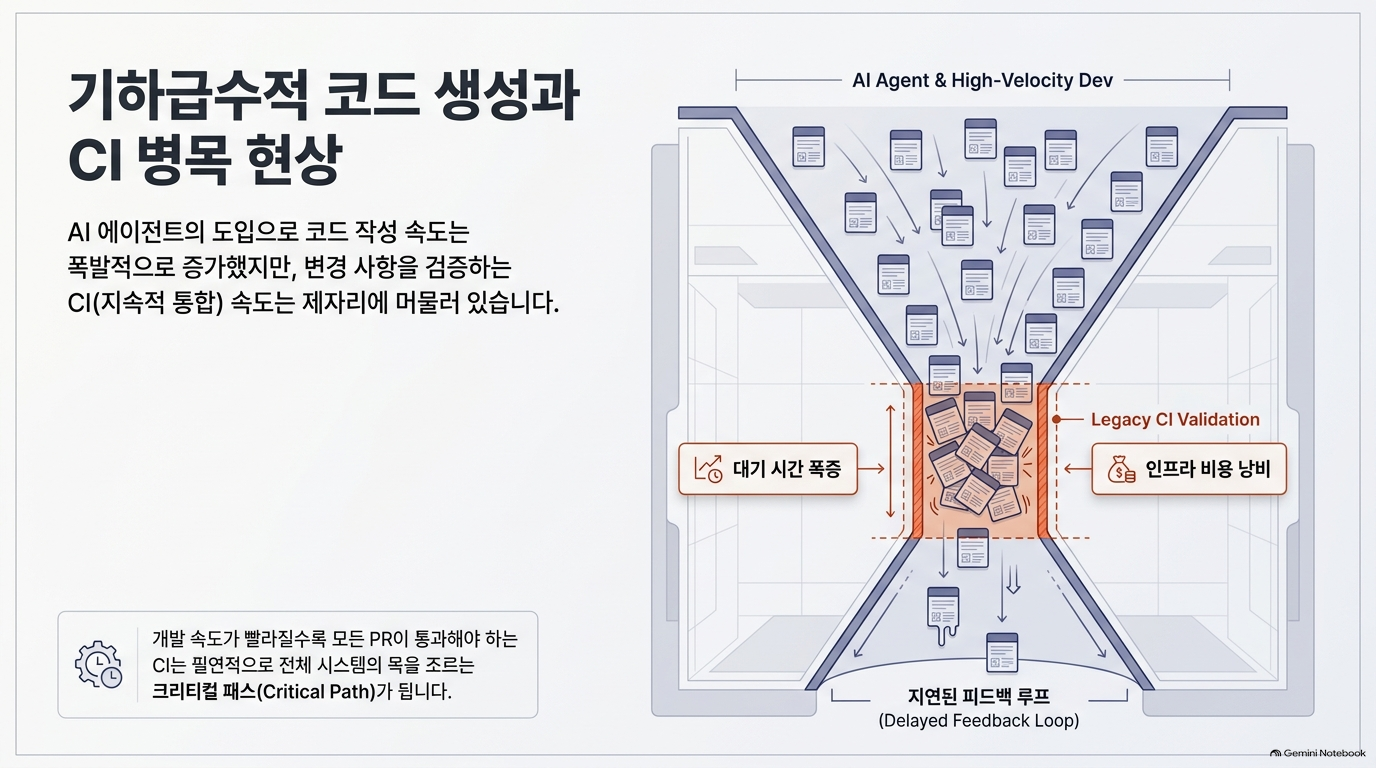
저자는 에이전트 도입으로 코드 변경 속도는 빨라졌지만, 모든 PR이 통과해야 하는 CI 검증은 같은 속도로 확장되지 않았다고 봅니다. 따라서 CI 병목은 개발자·에이전트의 피드백 대기와 인프라 비용 증가라는 두 문제로 나타납니다.[1]
여기서 중요한 것은 지표를 하나로 합치지 않았다는 점입니다.
| 지표 | 뜻 | 최적화가 실패할 수 있는 방식 |
| PR 대기시간 | 개발자가 결과를 받아 병합할 때까지 걸리는 시간 | 샤드를 늘려도 선행 job이 느리면 개선 폭이 작음 |
| Runner 시간 | 여러 job·샤드가 사용한 머신 시간의 합 | 병렬화를 늘리면 대기시간은 줄어도 총 사용량은 늘 수 있음 |
원문의 그래프 설명도 샤드 추가 시 대기시간은 줄지만 머신 사용시간은 증가하는 구간이 있었음을 명시합니다. 따라서 “CI가 빨라졌다”는 말만으로 비용 효율까지 개선됐다고 판단해서는 안 됩니다.[1]
2. 인프라와 도구 교체: 같은 작업을 더 빠른 환경에서 실행
2-1. GitHub Actions 실행기에서 제3자 runner로 이동
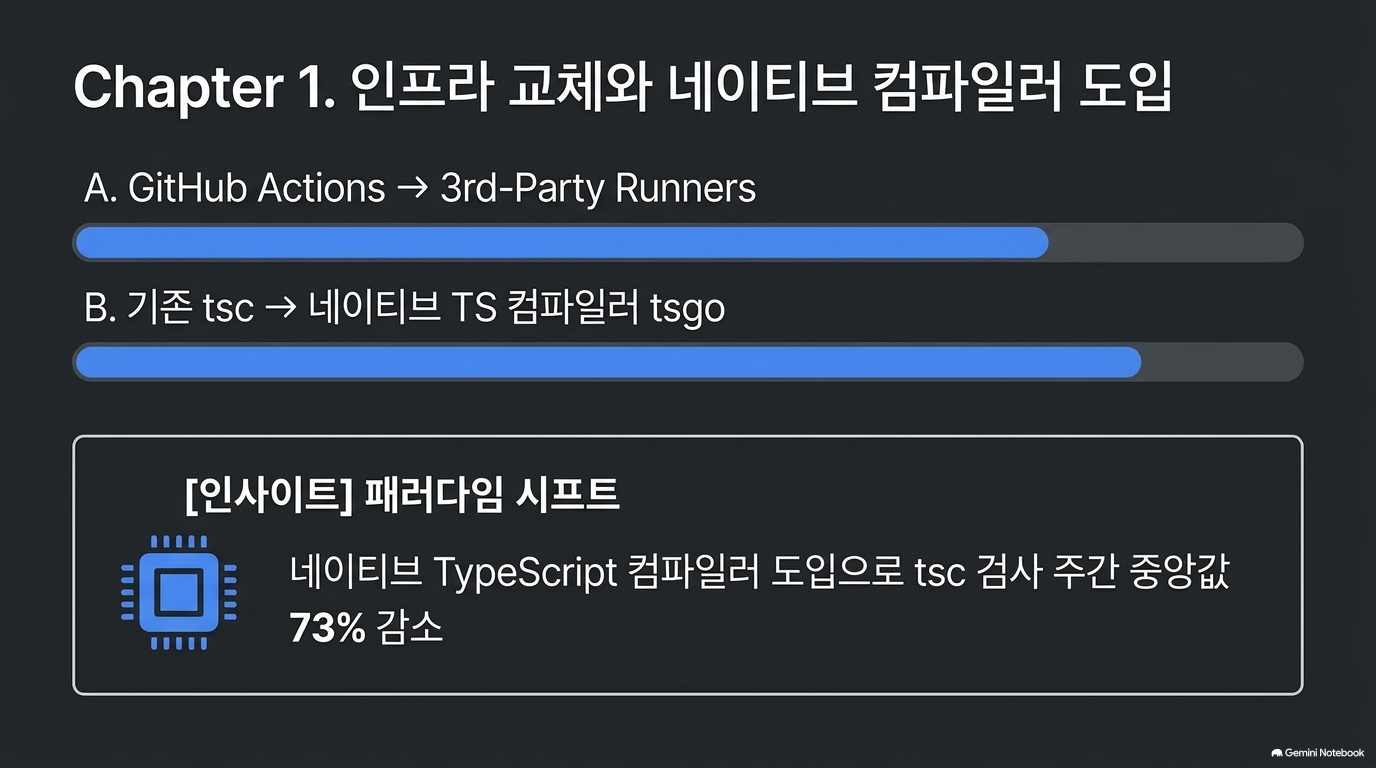
더 빠른 CPU·스토리지·캐시 인프라를 갖춘 runner로 옮겼습니다. 전환 전후 이틀을 같은 종류의 작업끼리 비교했을 때 job 실행시간은 평균 34% 감소, tsc 작업은 52% 감소했습니다. 이는 워크플로 자체를 고치기 전에 실행 환경 교체만으로 얻은 효과입니다.[1]
다만 이 수치는 전환 전후의 짧은 기간에 대한 비교입니다. 뒤에 나오는 다른 개선율과 더해 전체 성과를 계산할 수는 없습니다.
2-2. TypeScript 컴파일러 교체와 lint 규칙 재작성
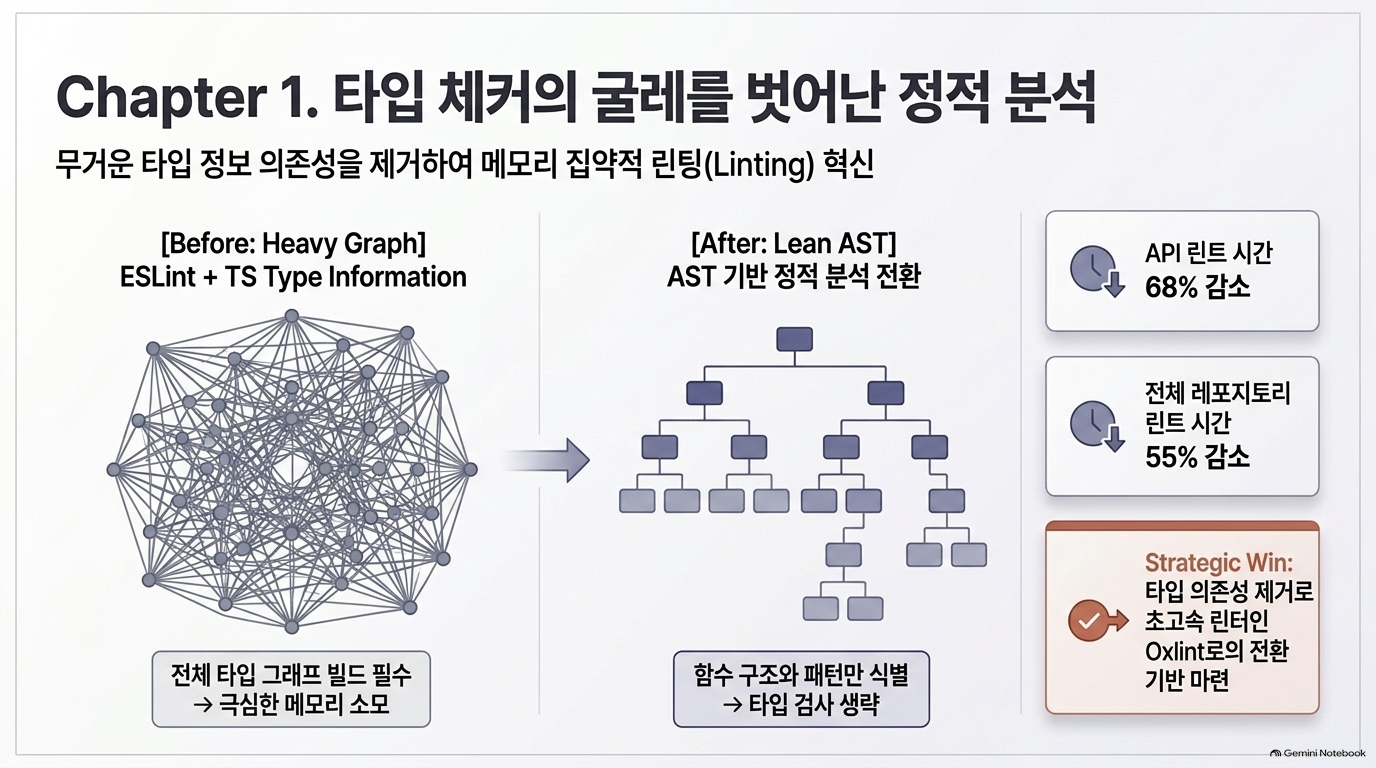
네이티브 TypeScript 컴파일러인 tsgo로 전환하자 tsc 검사 시간의 주간 중앙값이 73% 감소해, 타입 검사 자체가 더 이상 주된 병목이 아니게 됐습니다. 별도로, 타입 정보를 요구하던 사용자 정의 lint 규칙을 AST 기반 정적 분석으로 다시 작성했습니다. ESLint가 전체 타입 그래프를 만들 필요가 없어지면서 API lint 시간은 68%, 전체 저장소 lint 시간은 55% 줄었습니다. 타입 정보 의존성을 제거한 덕분에 이후 Oxlint로 옮기기도 쉬워졌습니다.[1]
해석: 더 빠른 도구로 바꾸는 것뿐 아니라, 검사가 실제로 필요로 하는 정보의 범위를 줄인 사례입니다. 단, AST만으로 충분한지는 규칙별 의미론을 검토해야 합니다. 타입에 의존해야 정확한 규칙까지 기계적으로 바꾸라는 뜻은 아닙니다.
3. 후속 작업을 막는 선행 job 최적화: 작은 지연의 큰 영향
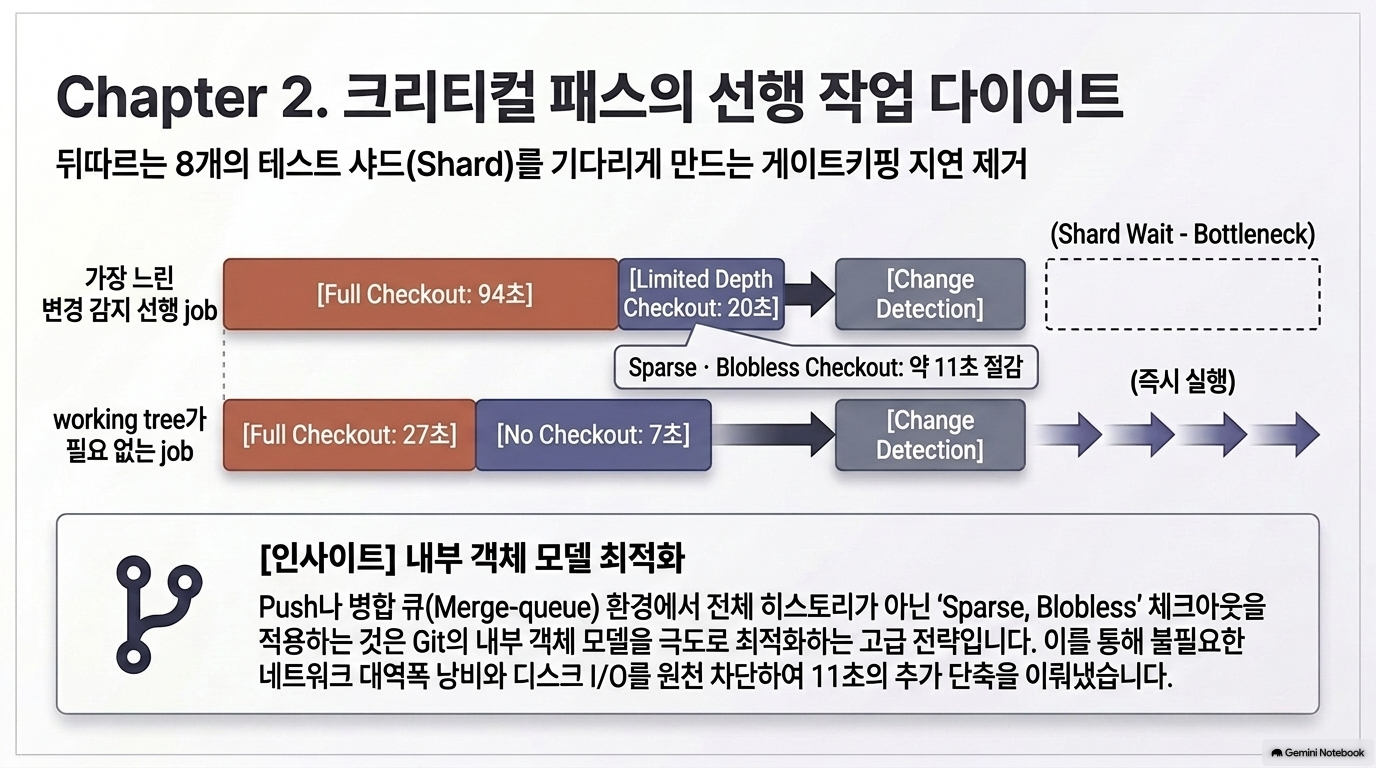
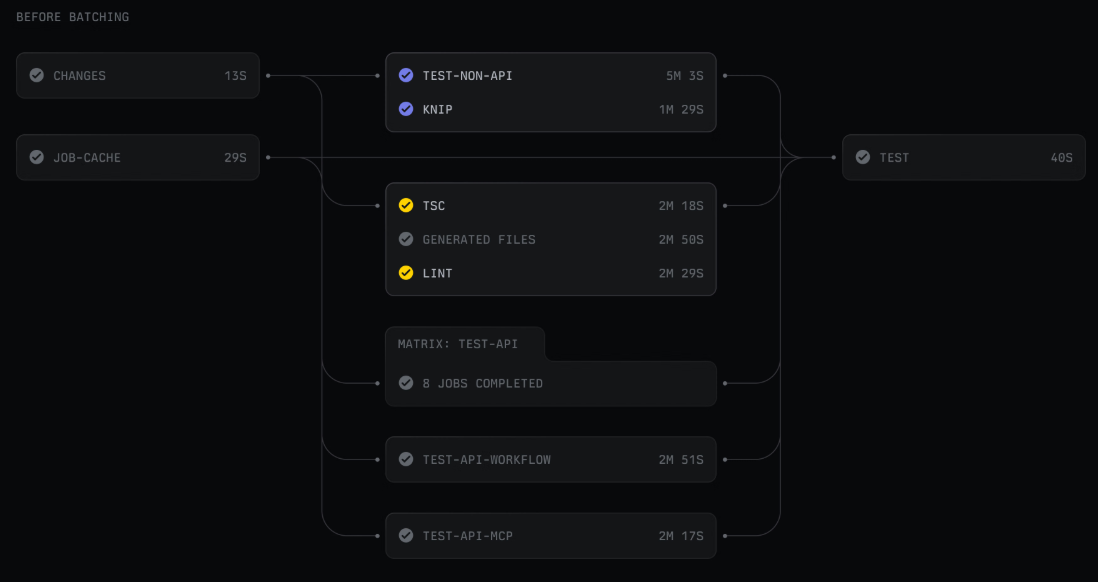
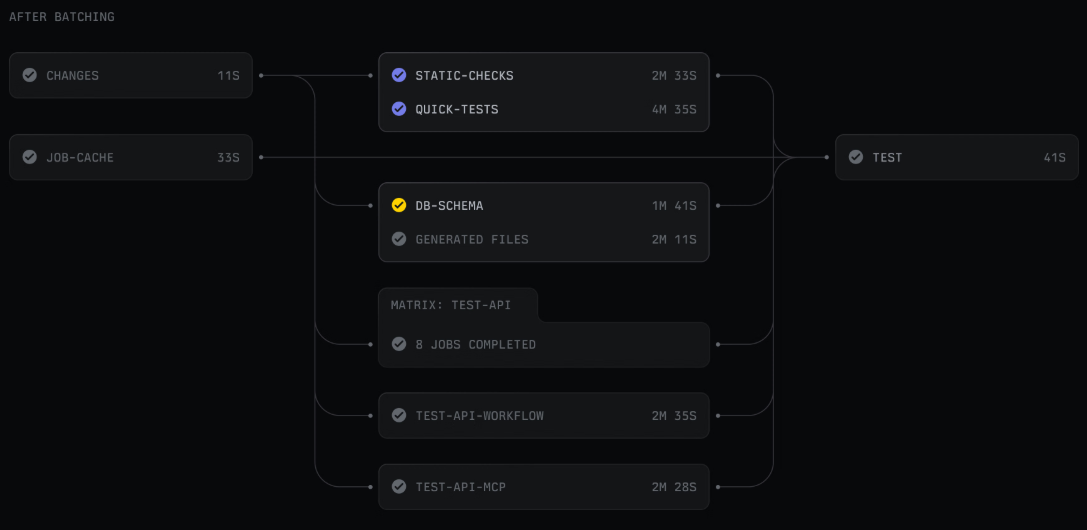
Linear의 일부 워크플로는 먼저 변경 경로와 기존 테스트 결과를 확인한 뒤 후속 job을 시작합니다. 이 선행 검사를 job 단위로 두면 불필요한 runner 예약을 피할 수 있지만, API 테스트 샤드 8개 모두가 그 결과를 기다립니다. 그래서 짧아 보이는 선행 job도 전체 완료시간의 임계 경로에 놓입니다.[1]
3-1. 필요한 Git 데이터만 가져오기
전체 working tree를 받을 필요가 없는 변경 감지 작업에 fetch 깊이 제한을 적용해, 가장 느리던 선행 작업을 94초에서 20초로 줄였습니다. working tree가 아예 필요 없는 job에서는 checkout을 없애 27초에서 7초로 줄였습니다. 경로 diff가 필요한 push·merge queue 이벤트에서는 제한된 이력의 sparse·blobless checkout으로 약 11초를 더 절약했습니다.[1]
변경 감지 job 전체의 분포도 개선됐습니다. 중앙값 26→8초, p90 31→12초, 최장 실행 138→37초입니다. 평균뿐 아니라 긴 지연 구간을 줄였다는 점이 중요합니다.[1]
3-2. Checkout 장애에 대한 복원력 확보
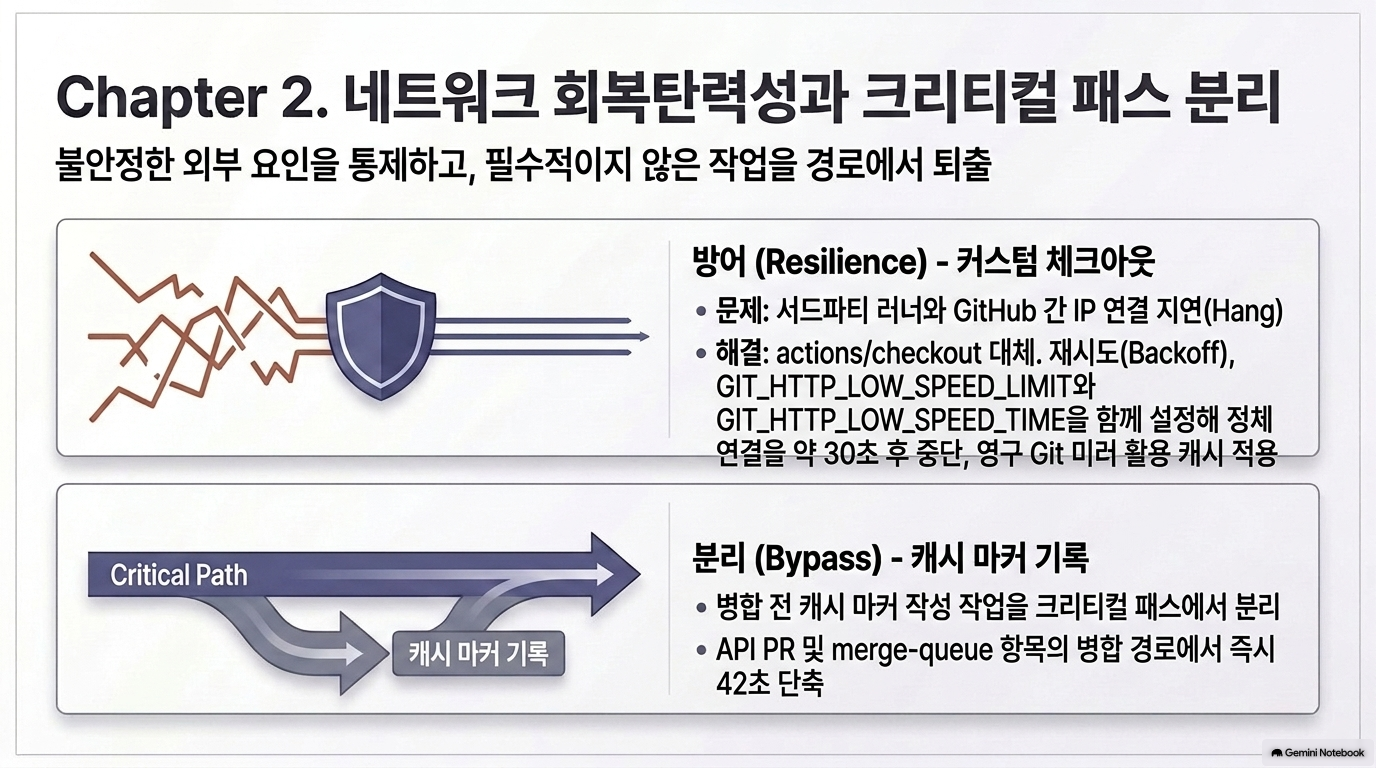
제3자 runner가 GitHub 네트워크 밖에 있어 직접 연결이 간헐적으로 저하됐고, actions/checkout이 오래 멈추는 문제가 생겼습니다. Linear는 자체 composite action에 재시도·backoff, Git의 저속 연결 중단 설정, sticky disk의 Git 미러 캐시를 넣었습니다. 정체된 연결은 약 30초 후 중단되도록 했습니다.[1]
이는 앞 절의 속도 개선과 성격이 다릅니다. 정상 실행의 몇 초를 줄이는 것보다, 드물지만 전체 파이프라인을 붙잡는 꼬리 지연과 멈춤을 통제하는 조치입니다.
3-3. 병합을 막을 이유가 없는 작업 분리
테스트가 끝난 뒤 캐시 마커를 기록하는 일이 최종 필수 검사에 포함돼 있어, PR이 merge queue에서 불필요하게 기다렸습니다. 이를 병합을 막지 않는 별도 job으로 옮겨 API PR과 merge-queue 항목의 병합 경로에서 42초를 줄였습니다. 이러한 변경을 합쳐 캐시 미스가 난 API PR의 필수 검사에서 약 1분을 단축했다고 합니다.[1]
해석: 이 챕터의 핵심은 job을 개별적으로 빠르게 만드는 것보다 의존성 그래프에서 무엇이 병합을 막아야 하는지 다시 정의하는 데 있습니다.
4. 반복 설정 제거: 실행마다 지불하는 고정비 줄이기
테스트 본체가 짧아도 runner 기동, 패키지 설치, 빌드 의존성 준비를 job마다 반복하면 시간과 비용이 커집니다. Linear는 다음 방식으로 그 고정비를 줄였습니다.[1]
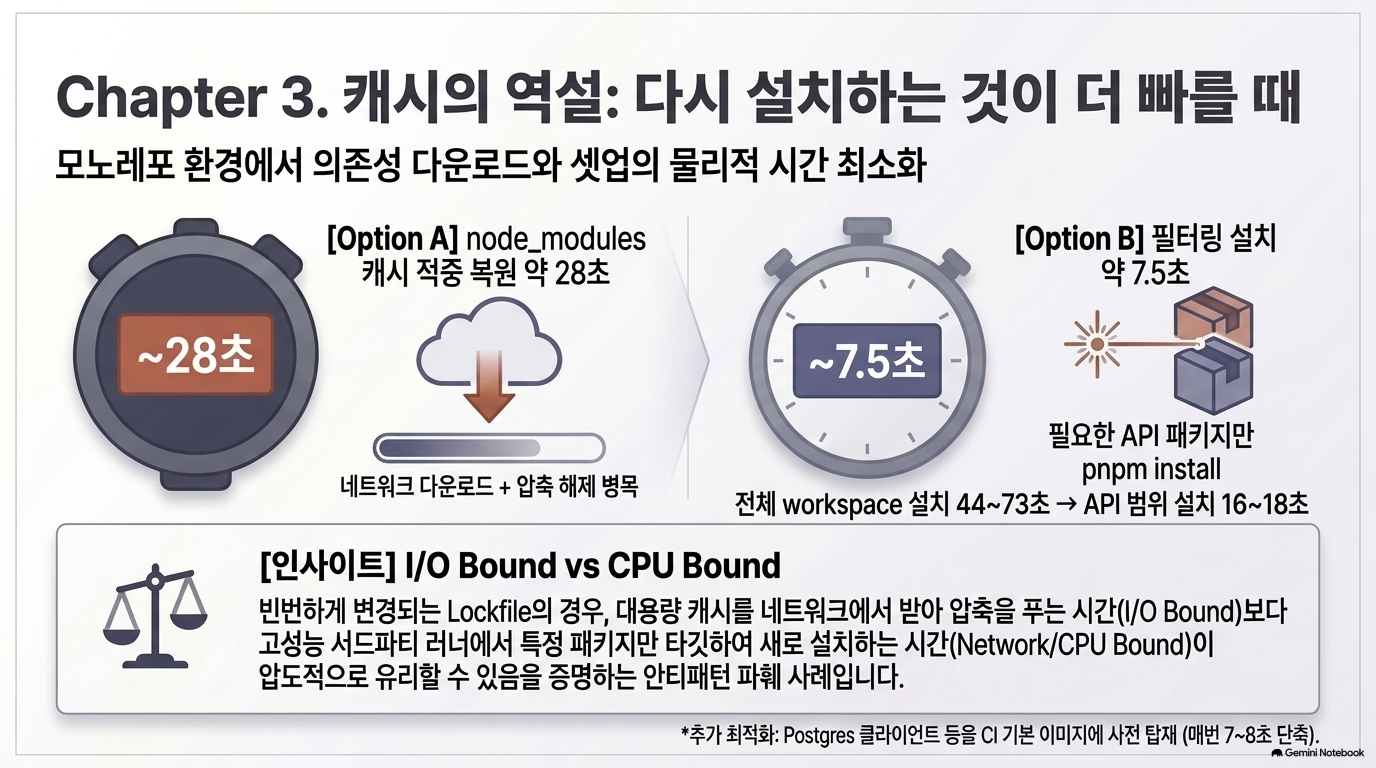
- 기본 이미지에 공통 의존성 사전 설치: API 테스트 샤드마다 Postgres 클라이언트를 설치하던 7~8초를 없앴습니다. 간헐적 다운로드 정체를 피하려고 네이티브 빌드 헤더도 이미지에 넣었습니다.[1]
- 필요한 workspace만 설치: pnpm 모노레포 전체 대신 API 패키지와 그 의존성만 설치해 44~73초를 16~18초로 줄였습니다.[1]
- 캐시의 손익 검증: node_modules 캐시 적중 시 복원에 약 28초가 걸렸지만, 필터링 설치는 약 7.5초였습니다. 자주 바뀌는 lockfile 때문에 캐시 저장 비용과 변동성까지 생겨, 이 경우에는 캐시보다 재설치가 유리했습니다.[1]
원문은 이 세 변경으로 샤드별 설정 시간이 110~140초에서 67~73초, 약 44% 감소했다고 설명합니다. 이후 글에서 언급하는 “설정 시간이 약 40초”는 추가 개선까지 반영한 뒤의 샤딩 논의 맥락으로 읽어야 하며, 두 수치를 같은 단계의 측정치처럼 취급해서는 안 됩니다.[1]
변경되지 않은 설정은 다시 실행하지 않기
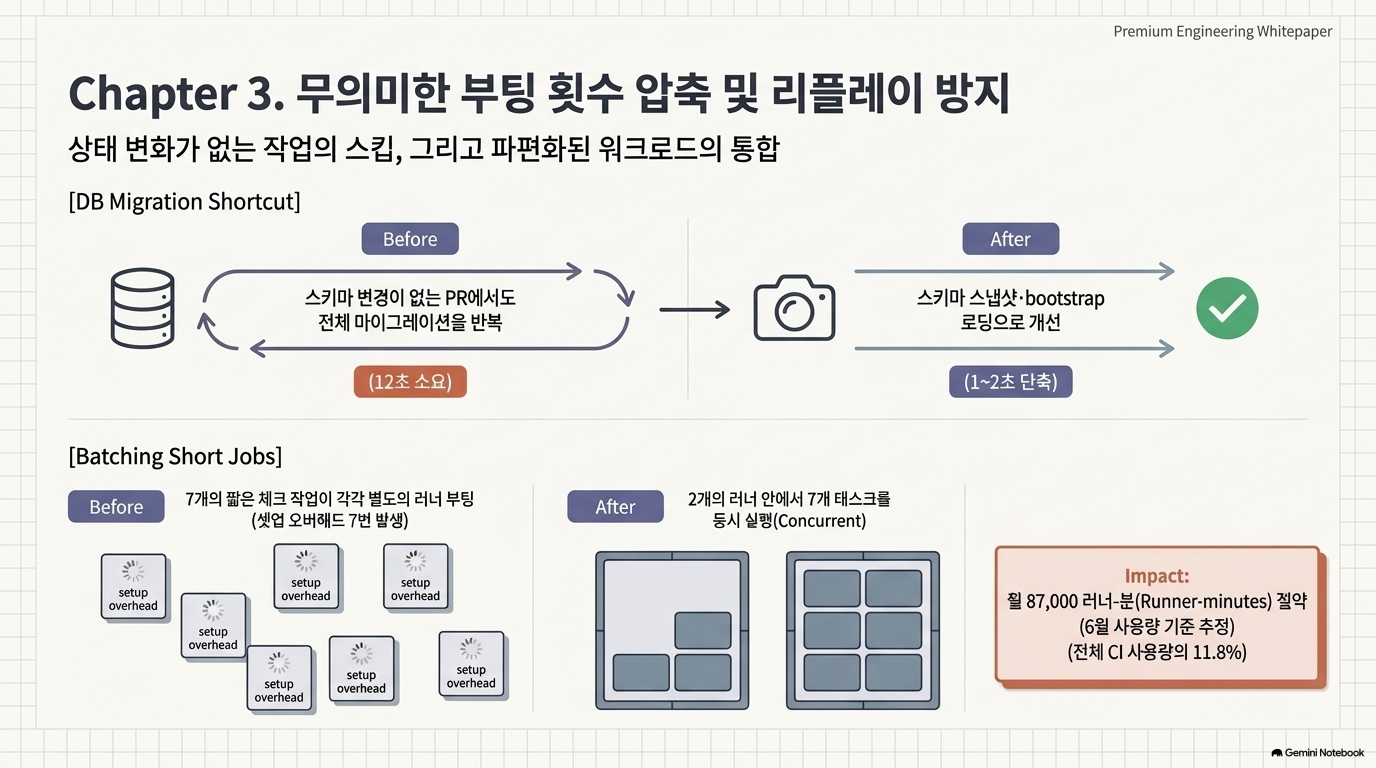
API 컨테이너가 매번 전체 DB 마이그레이션 이력을 재생하던 방식을, 스키마가 바뀌지 않은 경우 생성된 스키마 스냅샷과 bootstrap 파일을 읽는 방식으로 바꿨습니다. 컨테이너당 DB 설정이 약 12초에서 1~2초가 됐습니다.[1]
짧은 검사들은 묶되, 내부 병렬성은 유지하기
독립 검사 7개가 각각 runner를 켜고 checkout·의존성 설치를 한 뒤 몇 초만 일하고 있었습니다. 이를 2개 job으로 통합하고, 그 안에서 7개 작업을 병렬 실행했습니다. 원문은 6월 사용량을 기준으로 월 약 87,000 runner-minute, 전체 CI 사용량의 11.8%에 해당하는 절감 효과를 제시합니다.[1]
해석: “job을 잘게 나누면 항상 빠르다”가 아닙니다. 각 job의 유효 작업시간보다 기동·설정 시간이 크다면, 독립성을 유지하면서도 실행 단위를 묶는 편이 유리합니다.
5. 테스트 실행 효율: 샤드 수보다 부하 균형과 격리가 중요
5-1. 테스트 러너의 실제 분배 단위에 맞춰 파일 구성
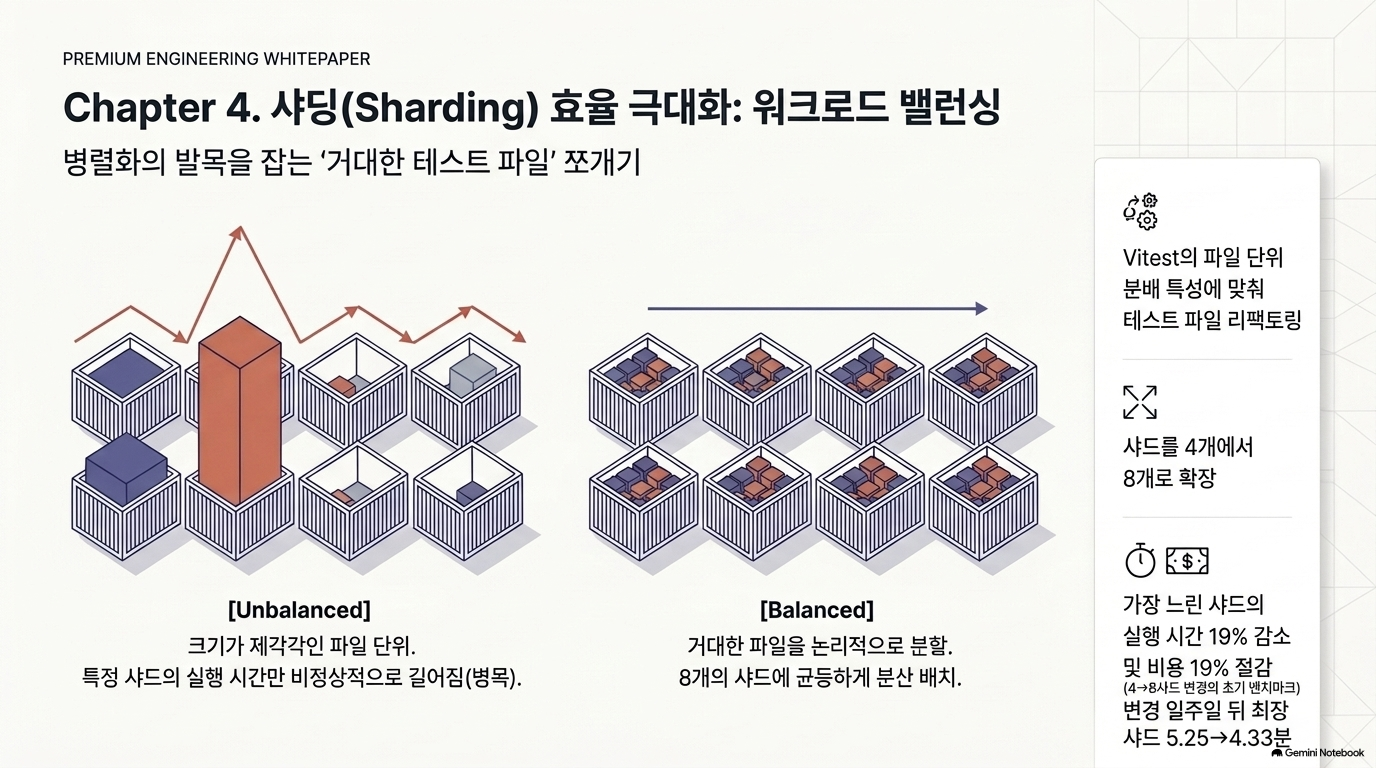
Vitest는 개별 테스트의 소요시간이 아니라 파일 단위로 작업을 분배합니다. 큰 테스트 파일 몇 개가 특정 샤드에 몰리면 다른 샤드가 먼저 끝나도 전체 완료는 가장 느린 샤드를 기다립니다. Linear는 큰 파일을 더 작고 목적이 분명한 파일로 나눈 뒤 샤드·runner 구성을 재평가했습니다.[1]
기존에 3개에서 4개로 늘렸던 샤드를 8개로 확장한 초기 벤치마크에서는 핵심 job이 약 19% 빨라지고 19% 저렴해졌습니다. 변경 일주일 뒤 가장 느린 샤드는 5.25분에서 4.33분으로 줄었습니다. 이는 해당 구성·시점의 관측치이지, 샤드를 두 배로 하면 언제나 비용도 줄어든다는 일반 법칙은 아닙니다.[1]
5-2. 안전한 테스트에 한해 모듈 상태 공유
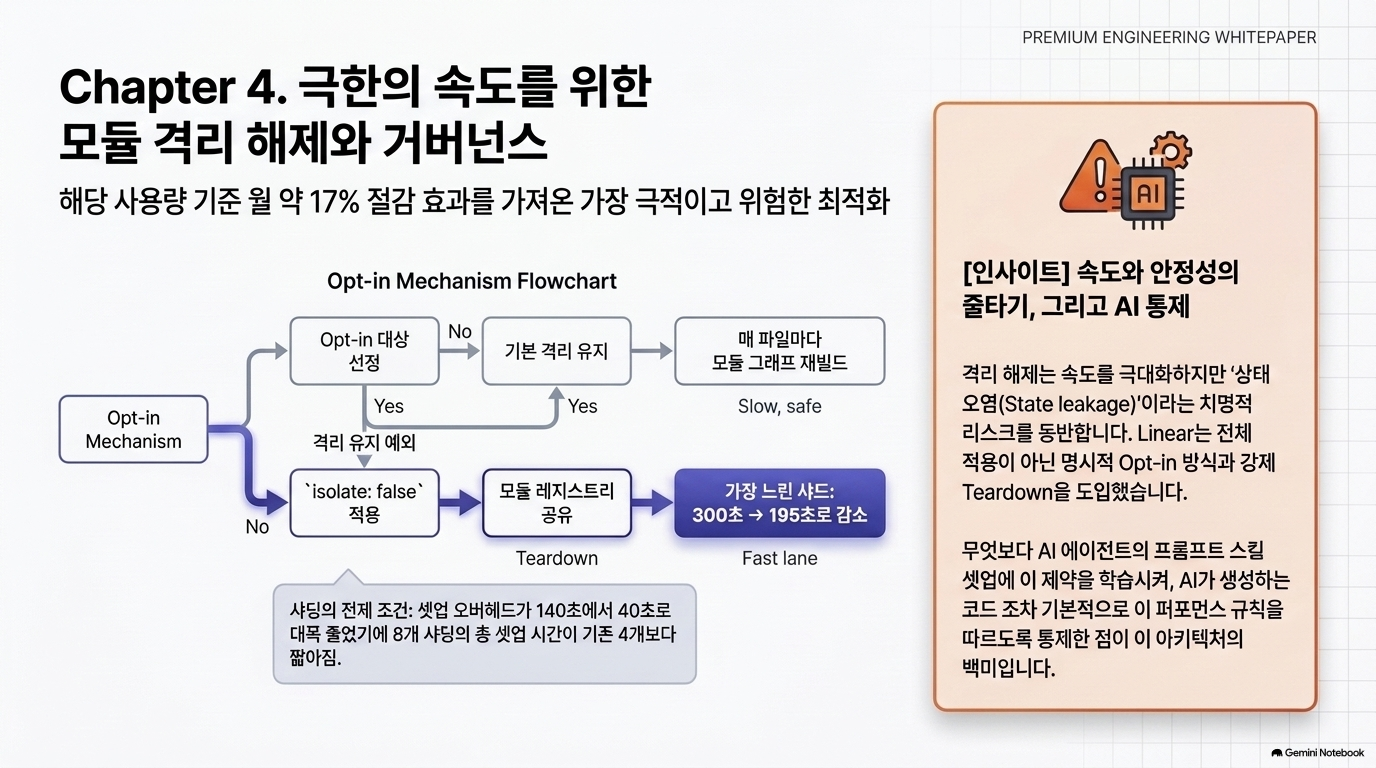
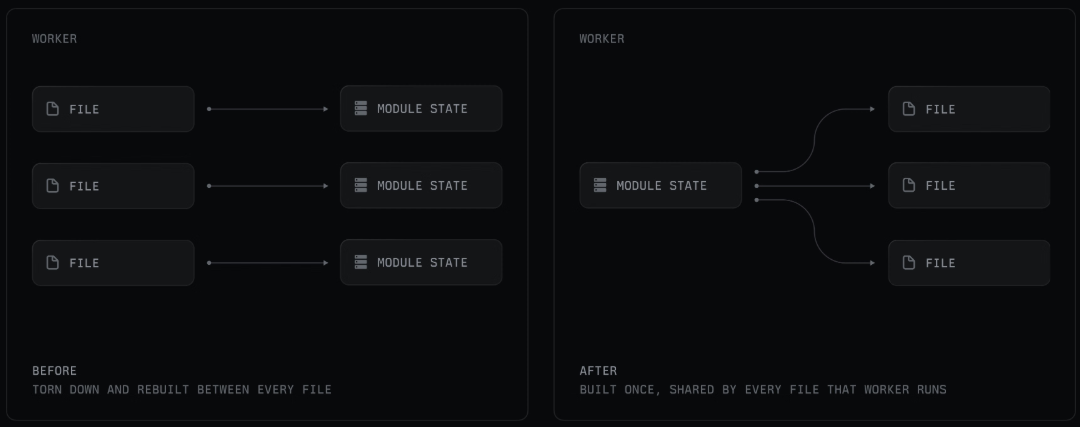
Vitest의 기본 파일별 격리 때문에 각 샤드가 entity·GraphQL·decorator 그래프를 반복 구성했습니다. Linear는 안전하다고 확인한 파일만 isolate: false 프로젝트에 명시적으로 opt-in시켜 worker 안의 모듈 레지스트리를 공유했습니다. 그 결과 가장 느린 샤드는 약 300~379초에서 195초, 실행당 API 샤드의 총 runner 시간은 약 32.8분에서 22분으로 줄었습니다. 글은 이를 단일 변경 중 가장 큰 성능 개선이자, 해당 사용량 기준 월 약 17% 절감 효과로 제시합니다.[1]
반면 저자는 이를 정확성 위험이 가장 큰 변경이라고 명시합니다. 파일별 opt-in 주석, 공유 상태 teardown을 요구했고, fake timer나 상태 공유를 안전하게 정리하기 어려운 파일은 기존 격리를 유지했습니다. 에이전트가 테스트의 다수를 작성하는 환경이어서, 생성 테스트에도 같은 제약이 반영되도록 에이전트용 지침을 수정했습니다.[1]
해석: 격리 해제는 단순한 성능 플래그가 아니라 테스트 간 상태 오염 가능성을 관리해야 하는 품질 정책 변경입니다. AI가 작성한 테스트까지 이 정책을 따르도록 한 점이 특히 실무적입니다.
5-3. 샤딩의 경제성은 설정 고정비에 달려 있다
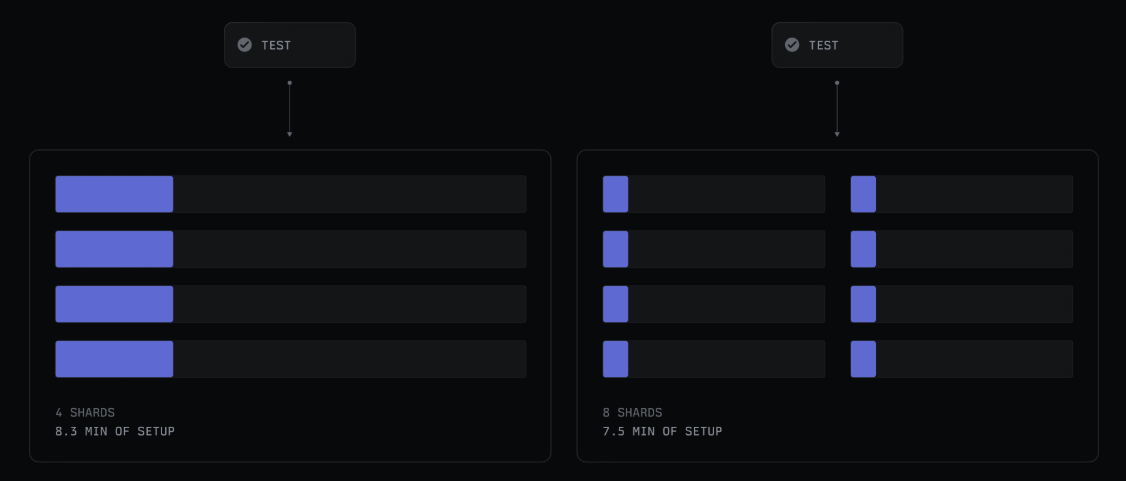
샤드를 늘리면 병렬 실행은 좋아지지만, 각 샤드의 설정비도 반복됩니다. 원문에 따르면 과거 설정비 110~140초/샤드인 상태에서 8개를 운용했다면 설정에만 15~19 runner-minute이 들었을 것입니다. 이후 설정비가 약 40초 수준으로 내려가면서 8개 샤드가 실용적이 됐습니다. 그림 설명상 설정 총시간은 개선 전 4개 샤드 8.3분, 개선 후 8개 샤드 7.5분입니다.[1]
즉 최적화 순서는 설정 고정비 감소 → 테스트 파일 부하 균형 → 샤드 확대였습니다. 순서를 거꾸로 하면 PR 대기시간을 줄이는 대신 비용을 과도하게 늘릴 수 있습니다.
6. 결론과 실무 적용 포인트
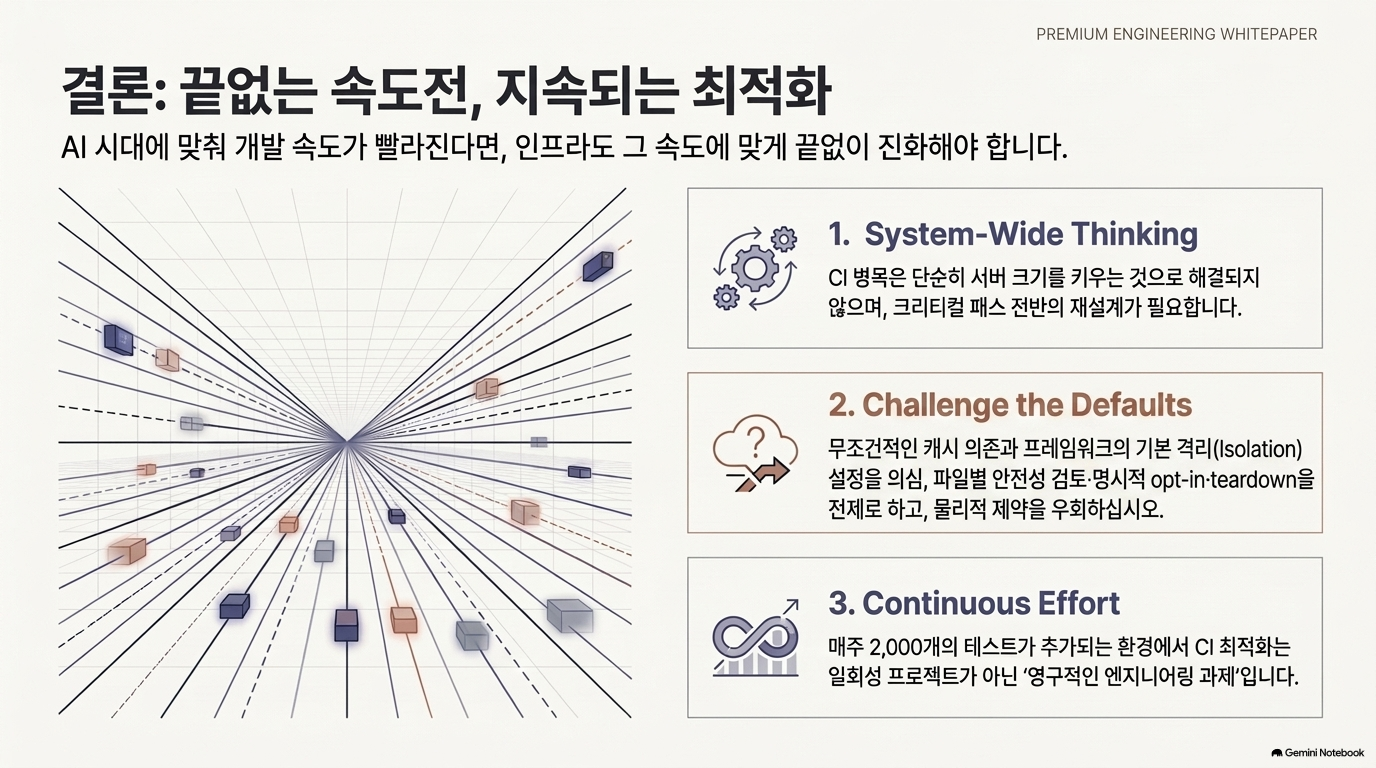
Linear는 별도 개선 작업이 없었다면 현재 규모의 테스트 스위트가 약 11분 걸렸을 것으로 추정합니다. 실제 대기시간은 5분대이며, 테스트는 현재도 주당 약 2,000개씩 추가되고 있다고 합니다. 이 11분은 실측 결과가 아닌 저자의 반사실적 추정으로 구분해야 합니다.[1]
이 사례에서 가져갈 실무 원칙은 다음과 같습니다.
- 완료시간과 사용량을 동시에 계측: PR 대기시간의 중앙값·p90과 총 runner-minute을 함께 봐야 병렬화의 비용 전가를 발견할 수 있습니다.
- 임계 경로부터 분석: 후속 샤드 전부가 기다리는 변경 감지·checkout·최종 필수 검사는 단독 실행시간이 짧아도 우선순위가 높습니다.
- 고정비를 낮춘 뒤 병렬화: 이미지, 선택적 의존성 설치, 불필요한 캐시 제거, job 통합이 샤드 확대의 전제 조건입니다.
- 성능 개선의 정확성 경계를 명시: 스키마 스냅샷과 테스트 격리 해제처럼 검증 의미가 달라질 수 있는 조치에는 적용 조건·예외·정리 절차가 필요합니다.
- 개선율을 합산하지 않기: runner 교체의 34%, tsgo의 73%, 상태 공유의 월 17%, job 통합의 월 11.8%는 측정 대상·기준선·기간이 다른 수치입니다. 단순 합계는 전체 절감률이 아닙니다.[1]
원문은 Linear의 TypeScript·pnpm·Vitest 기반 사례입니다. 다른 조직에 재현하려면 도구 이름보다 먼저 작업별 선행 관계, runner 기동·설정비, 파일별 테스트 실행시간, 캐시 복원·재생성 시간을 측정하는 것이 적절합니다.
Sources
[1] https://linear.app/now/ci-bottleneck-reworked — Mufeez Amjad, “AI coding has made CI a bottleneck, so we reworked ours to keep up,” Linear, 2026-09-21.