LLM - 업스테이지, Solar Mini 4
https://www.upstage.ai/blog/en/solar-mini-4
2026.9.30
[Solar Mini 4, Built for High-Volume Agent Workloads]
제공된 문서는 Upstage가 대규모 반복 업무를 처리하기 위해 개발한 소형 AI 모델인 Solar Mini 4의 주요 특징과 성능을 소개하는 출시 안내글입니다. 이 문서는 모델의 핵심 장점으로 전체 350억 개의 파라미터 중 토큰당 오직 30억 개의 파라미터만 활성화하는 효율적인 구조를 강조하며, 이를 통해 뛰어난 성능을 유지하면서도 운영 비용을 대폭 절감할 수 있음을 설명합니다. 또한, 실제 업무 자동화와 도구 활용 능력을 입증하는 각종 벤치마크 평가 결과와 함께, 개발자들이 API를 통해 이 모델을 쉽게 도입하고 활용할 수 있는 구체적인 사용법과 합리적인 요금 체계를 안내하고 있습니다.
1. 핵심 결론
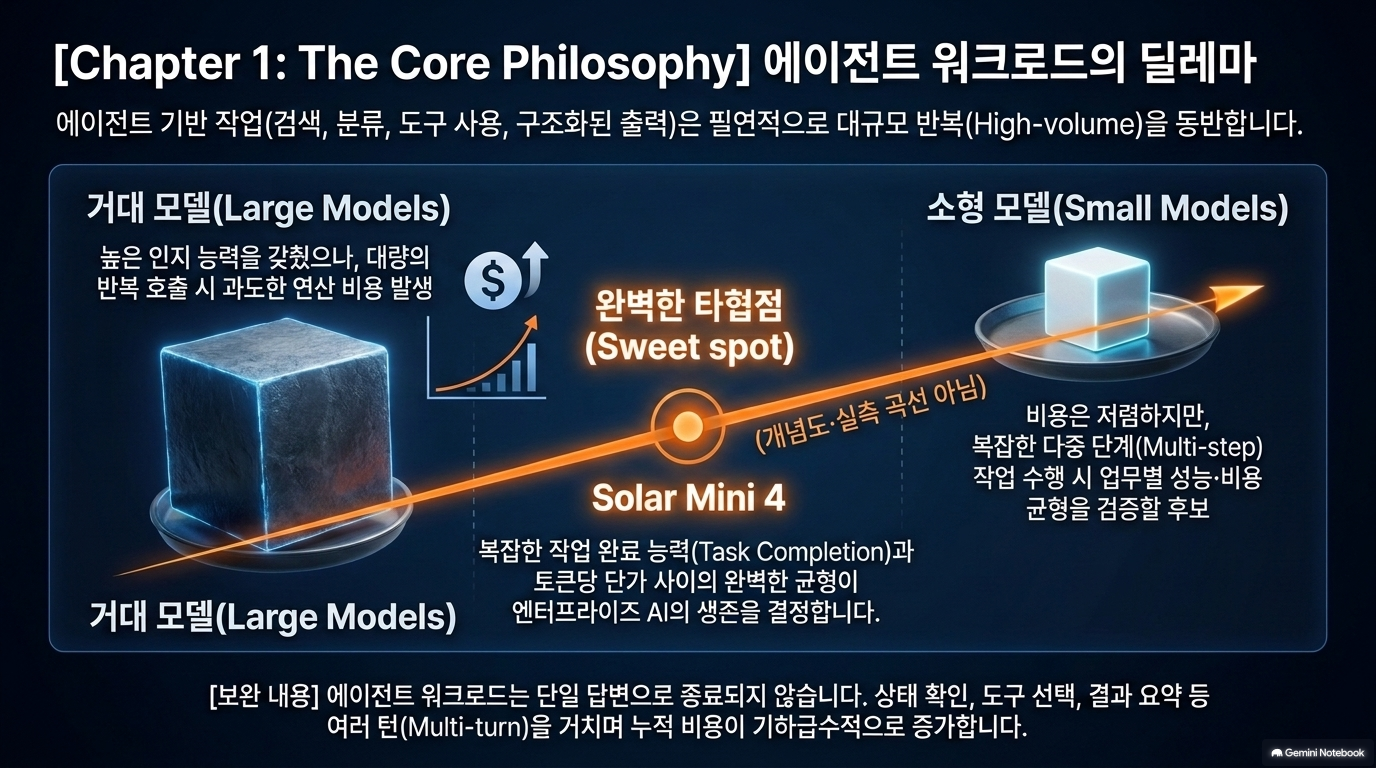
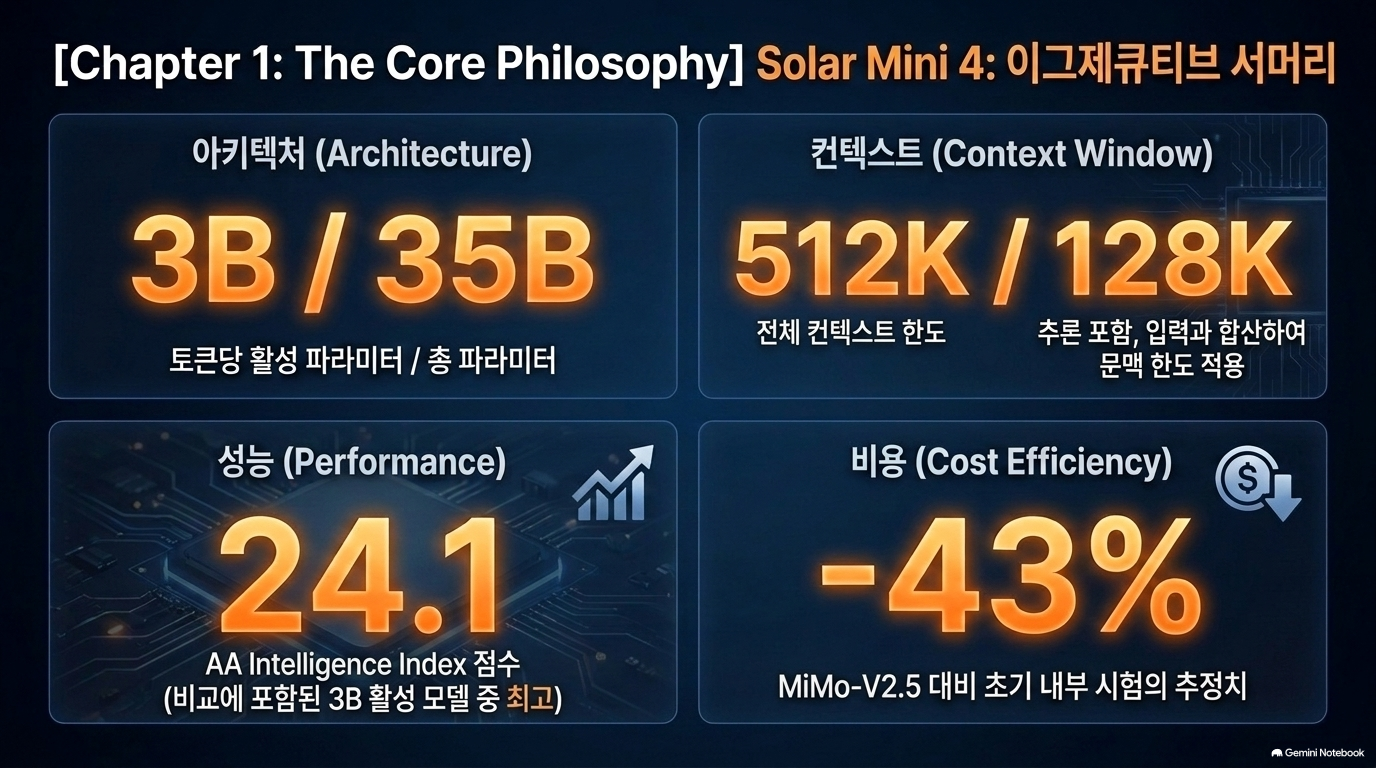
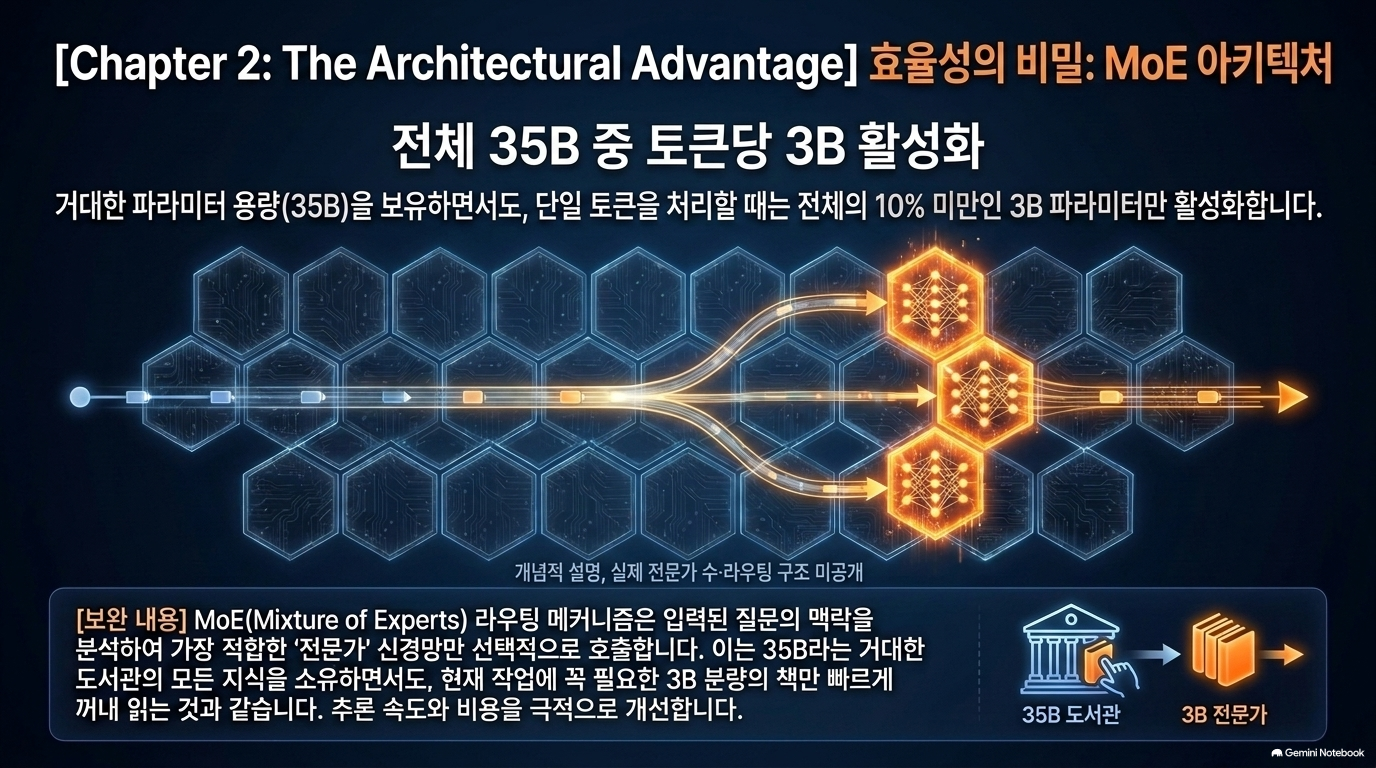
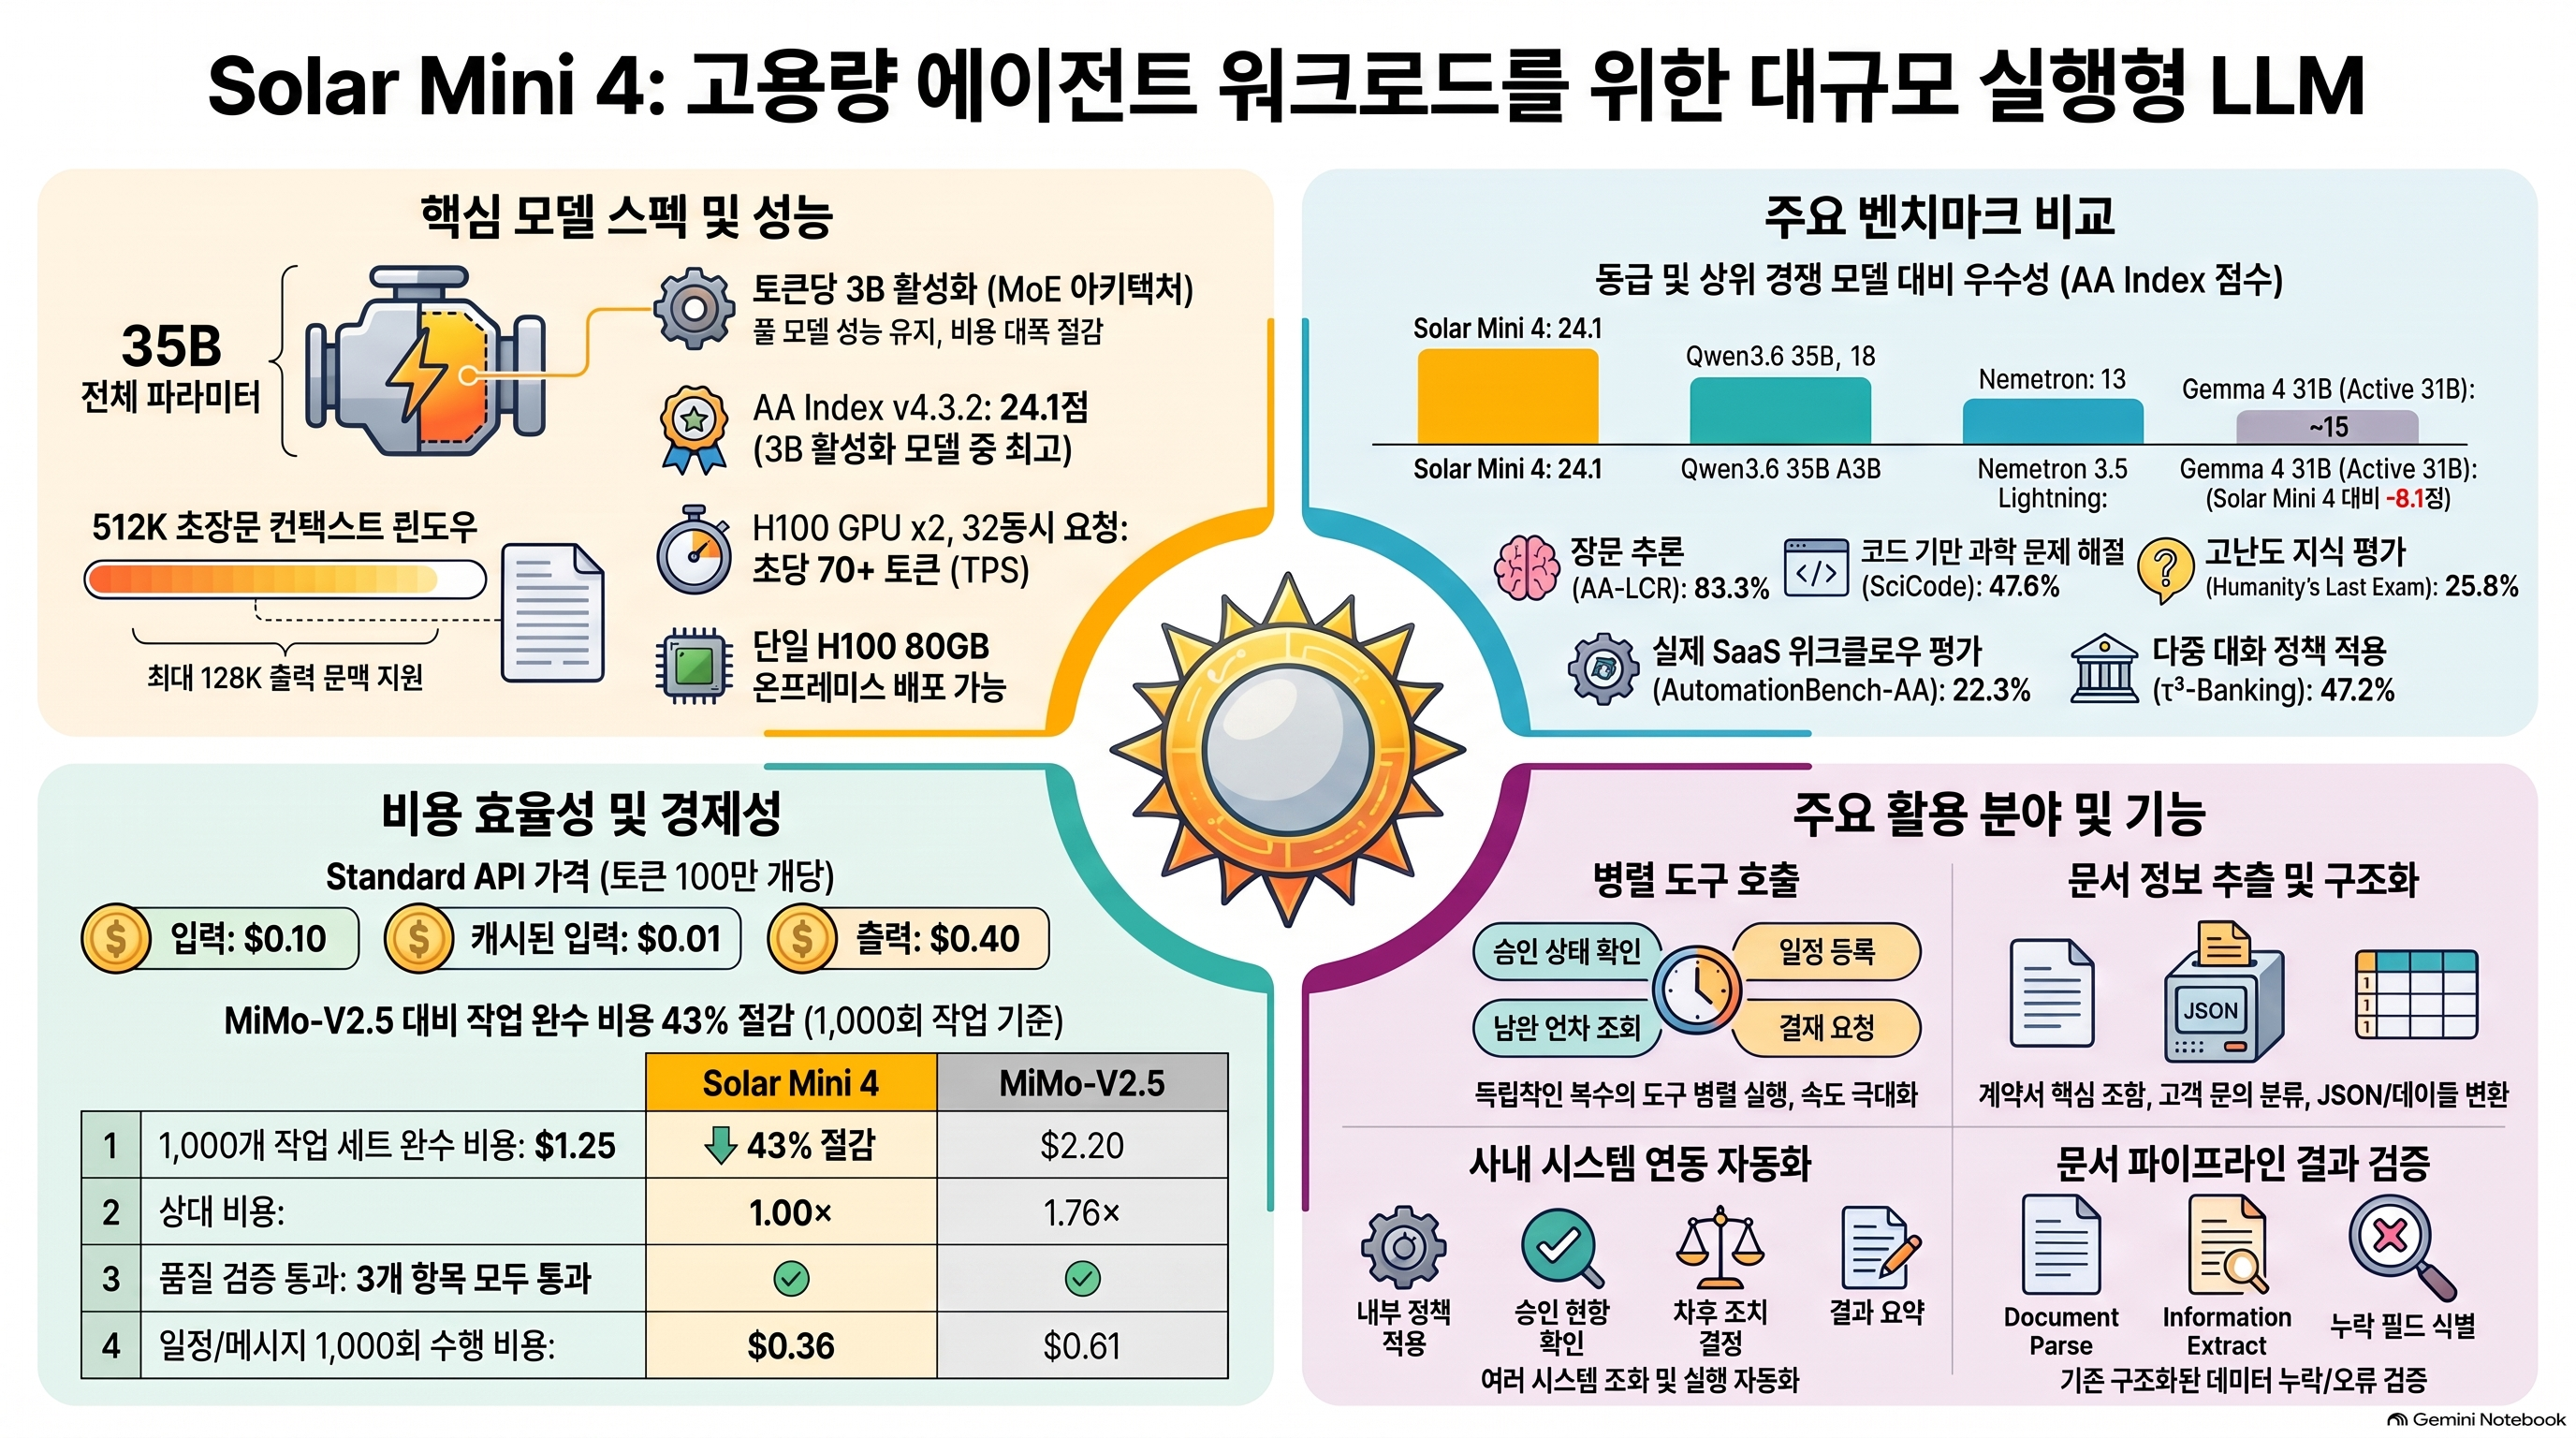
Solar Mini 4는 대량의 텍스트 기반 반복 업무를 저비용으로 처리하도록 설계된 모델입니다. 주요 활용 대상은 정보 추출·분류·구조화 출력·문서 검증·도구 사용이며, 전체 35B 파라미터 중 토큰당 3B를 활성화하는 MoE 구조를 사용한다고 업스테이지가 설명합니다.[1]
그러나 모델 기능과 완성된 에이전트 시스템은 구분해야 합니다. Responses API는 텍스트 생성·추론·구조화 출력·함수 호출 요청을 제공하지만, 대화 상태 관리·실제 도구 실행·권한 검증·승인·업무 완료 확인은 애플리케이션의 책임입니다.[4][6]
통합 판단: 정형·반정형 문서 처리와 제한된 업무 자동화에 검토할 가치가 있는 모델이지만, 실제 도입 적합성은 업무 데이터로 측정한 정확도·완료율·총비용·실행 통제를 통해 판단해야 합니다.
분석 범위와 증거의 성격
이번 정리는 공식 블로그, 모델 문서, Responses API 명세 및 연결 가이드에 근거합니다. 별도 시스템 카드 원문 분석이나 인증된 API 실측 결과는 아닙니다.
| 자료 | 판단에 활용할 수 있는 범위 |
| 공식 블로그 | 제품 방향, 공급자 제시 성능, 내부 시험 조건, 활용 제안 |
| 공식 모델 문서 | 모델 버전·사양·제공 정책 |
| Responses API 명세 | 지원 매개변수, 입력·출력 구조, 제한사항, 오류 처리 |
| 독립 평가 자료 | 별도 평가 환경의 성능·비용 결과 |
| 실제 업무 PoC | 해당 기관·업무에 대한 도입 적합성 |
2. 모델의 기술적 특성과 해석
| 항목 | 공식 설명 | 해석상 주의점 |
| 구조 | MoE, 전체 35B / 활성 3B | 활성 규모와 메모리 요구량은 다름 |
| 컨텍스트 | 최대 512K | 수용량이 전체 문서의 균일한 분석 정확도를 보장하지 않음 |
| 최대 출력 | 128K, API 상한 131,072토큰 | 추론 토큰도 출력 예산에 포함 |
| 기본 추론 | 비활성화 | 복잡한 업무는 추론 설정별 검증 필요 |
| 주요 기능 | 구조화 출력·함수 호출·병렬 호출 | 기능 지원과 업무 성공은 별개 |
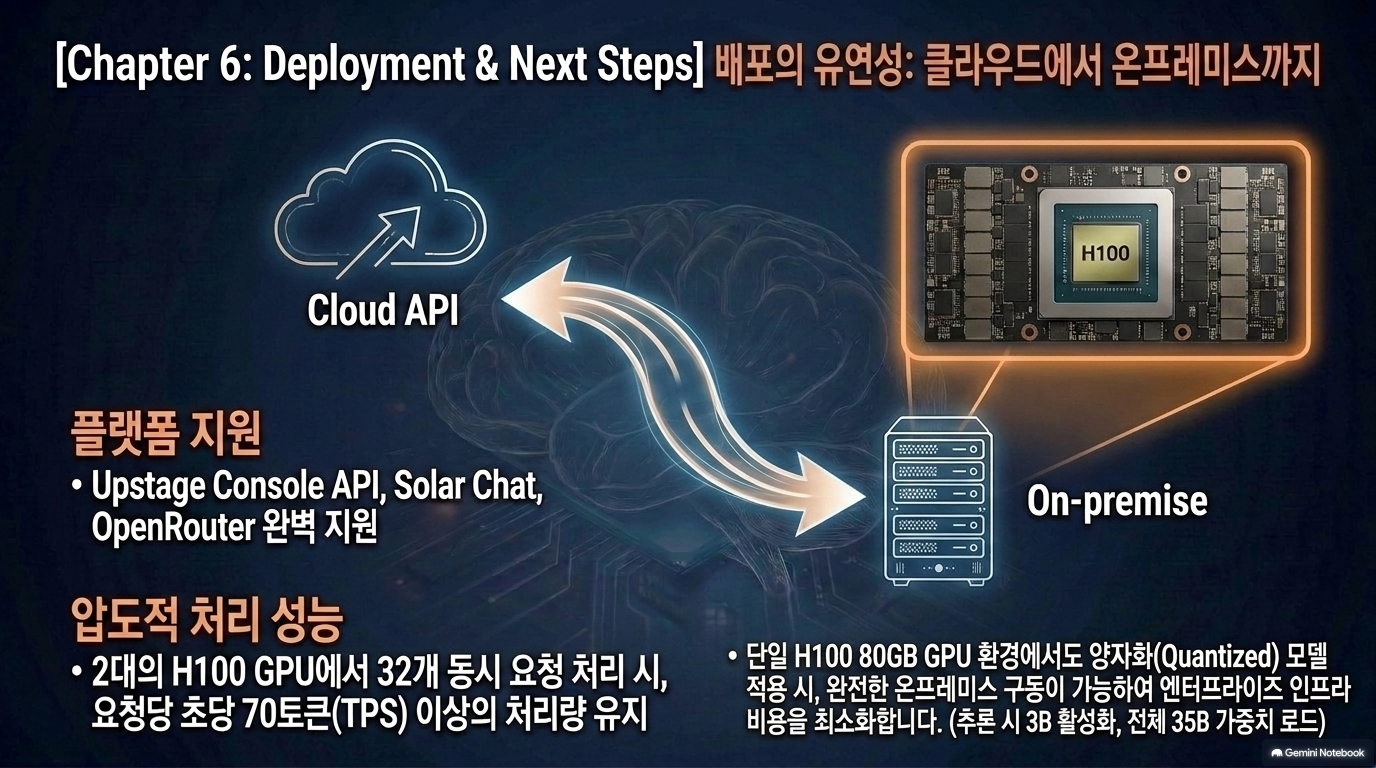
| 온프레미스 | 양자화 모델의 H100 80GB 1대 배포 가능 | 동일 구성의 처리량·동시성·최대 문맥 성능은 별도 검증 |
모델 특성은 공식 블로그, 출력 예산의 세부 조건은 Responses API 기준입니다.[1][4]
핵심 구분은 ‘연산 규모·메모리 규모·업무 효율’입니다. 적은 활성 파라미터는 연산 효율의 근거가 될 수 있지만, 전체 가중치 적재·KV 캐시·문맥 길이·동시 요청을 포함한 운영 자원까지 동일하게 작아진다는 뜻은 아닙니다.
[확인 필요] 이 자료만으로 학습 데이터 구성·권리관계·오염 방지·상세 MoE 구조를 충분히 검토할 수는 없습니다. 비공개 가중치 모델이므로 파라미터 규모의 독립 검증에도 한계가 있습니다.[3]
3. 성능: 강점은 있지만 업무별 편차를 전제로 해야 한다
3.1 공개된 주요 평가
| 평가 | 공식 블로그 결과 | 의미 |
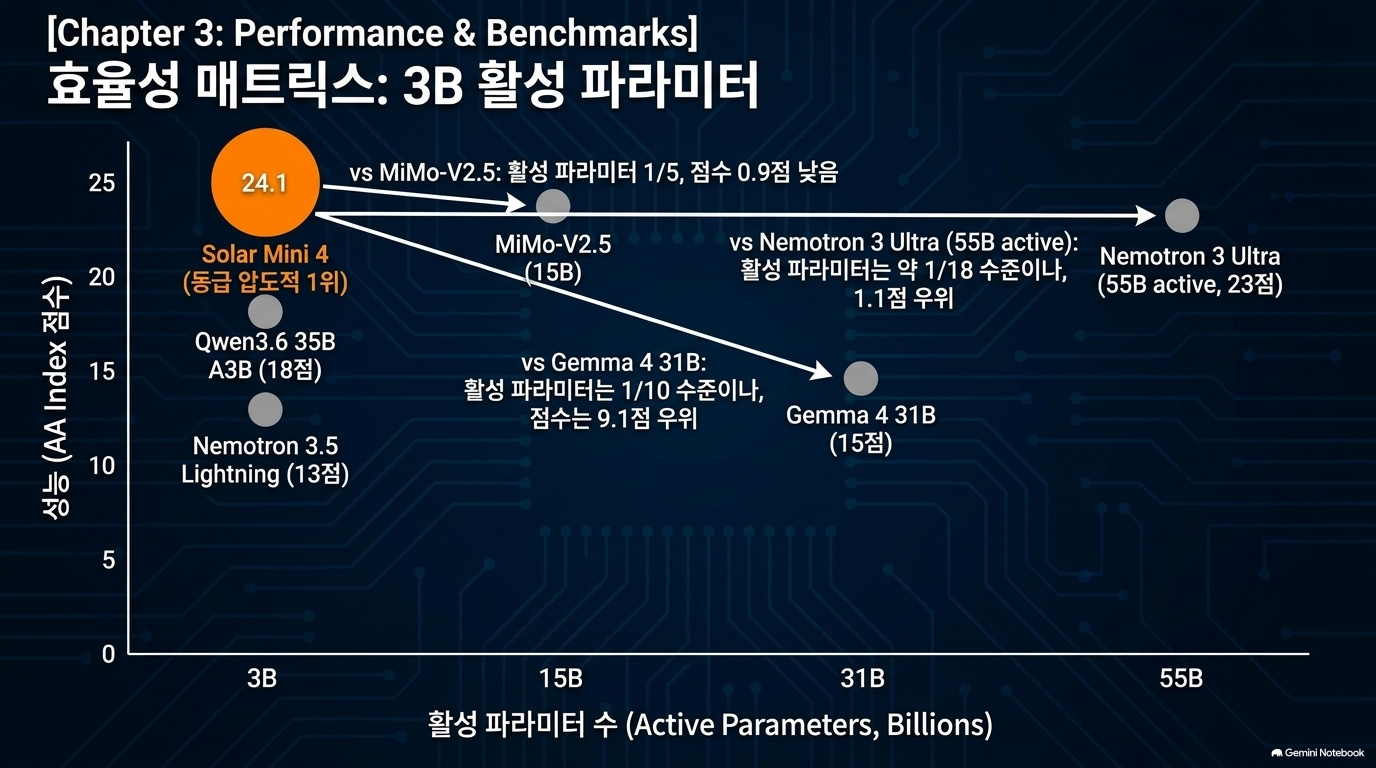
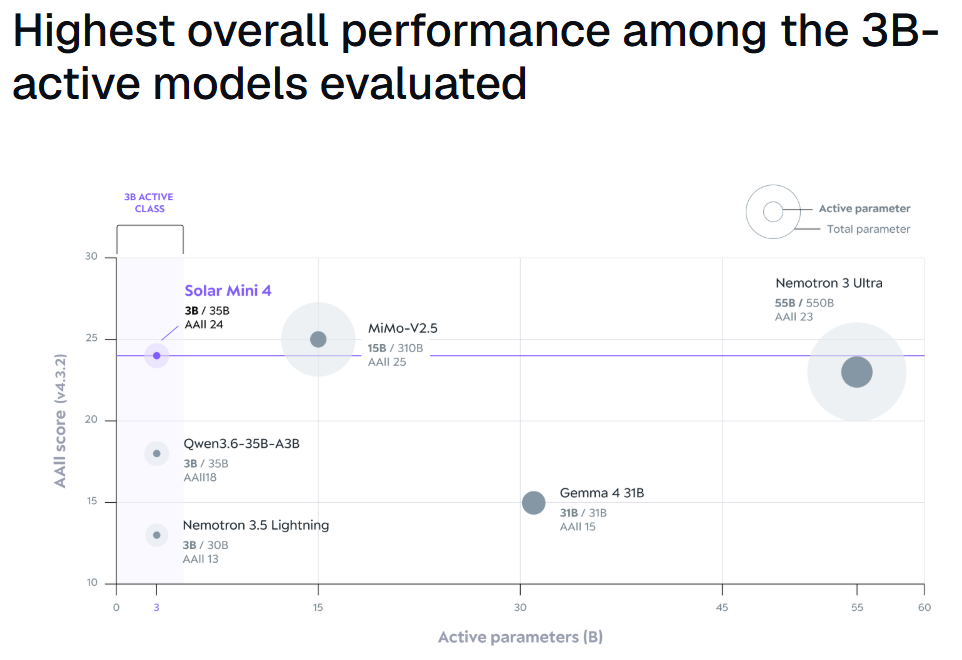
| AA Intelligence Index v4.3.2 | 24.1 | 종합 평가 점수 |
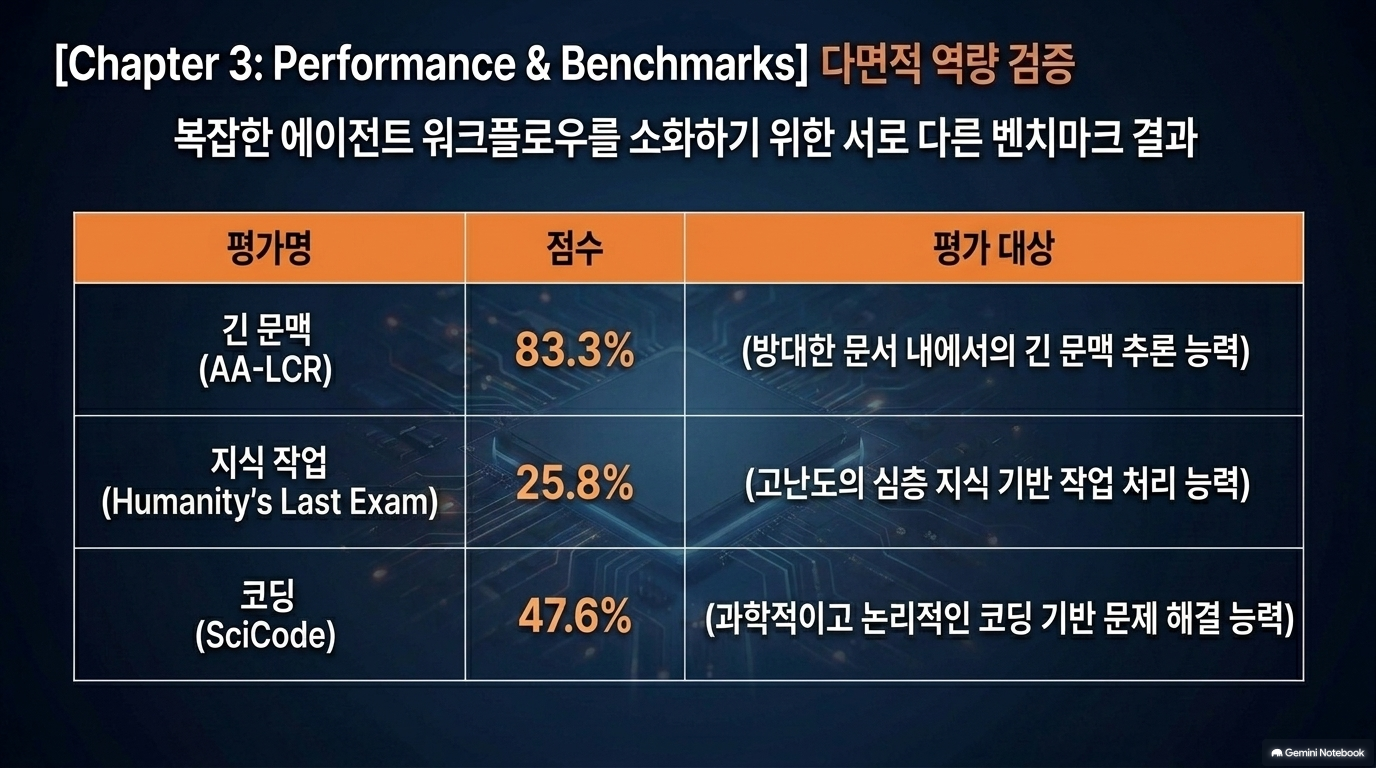
| AA-LCR | 83.3% | 장문맥 추론 평가 |
| SciCode | 47.6% | 과학 문제의 코드 기반 해결 평가 |
| Humanity’s Last Exam | 25.8% | 고난도 지식·추론 평가 |
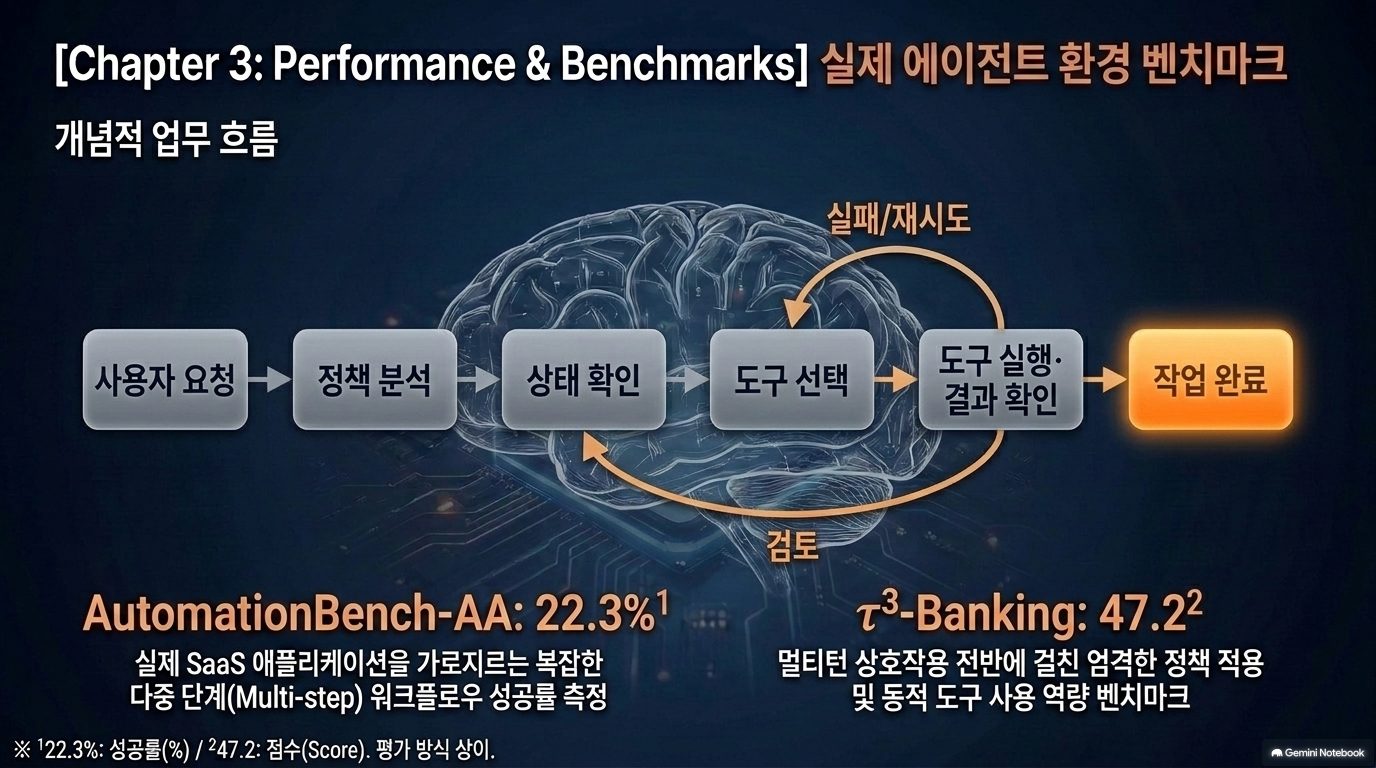
| AutomationBench-AA | 22.3% | SaaS 다단계 에이전트 업무 평가 |
| τ³-Banking | 47.2 | 정책 적용·다중 턴 도구 사용의 별도 평가 |
τ³-Banking에는 원문이 %를 붙이지 않으므로 다른 성공률과 동일 단위로 취급하지 않습니다.[1]
공식 비교의 범위는 “평가에 포함된 3B 활성 파라미터 모델 중 가장 높은 종합 점수”입니다. 모든 모델 중 최고라는 의미는 아닙니다.[1]
3.2 통합 해석
- 장문맥 추론: 문서 기반 업무의 PoC 후보로 삼을 근거가 있습니다.
- 구조화·반복 처리: 성공 기준과 정답 대조가 명확한 업무에서 검증하기 좋습니다.
- 다단계 에이전트: 도구 호출 기능만으로 높은 업무 완료율을 가정하면 안 됩니다.
- 일반 지식·법령 판단: 최신 자료와 근거 검증을 분리해야 합니다.
독립 평가도 장문맥 추론의 상대적 강점과 에이전트 코딩의 약점을 함께 보고했습니다. 이는 ‘종합 점수 하나로 모든 업무의 적합성을 판단하면 안 된다’는 해석을 뒷받침합니다.[3]
[보완 필요: 성능 증거] 실제 도입 평가에서는 모델 버전·추론 수준·토큰 예산·도구 구성·반복 측정 조건을 고정하고, 업무별 오류의 심각도까지 기록해야 합니다.
4. 경제성: 토큰 단가보다 성공 업무당 총비용
4.1 공식 단가와 시험 결과
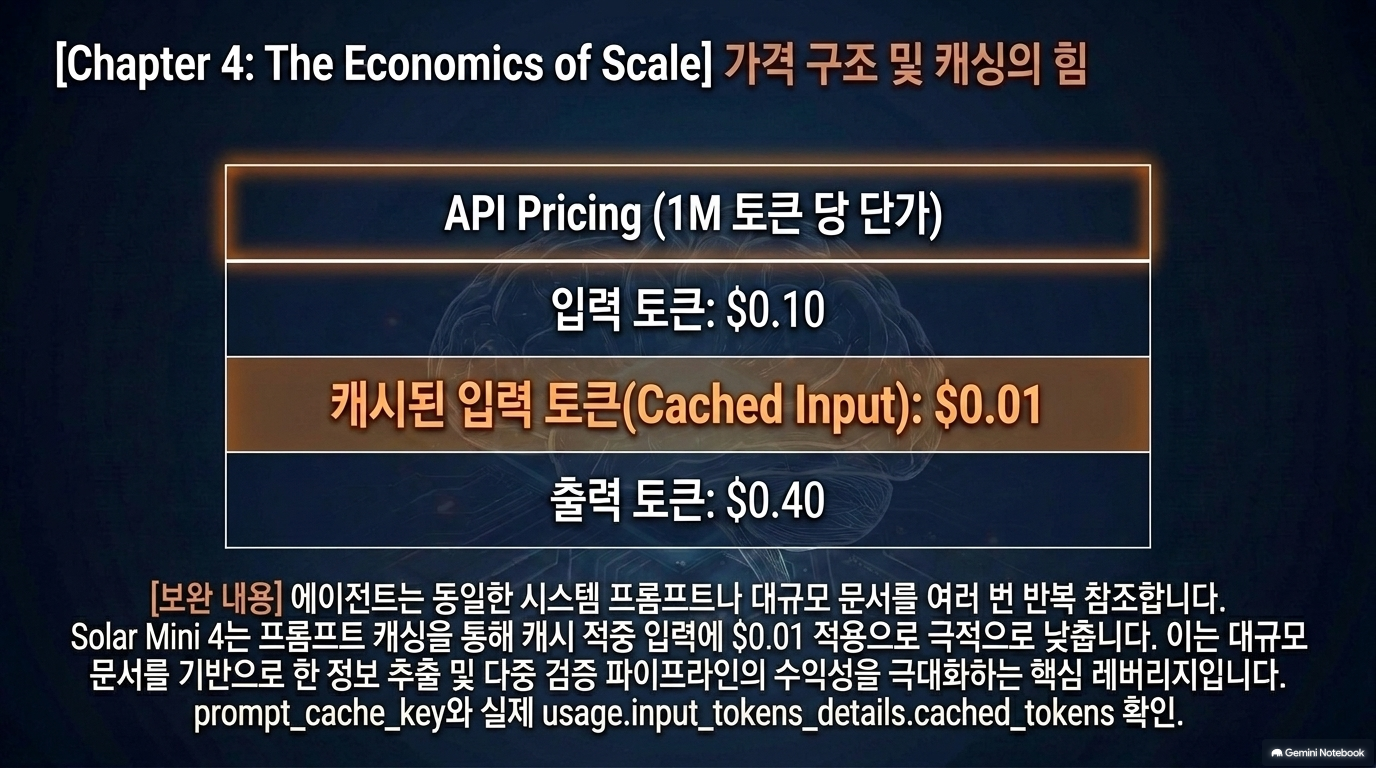
표준 API 가격은 100만 토큰당 입력 $0.10, 캐시 입력 $0.01, 출력 $0.40입니다.[1]
내부 처리량 시험은 H100 2대·동시 요청 32개·입력 4K·출력 1K·프리픽스 캐싱 미사용·600초 초과 부하에서 요청당 70 tokens/s 초과를 보고합니다. 이는 H100 1대 최소 배포 조건과 다른 구성입니다.[1]
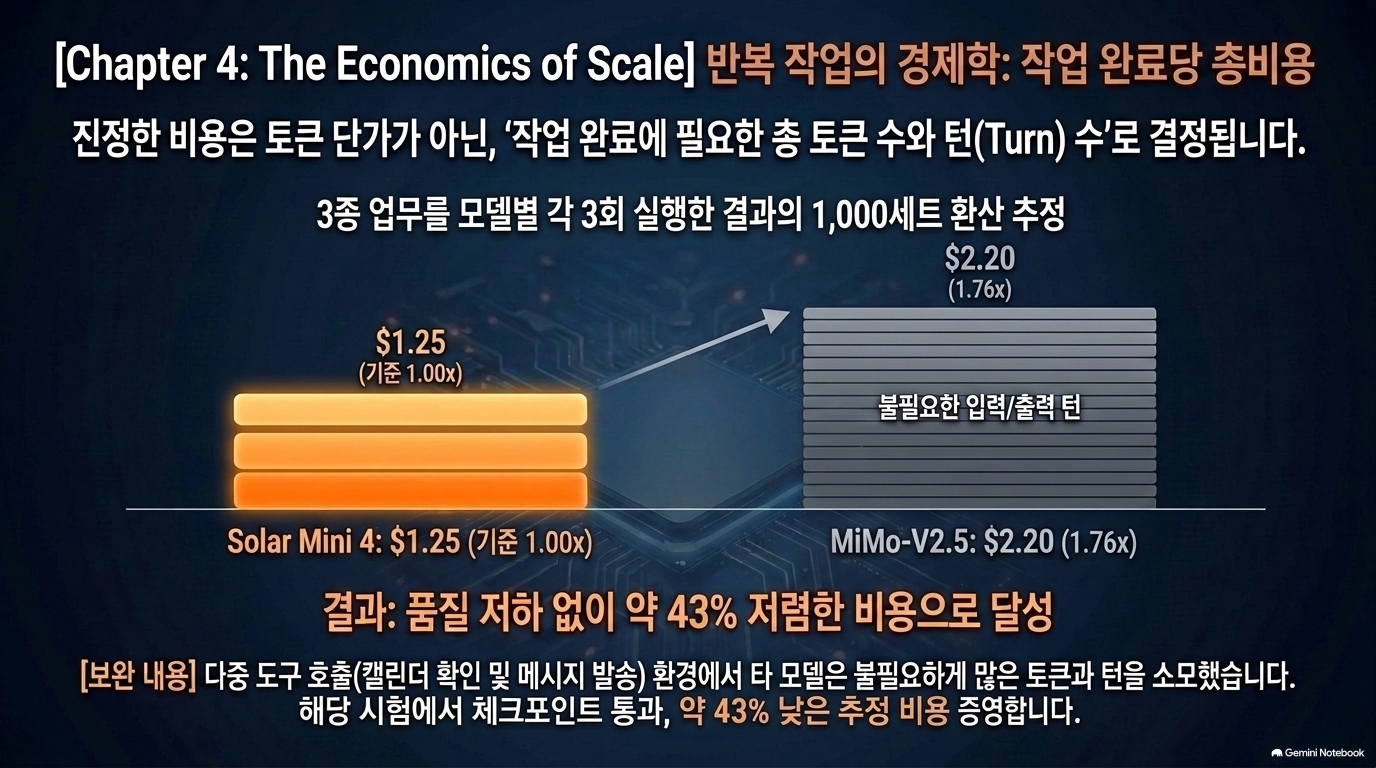
MiMo-V2.5 비용 비교는 한국어 업무 3종을 모델별로 각각 3회 실행한 초기 내부 시험입니다. 두 모델이 품질 체크포인트를 통과했으며, 이를 1,000개 업무 세트로 환산한 비용 추정치는 $1.25와 $2.20입니다. 원문은 Solar Mini 4가 약 43% 저렴하다고 설명합니다.[1]
따라서 ‘1,000세트 실측’ 또는 ‘모든 업무에서 43% 절감’으로 일반화하면 안 됩니다.
4.2 Responses API가 추가하는 비용 변수
API가 상태를 저장하지 않으므로 이전 이력을 재전송해야 합니다. 재전송 이력, 도구 결과, 추론 토큰, 재시도와 캐시 적중 여부가 실제 비용에 영향을 줍니다.[4][5]
독립 평가에서는 많은 출력 토큰과 반복 입력의 캐시 적중률 때문에 저렴한 토큰 단가가 낮은 업무당 비용·짧은 처리시간으로 그대로 이어지지 않는 사례도 보고됐습니다.[3]
권고 평가 기준
성공 업무당 총비용 = 모델·도구/API·재시도·인간 검토·복구 비용의 합계 ÷ 검증된 성공 업무 수
이는 분석적 권고 산식입니다. 블로그의 비용 시험이 모든 항목을 포함했다는 뜻은 아닙니다.
[확인 필요] 프로모션 기간과 표준 가격 적용일의 블로그 문구가 불명확하므로, 실제 계약·Console 가격을 확인하고 사업성 산정은 표준 단가를 기준으로 하는 것이 적절합니다.[1]
5. Responses API: 구현 시 반드시 반영할 제약
5.1 OpenAI 호환은 완전한 기능 동일성이 아니다
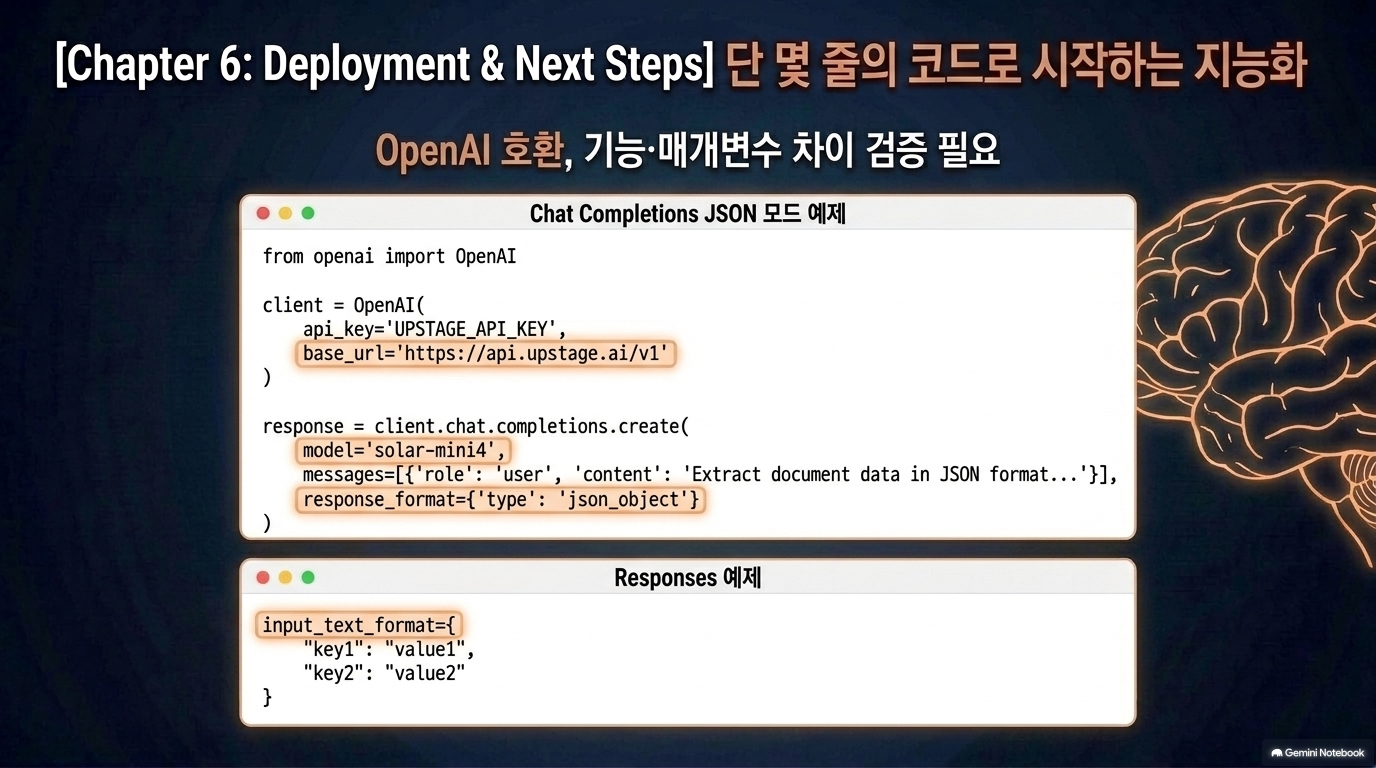
문서는 명시된 매개변수만 처리하며, 일부 다른 OpenAI 매개변수는 수용하지만 무시한다고 설명합니다. text.verbosity, reasoning.summary, presence_penalty는 효과가 없습니다.[4]
반면 다음은 거부됩니다.[4]
- previous_response_id, conversation
- background, store: true
- input_image, input_file
요청이 성공했다는 사실만으로 설정이 적용됐다고 판단하면 안 됩니다.
5.2 상태·지침 관리
- 이전 output 항목과 새로운 입력을 클라이언트가 재전송해야 합니다.
- instructions는 요청 사이에 자동 유지되지 않습니다.
- 이력 축약 시 도구 호출·결과의 대응관계와 미해결 업무 상태를 보존해야 합니다.[4][5]
5.3 텍스트 전용
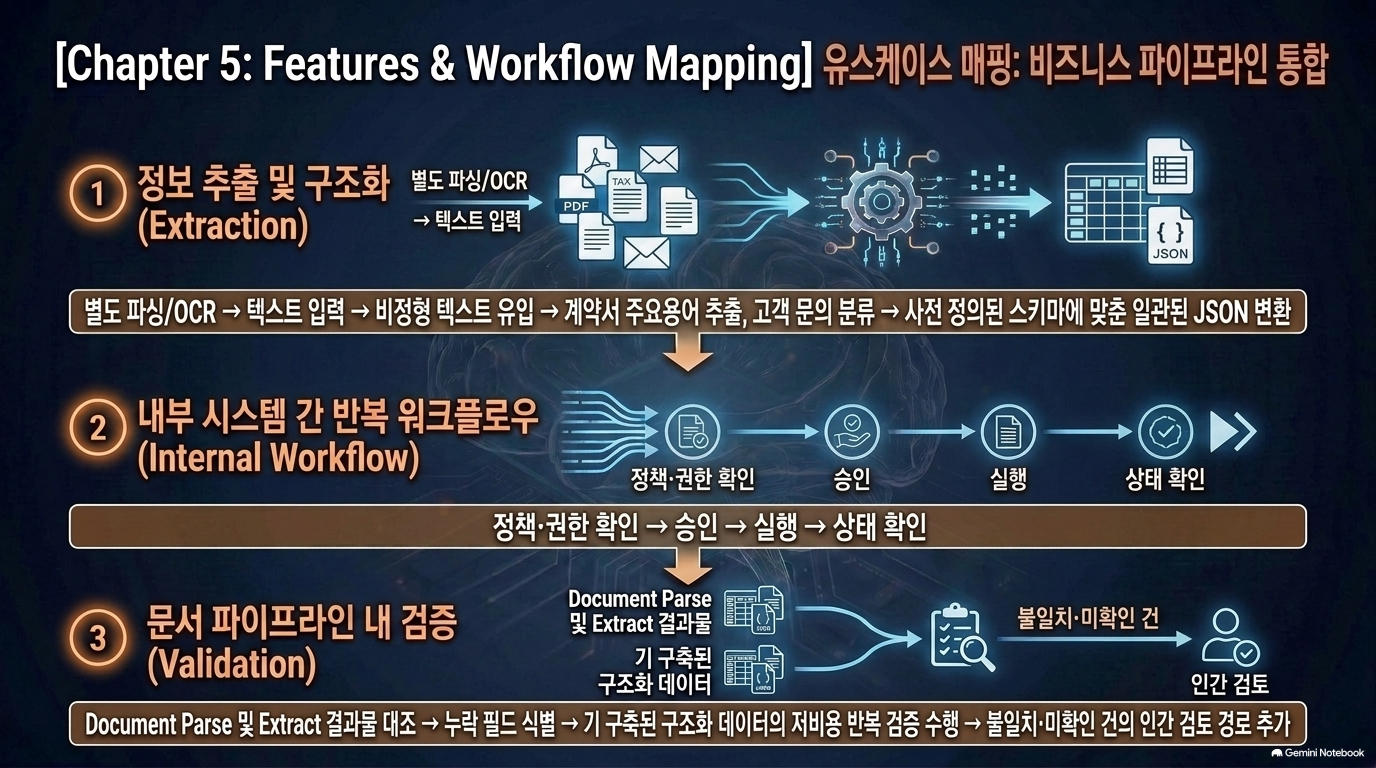
PDF·이미지를 직접 입력하는 인터페이스가 아닙니다. 문서 업무에는 별도 파싱·OCR·추출이 선행되어야 하며, 페이지·표 구조·근거 위치가 보존돼야 합니다.[4]
문서 파싱 오류와 모델 판단 오류를 분리해서 평가해야 합니다.
5.4 구조화 출력
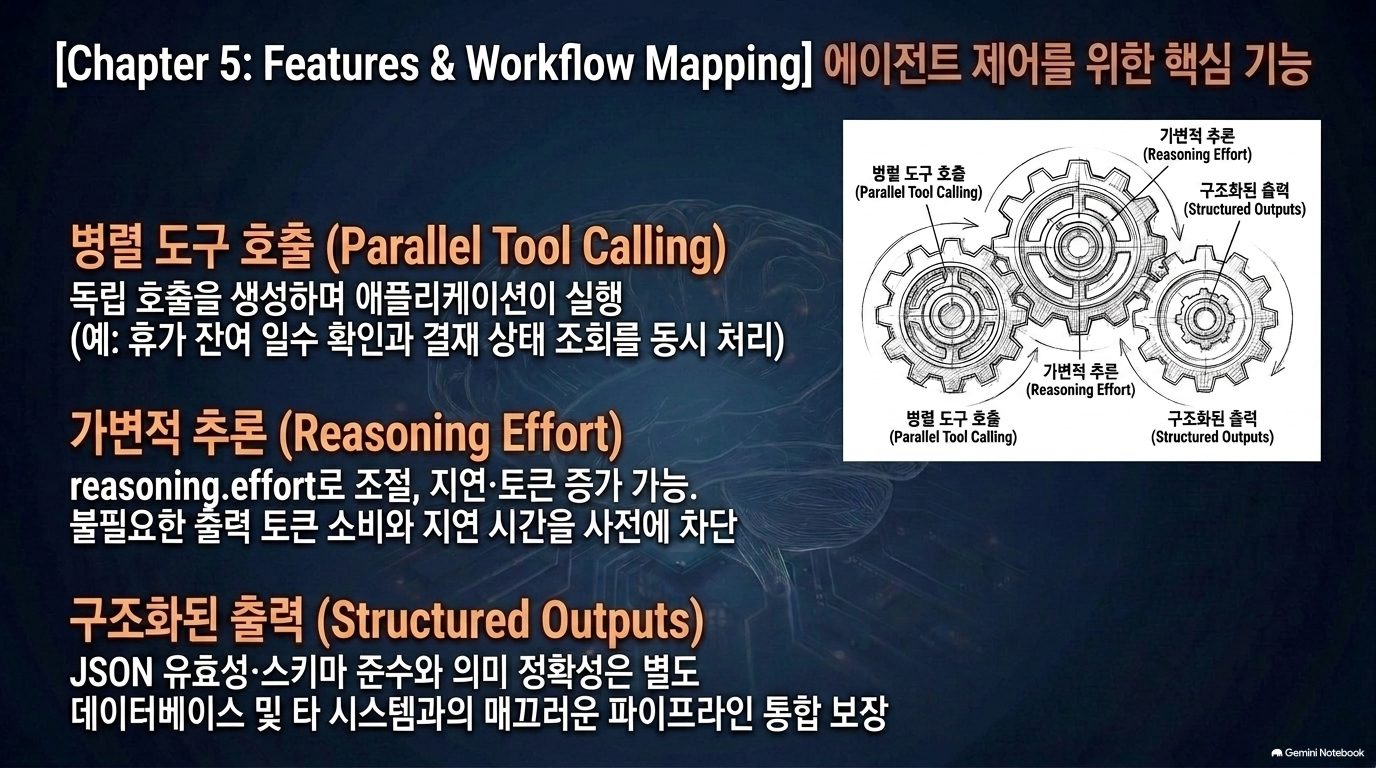
- json_object: 유효한 JSON, 특정 구조는 보장하지 않음
- json_schema: 제공한 스키마에 따른 구조 제약
- Responses에서는 text.format을 사용하며, 스키마 필드는 type 옆에 배치합니다.[4][8]
검증은 JSON 구문 → 스키마 준수 → 원문·업무 규칙에 따른 의미 정확성의 세 단계로 수행해야 합니다.
5.5 도구 호출
함수 도구만 지원합니다. 모델이 호출 요청을 생성하면 애플리케이션이 실행하고, 결과를 function_call_output으로 반환합니다.[4][6]
- required는 호출을 요구할 뿐 올바른 실행을 보장하지 않습니다.
- 병렬 호출 기본값은 true이지만, 실제 병렬 실행은 애플리케이션이 담당합니다.
- 모든 function_call을 처리하고 결과를 call_id에 연결해야 합니다.[4][6]
5.6 추론·완료 상태
Responses의 추론 설정은 reasoning.effort이며, none·minimal은 추론을 끕니다. 출력 상한에는 추론 토큰이 포함되므로 예산이 소진되면 incomplete가 반환될 수 있습니다.[4]
스트림은 [DONE]이 아니라 다음 이벤트로 종료됩니다.[4]
- response.completed
- response.incomplete
- response.failed
응답 완료 ≠ 도구 실행 완료 ≠ 업무 완료입니다.
6. 권고 운영 구조
아래는 자료를 종합한 분석적 권고 구조이며, 공급자가 검증한 종단간 구현을 뜻하지 않습니다.
원문·업무 요청
↓
파싱/OCR·근거 위치 보존·민감정보 처리
↓
결정적 규칙 검증
↓
Solar Mini 4
├─ 추출·분류·구조화
├─ 의미적 불일치 후보 탐지
└─ 도구 호출 요청 생성
↓
스키마·근거·권한·업무 규칙 검증
↓
고위험·불확실 건 → 인간 검토
승인된 실행 건 → 실제 도구 실행
↓
대상 상태 재확인·업무 완료 판정
↓
감사 기록·품질 지표·오류 개선
모델에는 해석·생성·후보 탐지를 맡기고, 시스템에는 권한·승인·결정적 검증·실행 통제를 맡기는 분업이 핵심입니다.
원시 추론 텍스트는 사용자 입력이나 민감한 중간 정보를 포함할 수 있으므로 운영 로그에 기본 저장하지 않도록 공식 가이드가 경고합니다. 감사 증거는 추론 텍스트보다 원문 근거·적용 규칙·승인·실행 결과 중심으로 구성하는 것이 적절합니다.[7]
7. 공공부문·데이터 품질관리 적용
| 업무 | 권고 적용 수준 | 필수 검증 |
| 문서 분류·필드 추출·형식 변환 | 초기 PoC 후보 | 필드 정확도·누락·근거 위치 |
| 문서 간 모순·산출물 불일치 탐지 | 검토 보조 | 원문 대조·오탐·미탐 |
| 규정 기반 조회·후속 안내 | 제한된 자동화 후보 | 규정 버전·예외·권한 |
| 메시지 발송·데이터 변경 | 승인 기반 실행 | 중복 방지·실행 후 상태 확인 |
| 법령 해석·감리 최종 판단 | 전문가 보조 | 최신 1차 자료·전문가 검토 |
데이터 품질관리에서는 다음처럼 역할을 분리하는 것이 적절합니다.
- 규칙 기반 검사: 필수값·타입·코드 유효성·중복·참조 무결성·산식
- 모델 보조 검토: 의미적 불일치·설명 모순·예외 사유 분류
- 전문가 판단: 규정 해석·영향도·조치 우선순위 확정
모델을 기존 검증 규칙의 대체재가 아니라, 규칙으로 포착하기 어려운 의미적 예외를 탐지하는 보조 계층으로 검증하는 접근이 타당합니다.
8. 도입 전 검증 우선순위
| 우선순위 | 검증 항목 | 확보할 증거 |
| 높음 | 업무 정확도·완료율 | 업무별 정답, 근거 검증, 오류 심각도 |
| 높음 | 실행 안전성 | 권한·승인·중복 방지·대상 상태 확인 시험 |
| 높음 | 의미 정확성 | 스키마와 별도의 원문·업무 규칙 대조 |
| 높음 | 상태·지침 관리 | 이력 재전송, 정책 유지, 호출·결과 대응 시험 |
| 높음 | 개인정보·추론 관리 | 데이터 흐름, 로그·캐시·보존·삭제 정책 |
| 높음 | 실패·복구 | 미완료·시간초과·부분 실패별 복구 시험 |
| 중간 | 경제성·처리 성능 | 캐시·추론·재시도 포함 성공 업무당 비용 |
| 중간 | 버전·호환성 | 고정 버전 평가, 별칭 변경 회귀시험 |
| 중간 | 인프라 용량 | 문맥 길이·동시성·양자화별 실측 |
[보완 필요] 공개 자료에 부족한 안전성·학습 데이터·한국어 업무 품질 증거는 공급자 확인 또는 기관 자체 시험으로 보완해야 합니다. 자료의 부재를 해당 통제의 부재로 단정해서는 안 됩니다.
최종 판단
Solar Mini 4의 도입 가치는 활성 파라미터 규모나 벤치마크 순위가 아니라, 필요한 품질을 충족한 업무를 얼마나 안전하고 경제적으로 완료하는가에 있습니다.
따라서 권고 방향은 읽기 중심의 추출·분류·검토 보조부터 시작하고, 실제 품질·비용을 확인한 뒤 승인 기반 실행으로 확대하는 것입니다. 무인 자율 운영이나 고위험 최종 판단은 공개된 기능·성능 자료만으로 정당화하기 어렵습니다.
출처
[1] https://www.upstage.ai/blog/en/solar-mini-4
[2] https://console.upstage.ai/docs/models/solar-mini-4
[3] https://artificialanalysis.ai/articles/korean-ai-lab-upstage-releases-solar-mini-4
[4] https://console.upstage.ai/api/responses
[5] https://console.upstage.ai/docs/capabilities/generate/chat
[6] https://console.upstage.ai/docs/capabilities/generate/tool-calling
[7] https://console.upstage.ai/docs/capabilities/generate/reasoning
[8] https://console.upstage.ai/docs/capabilities/generate/structured-outputs