클라우드 컴퓨팅 - Cloudflare K2:서버리스 이벤트 스트림
https://blog.cloudflare.com/cloudflare-k2-streams/
2026.10.1
[Announcing Cloudflare K2: serverless event streams]
Cloudflare가 출시한 서버리스 이벤트 스트리밍 서비스인 K2는 복잡한 클러스터 관리 없이도 대량의 데이터를 안정적으로 저장하고 처리할 수 있도록 설계되었습니다. 이 서비스는 R2 객체 스토리지를 기반으로 하여 컴퓨팅과 스토리지를 분리하고, 여러 독립적인 소비자가 각자의 속도에 맞춰 안전하게 데이터를 읽어갈 수 있는 환경을 제공합니다. 기존의 복잡한 분산 시스템 운영 부담을 줄이면서도 효율적인 병렬 처리와 장기 데이터 보관을 지원하는 것이 핵심 목적입니다.

K2는 개별 작업을 처리하는 큐보다, 이벤트를 일정 기간 보존하면서 여러 시스템에 독립적으로 전달하는 ‘서버리스 이벤트 로그’에 가깝습니다. 핵심 설계는 R2 객체 스토리지에 내구성을 맡기고, 컴퓨팅과 스토리지를 분리하는 것입니다. 대신 배치 저장에 따른 지연과 애플리케이션의 중복 처리 책임을 받아들여야 합니다.[1][4][5]
두 링크는 별개의 기술 문서가 아니라 Cloudflare의 제품 출시 원문과 이를 정리한 GeekNews 요약·토론입니다. 아래는 원문의 실제 구성인 도입부 → Streams on the edge → Streams, Queues, or Pipelines? → Getting started → Pricing and Availability → What’s next 순서로 분석하고, 공식 문서로 중요한 조건을 보완했습니다.[1][2]
분석 범위: 공개된 제품 설명·API 문서 기반입니다. 성능 수치는 Cloudflare의 설명 또는 커뮤니티의 개별 사례이며, 제가 수행한 부하 테스트 결과는 아닙니다.
1. 도입부 — 생산자와 소비자를 시간·처리량에서 분리한다
원문 내용
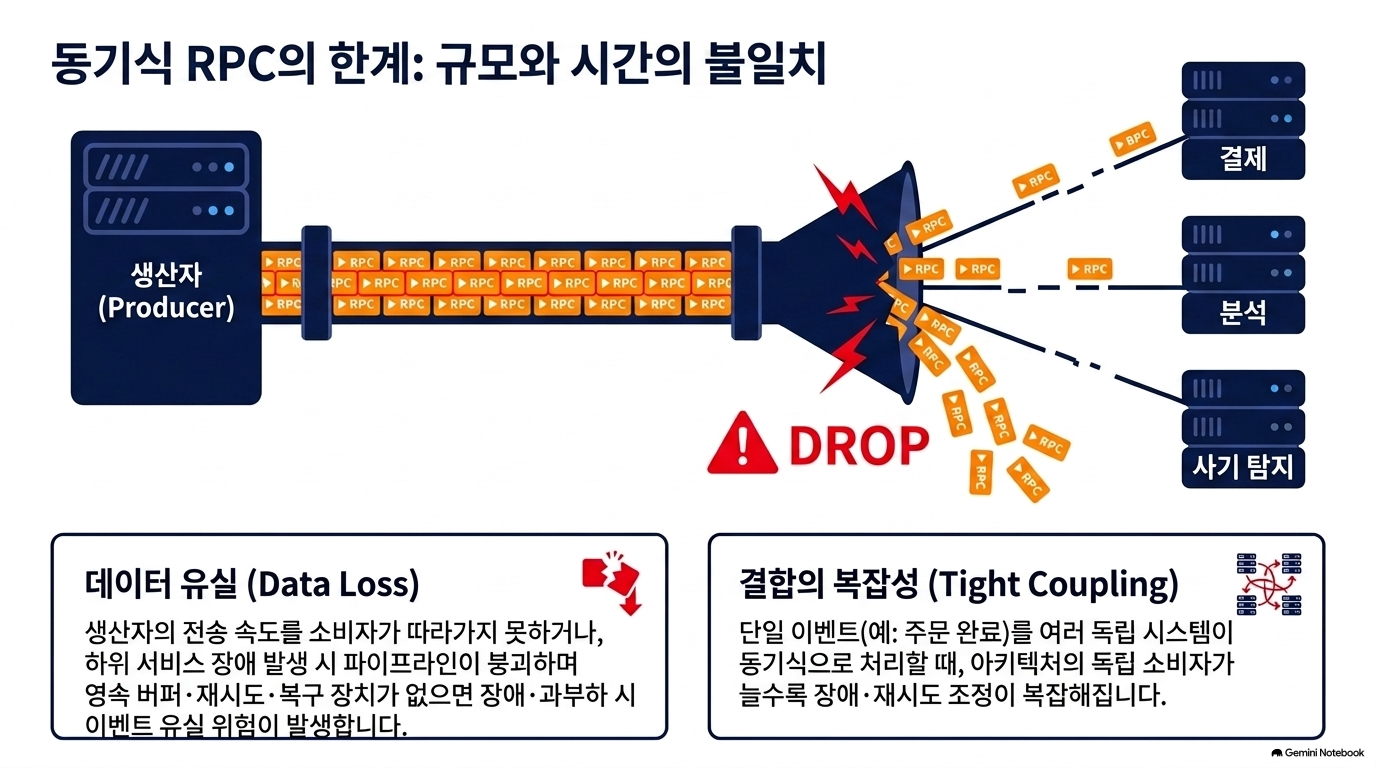
전통적인 RPC 방식에서는 이벤트를 보내는 생산자와 처리하는 소비자가 동일한 시점에 연결되고, 처리량도 맞아야 하는 문제가 있습니다. 소비자가 중단되거나 생산량이 소비 능력을 초과하면 이벤트 처리에 문제가 생깁니다.[1]
원문은 전자상거래의 거래 완료 이벤트를 예로 듭니다. 동일 이벤트를 분석 시스템과 부정거래 탐지 서비스가 각각 처리해야 한다면, 소비자마다 가용성과 처리 능력이 달라 결합 문제가 더 커집니다.[1]
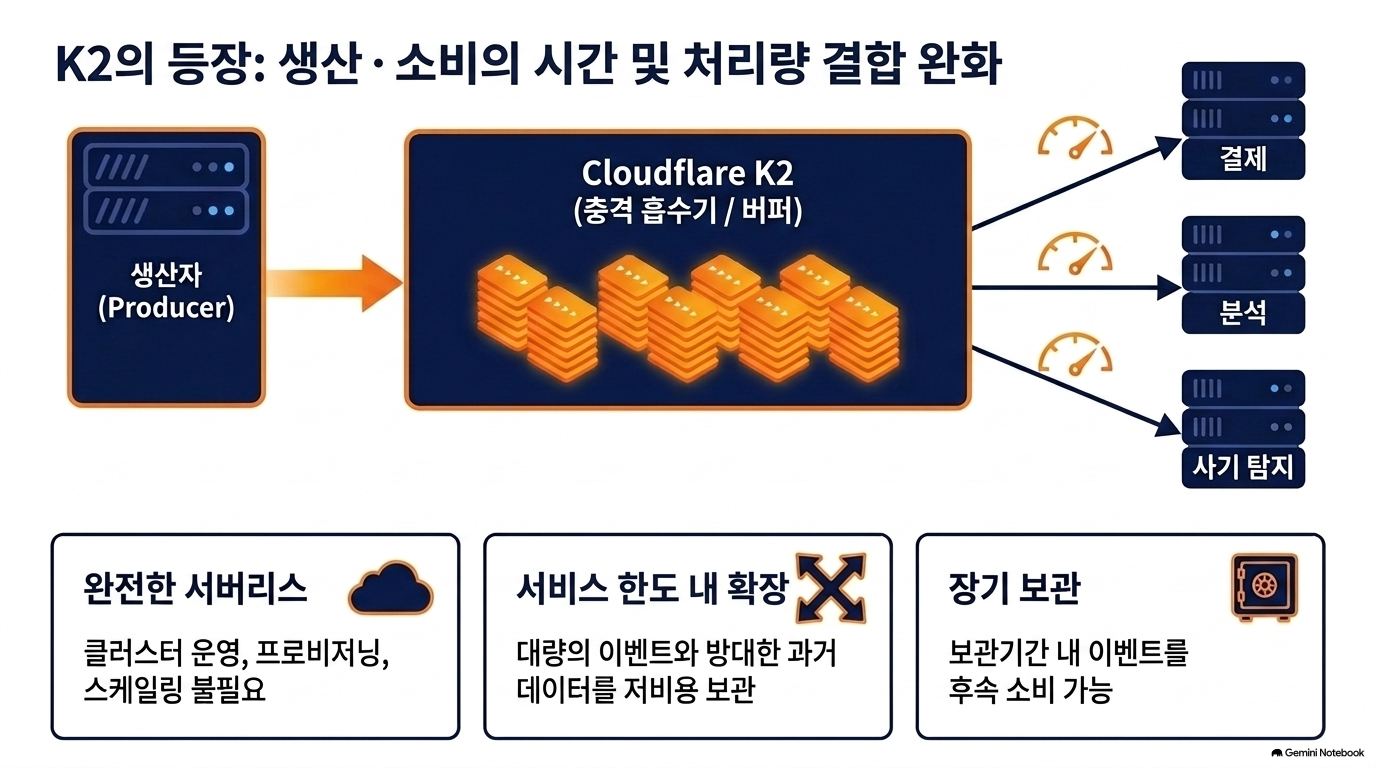
K2는 이 사이에 내구성 있는 로그를 둡니다.
이벤트 생산자
│
▼
K2: 이벤트 저장·보존
├── 분석 시스템: 자신의 속도로 소비
└── 부정거래 탐지: 자신의 속도로 소비
이벤트는 순서형 로그에 저장되고, 여러 소비자가 작업을 나눠 읽거나 각각 전체 이벤트를 읽을 수 있습니다.[1]
기술적 의미
① 시간적 분리
생산 시점과 처리 시점을 분리합니다. 소비자가 잠시 중단되어도, 보관된 이벤트를 이후에 처리하는 구조를 만들 수 있습니다.
② 처리량 분리
이벤트 발생이 순간적으로 증가해도 소비자를 즉시 같은 규모로 확장하지 않고, 로그를 완충 구간으로 활용할 수 있습니다.
③ 업무별 독립성
분석·품질검증·알림 같은 기능이 같은 데이터를 쓰더라도, 소비 진도와 장애 대응을 독립적으로 운영할 수 있습니다.
한계와 해석상 주의점
- “RPC에서는 이벤트가 유실된다”는 표현은 문제를 단순화한 설명입니다. RPC 자체가 필연적으로 유실을 일으키는 것은 아닙니다. 다만 영속 버퍼·재시도·복구 절차가 없다면 장애가 생산자에 직접 전파됩니다.
- “장시간 중단에도 데이터가 사라지지 않는다”는 설명에는 보관기간 조건이 붙습니다. 공식 문서의 기본 보관기간은 7일, 일반 설정 범위는 1시간~30일이며, 더 긴 보관은 별도 요청이 필요합니다.[6][7]
- 따라서 K2를 무기한 원본 보관소나 백업 시스템으로 해석하면 안 됩니다.
실무 시사점: 소비자 장애 허용 시간을 정할 때에는 단순히 “재시작 가능”이 아니라, 장애 시간과 적체 해소 시간을 합쳐 보관기간 내에 복구 가능한지를 검토해야 합니다.
2. Streams on the edge — R2 위에 내구성 있는 로그를 구축한다
이 챕터가 글의 기술적 중심입니다.
2.1 출발점: Pipelines의 수집 버퍼
K2는 처음부터 독립 제품으로만 기획된 것이 아니라, Basin Pipelines의 수집 계층에 필요한 내구성 있는 엣지 버퍼에서 출발했습니다. Pipelines의 처리 엔진은 데이터를 가져오는 풀 방식이므로, 읽기·변환·R2 기록 이전까지 이벤트를 보관할 시스템이 필요했습니다.[1]
분석: K2는 데이터 변환 엔진 자체가 아니라, 변환 엔진 앞에서 데이터를 받아 보존하고 전달하는 기반 계층입니다. GeekNews 토론에 등장하는 “Arroyo 위에 구축된 것인가?”라는 질문도 이 역할 구분을 전제로 읽어야 합니다.[1][2]
2.2 왜 기존 Kafka를 그대로 운영하지 않았는가
원문은 Cloudflare의 인프라가 335개 이상의 도시에 걸쳐 있고, 상태 저장 서비스가 다음 조건에서 운영된다고 설명합니다.[1]
- 머신 자원의 작은 몫을 사용한다.
- 머신이 상대적으로 짧은 수명을 가진다.
- 네트워크 통신이 공용 인터넷을 거치는 경우가 많다.
이러한 환경에서는 전통적인 분산 시스템 소프트웨어를 그대로 운영하기 어려워, 설계를 다시 생각해야 했다는 설명입니다.[1]
분석: 이를 “Kafka가 기술적으로 열등하다”는 주장으로 읽으면 안 됩니다. 원문의 논점은 Cloudflare의 운영 환경과 기존 상태 저장형 시스템의 전제가 잘 맞지 않는다는 것입니다.
2.3 R2가 맡는 역할: 복제·합의·내구성
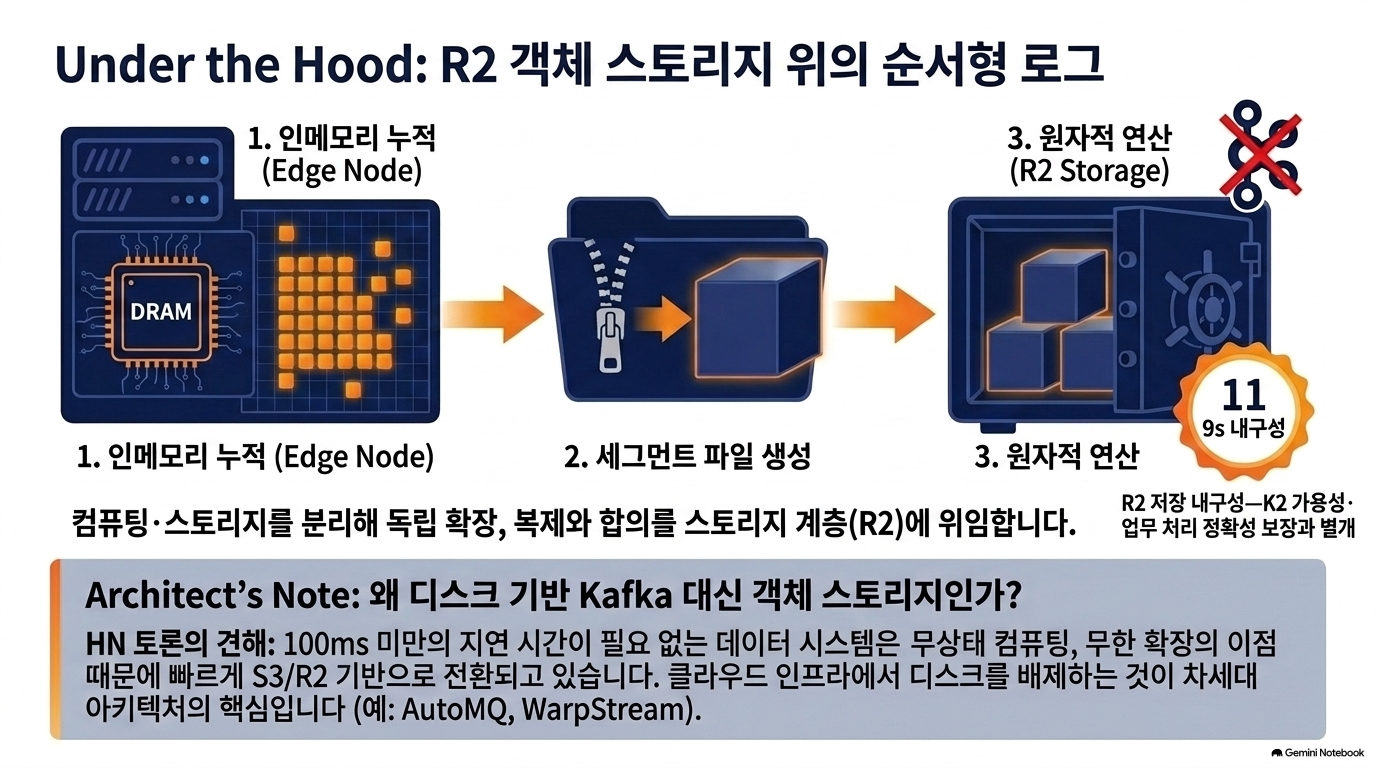
Cloudflare는 R2의 높은 내구성과 강한 일관성 API를 활용해, 복제와 합의의 부담을 스토리지 계층에 맡긴다고 설명합니다. 그 결과 K2의 애플리케이션 계층을 단순화하고 컴퓨팅과 스토리지를 독립적으로 확장할 수 있다는 주장입니다.[1]
| 설계 요소 | 원문의 설명 | 분석 |
| 내구성 | R2의 ‘11개의 9’ 내구성 활용 | 스토리지 내구성 설명이지 K2 전체 가용성 SLA는 아님 |
| 일관성 | 강한 일관성 API 활용 | 로그 구성에 필요한 기반이지만 소비 처리 순서와는 별개 |
| 복제·합의 | 스토리지 계층에 위임 | 복잡성을 제거하기보다 하위 계층으로 이전 |
| 컴퓨팅·스토리지 분리 | 각각 독립적으로 확장 | 소비 처리 능력과 보관 용량의 결합을 완화 |
중요한 구분:
스토리지의 내구성 ≠ 서비스 가용성 ≠ 업무 처리 정확성입니다. 이벤트가 안전하게 저장되더라도 중복 처리, 잘못된 업무 데이터, 소비자 오류까지 해결되는 것은 아닙니다.
2.4 객체 스토리지는 append를 지원하지 않는다
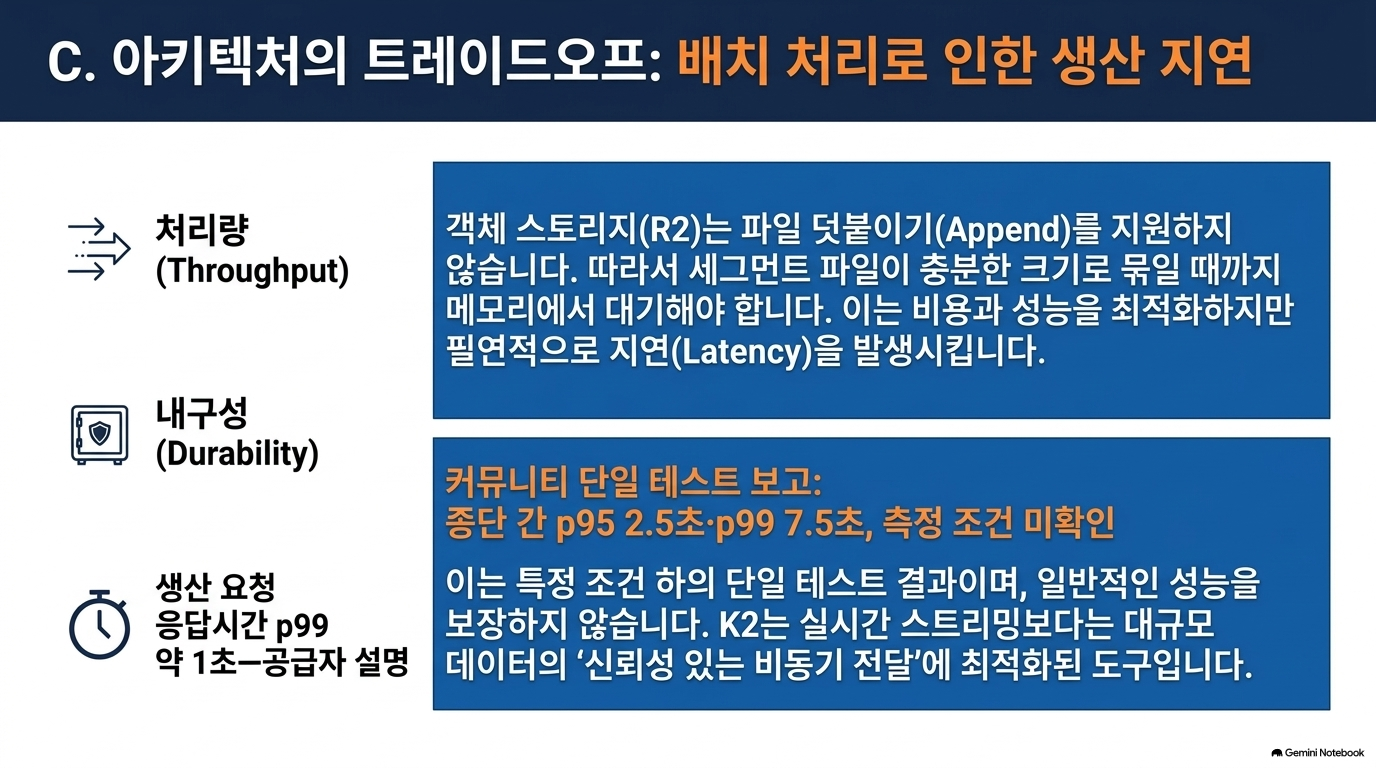
원문에 따르면 R2는 로그의 기본 연산인 append를 지원하지 않으므로, 이벤트를 완전한 파일·세그먼트 단위로 기록해야 합니다.[1]
K2는 다음 방식으로 이를 해결합니다.
쓰기 요청 수신
↓
엣지 서비스 메모리에 이벤트 축적
↓
잠시 기다려 배치 구성
↓
세그먼트 파일로 R2에 기록
이벤트 순서와 엄격하게 증가하는 오프셋은 R2의 원자적 연산으로 구현하며, 별도 조정 서비스는 필요하지 않다고 설명합니다. 다만 구체적인 알고리즘은 후속 기술 심층 글로 남겨 두었습니다.[1]
[확인 필요] 현재 글만으로는 동시 쓰기 충돌 해결, 파티션 간 순서 범위, 장애 직전 메모리 배치의 복구 절차까지 검증할 수 없습니다.
2.5 비용 효율과 지연의 교환
객체 스토리지 기록은 로컬 디스크보다 느리고, 배치가 모일 때까지 기다려야 합니다. 원문이 제시하는 초기 버전의 수치는 생산 요청 응답시간 p99 약 1초입니다.[1]
이 수치를 다음과 같이 구분해야 합니다.
| 지표 | 의미 | 이 글에서 확인되는 수준 |
| 생산 요청 지연 | 생산자가 요청하고 응답받는 시간 | p99 약 1초라는 공급자 설명 |
| 소비 가능 지연 | 기록이 소비자에게 제공될 때까지의 시간 | 별도 수치 없음 |
| 종단 간 지연 | 생산부터 최종 업무 처리 완료까지 | 공식 측정 결과 없음 |
분석: “p99 1초”를 1초 이내 최종 처리 보장으로 바꾸면 안 됩니다. 소비자의 폴링 주기, 적체, 처리시간과 재전달이 추가될 수 있습니다.
적합성 판단: 초 단위 지연을 허용하는 분석·로그 수집에는 검토할 수 있지만, 엄격한 저지연 요구가 있는 제어·거래 경로에는 별도 검증이 필요합니다.
3. Streams, Queues, or Pipelines? — 제품 선택은 처리 목적에 따라 달라진다
원문 내용
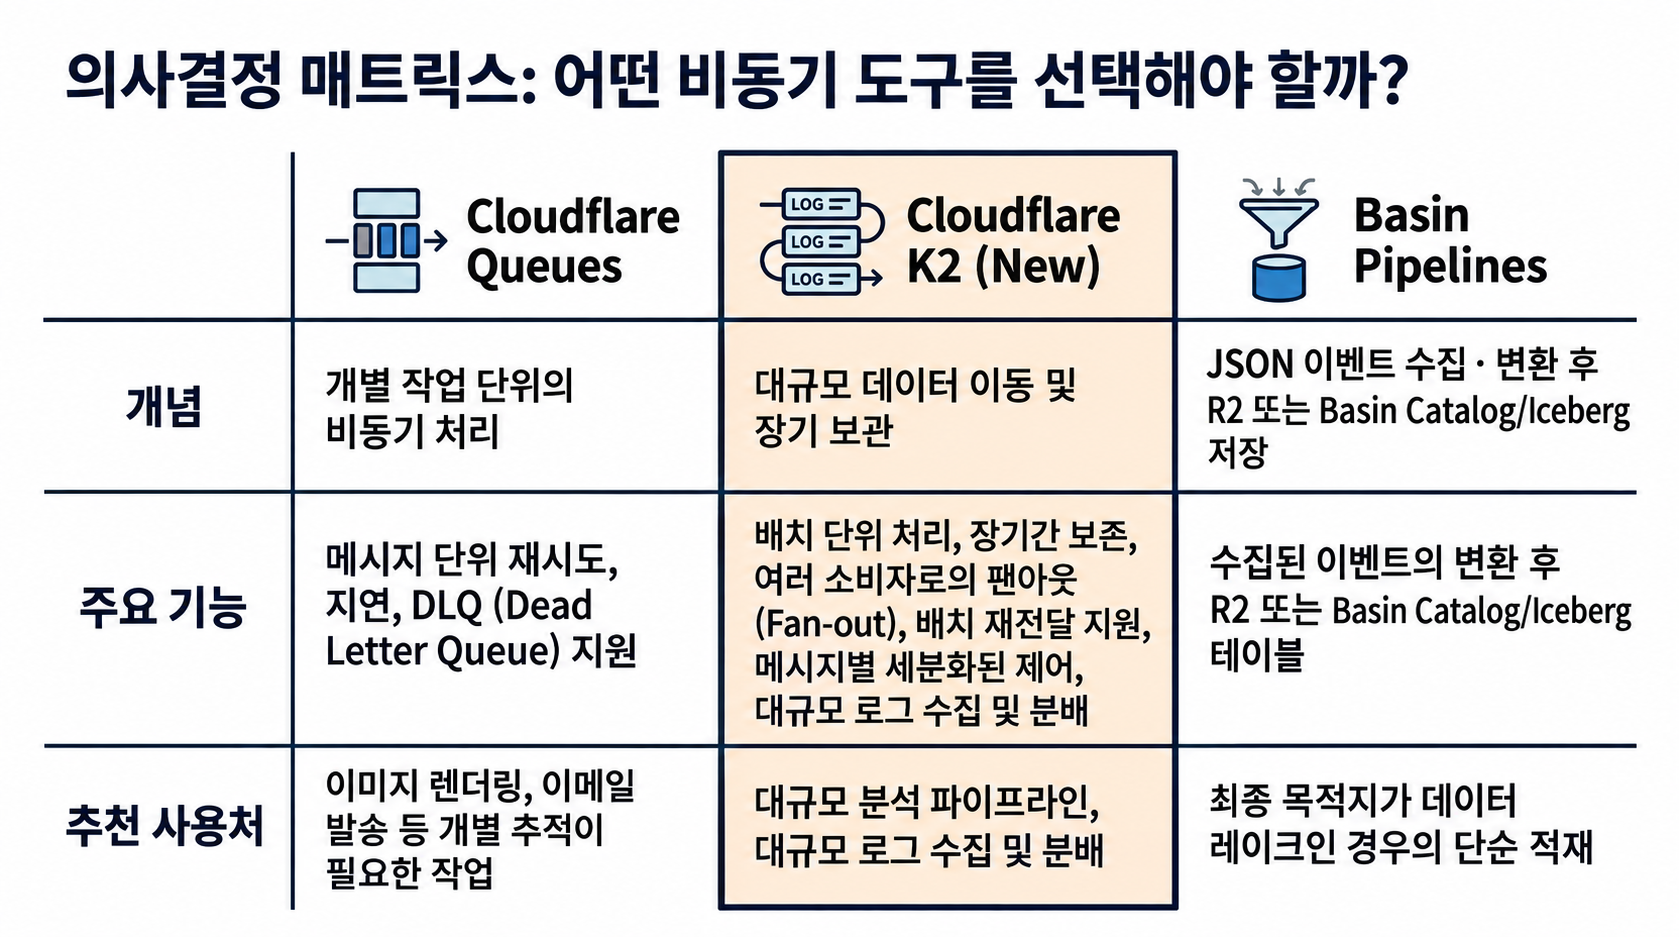
Cloudflare는 세 제품의 차이를 다음과 같이 설명합니다.[1]
| 구분 | Queues | K2 | Basin Pipelines |
| 주된 목적 | 개별 비동기 작업 완료 | 대규모 데이터 이동·보관·팬아웃 | 이벤트 수집·변환·저장 |
| 처리 관점 | 작업 항목 | 이벤트 배치·로그 | 데이터 파이프라인 |
| 실패 대응 | 개별 재시도·지연·DLQ | 배치 단위 처리·재전달 | 출시 글에서는 세부 실패 모델 미설명 |
| 소비 구조 | 작업 처리 중심 | 독립 구독과 병렬 소비 | 관리형 처리 흐름 |
| 대표 목적지 | 작업 수행 서비스 | 사용자 정의 목적지 | R2·Basin Catalog·Iceberg 테이블 |
핵심 해석
Queues는 “해야 할 일”을 관리하고, K2는 “발생한 사실”을 보존·배포합니다.
- 이미지 변환, 이메일 발송처럼 작업별 성공·실패와 재시도가 중요하다면 Queues가 더 직접적인 선택입니다.
- 하나의 이벤트를 분석·감사·이상탐지 시스템이 각각 독립적으로 읽어야 한다면 K2의 구독 모델이 적합한 방향입니다.
- 목적이 이벤트를 변환해 객체 스토리지나 Iceberg에 저장하는 것이라면, 원문은 Basin Pipelines를 권장합니다.[1]
놓치기 쉬운 차이: 배치 재전달과 메시지별 재시도
K2도 실패한 배치를 nack으로 반환할 수 있습니다. 따라서 “재시도가 전혀 없다”는 뜻은 아닙니다. 다만 메시지 하나만 골라 재시도하는 모델과는 다릅니다.[1][5]
분석 예시: 한 배치에서 일부 레코드는 DB 기록에 성공하고 나머지는 실패한 뒤 전체 배치를 재전달하면, 성공했던 레코드가 다시 처리될 수 있습니다.
따라서 K2를 사용할 때에는 다음 애플리케이션 설계를 권장합니다.
- 이벤트별 고유 식별자
- 중복 수신 시 결과가 바뀌지 않는 멱등 처리
- 정상 데이터와 오류 데이터의 분리
- 반복 실패 레코드의 별도 격리·재처리 경로
이는 K2가 제공한다고 확인된 기능이 아니라, 배치 소비 모델에 대응하기 위한 설계 권고입니다.
4. Getting started — 스트림·구독·임대로 처리 흐름을 구성한다
4.1 스트림 생성과 생산
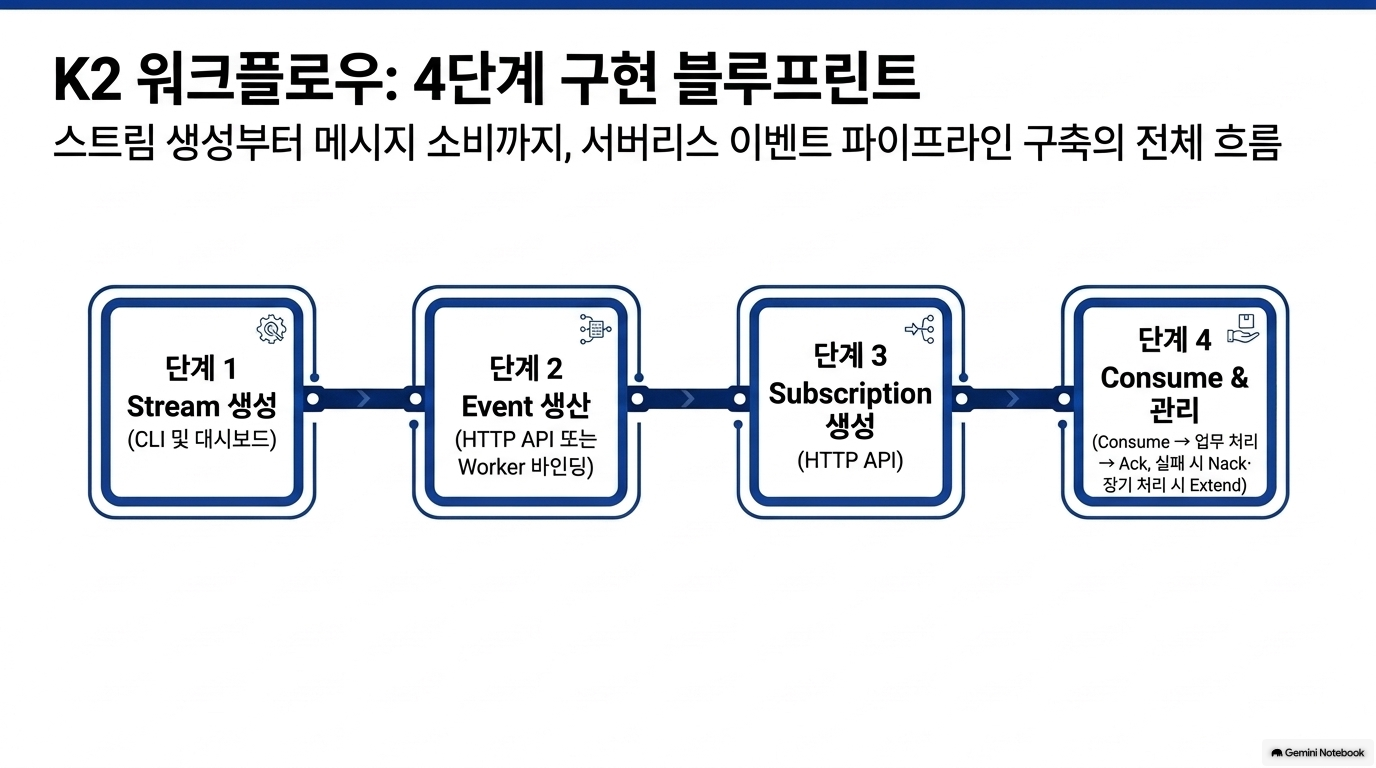
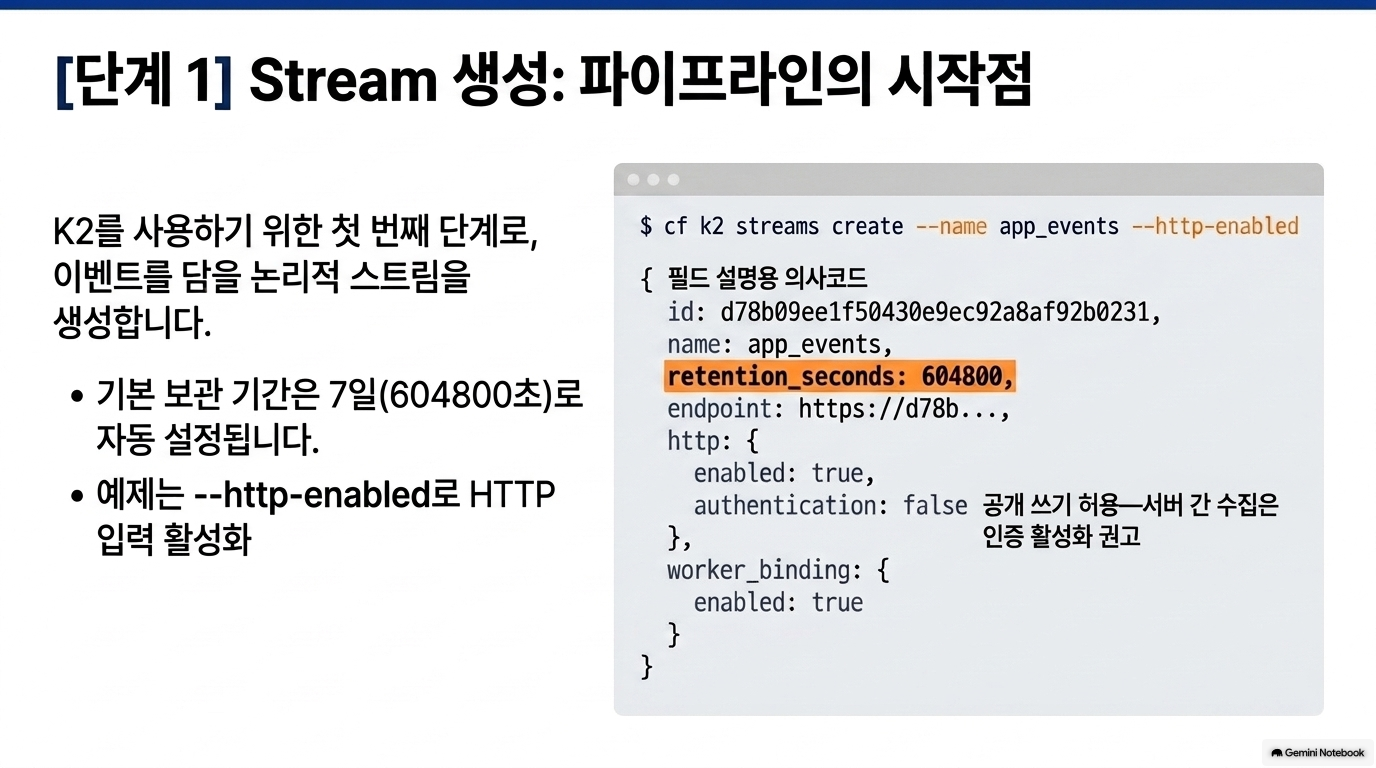
원문은 다음 명령으로 스트림을 생성하는 예제를 제시합니다.[1]
bashCopy
cf k2 streams create --name app_events --http-enabled
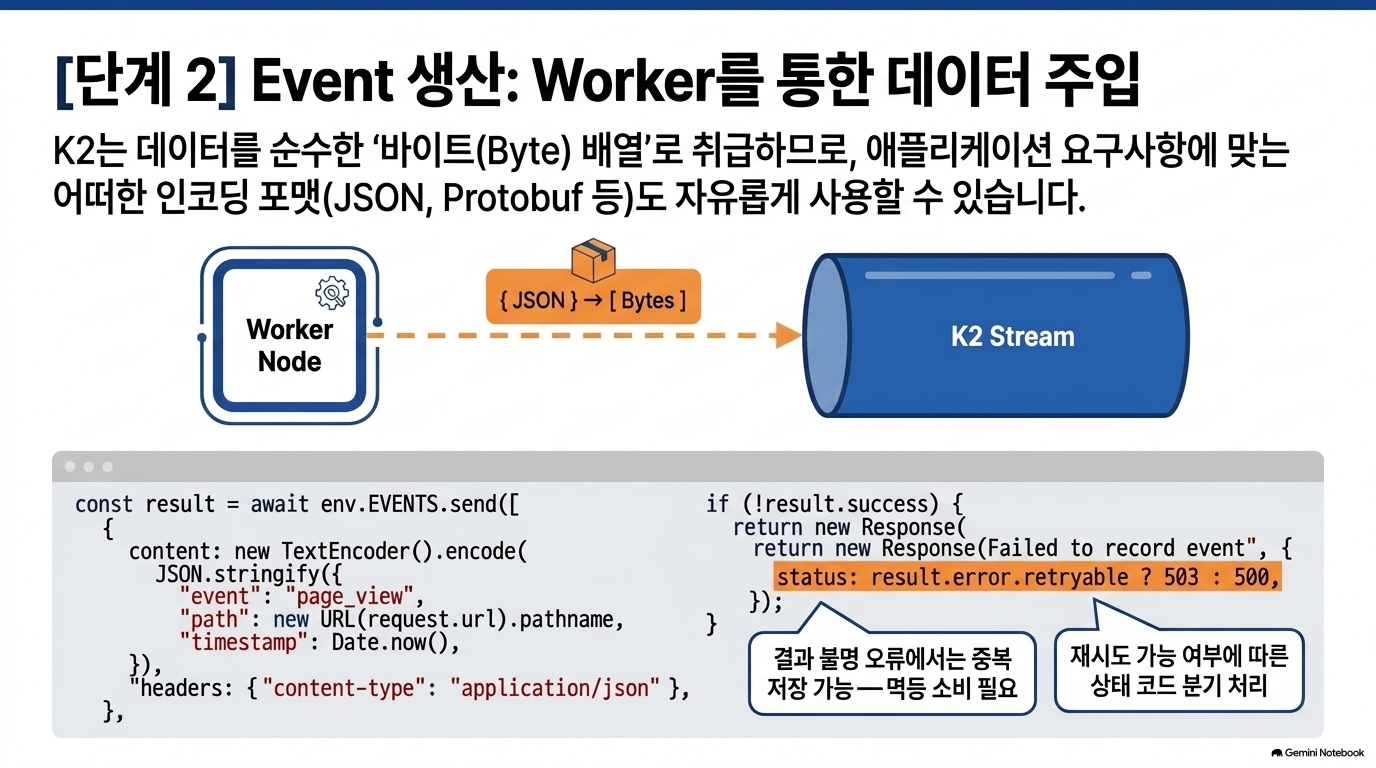
이후 HTTP API 또는 Workers 바인딩으로 이벤트를 보냅니다. K2는 이벤트 내용을 바이트로 취급하므로 JSON을 포함해 애플리케이션에 맞는 인코딩을 사용할 수 있습니다.[1][4]
공식 문서에서 확인되는 추가 조건은 다음과 같습니다.[4]
- HTTP의 content는 표준 Base64를 사용합니다.
- Workers 바인딩에서는 ArrayBuffer 또는 Uint8Array를 사용합니다.
- 생산 배치 쓰기는 원자적입니다. 배치 전체가 기록되거나, 기록되지 않습니다.
- 서버가 수신 시각을 기록하며, 현재 사용자가 그 시각을 덮어쓸 수 없습니다.
분석: 배치 쓰기의 원자성은 최종 업무 처리의 원자성이나 exactly-once 보장이 아닙니다. 또한 학습 이벤트처럼 실제 발생시각이 중요한 데이터는 K2 수신시각 외에 페이로드에 별도의 발생시각을 유지하는 것이 필요합니다.
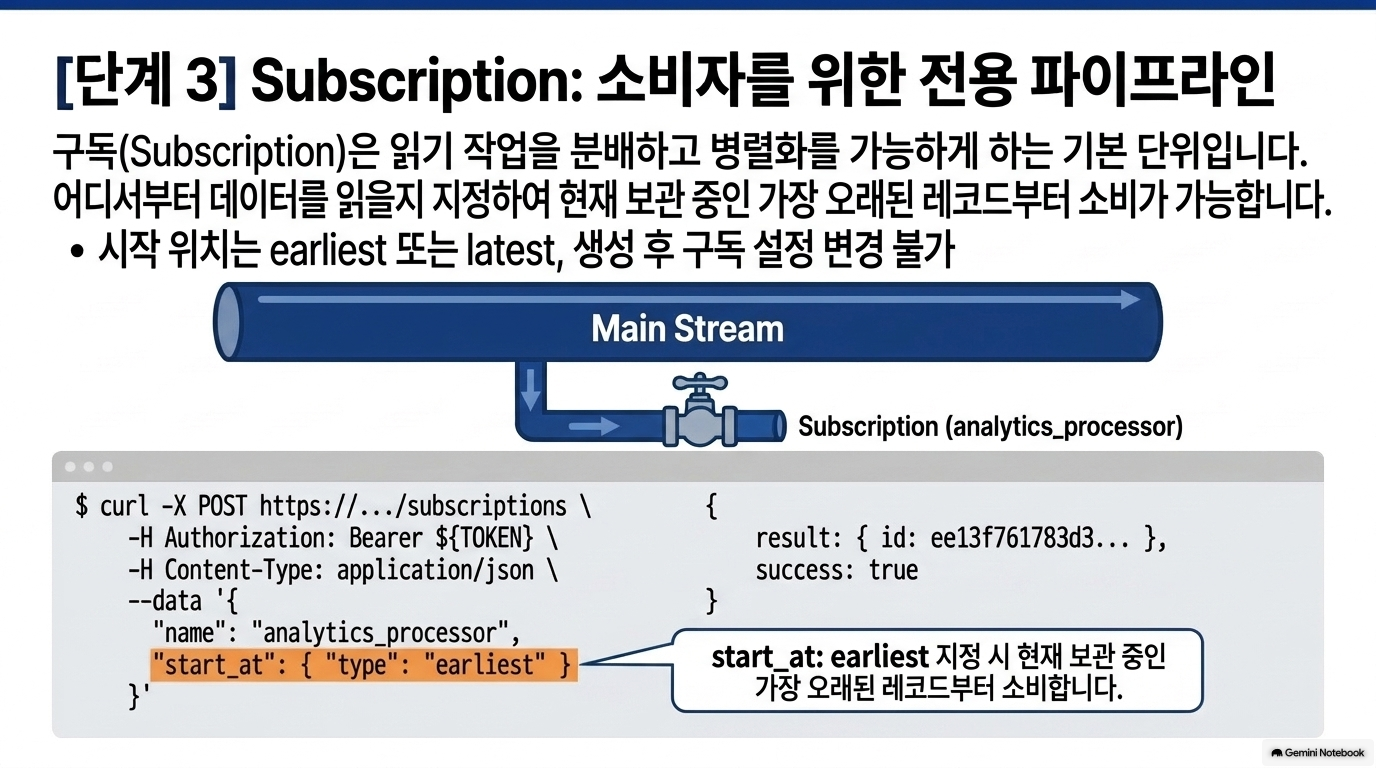
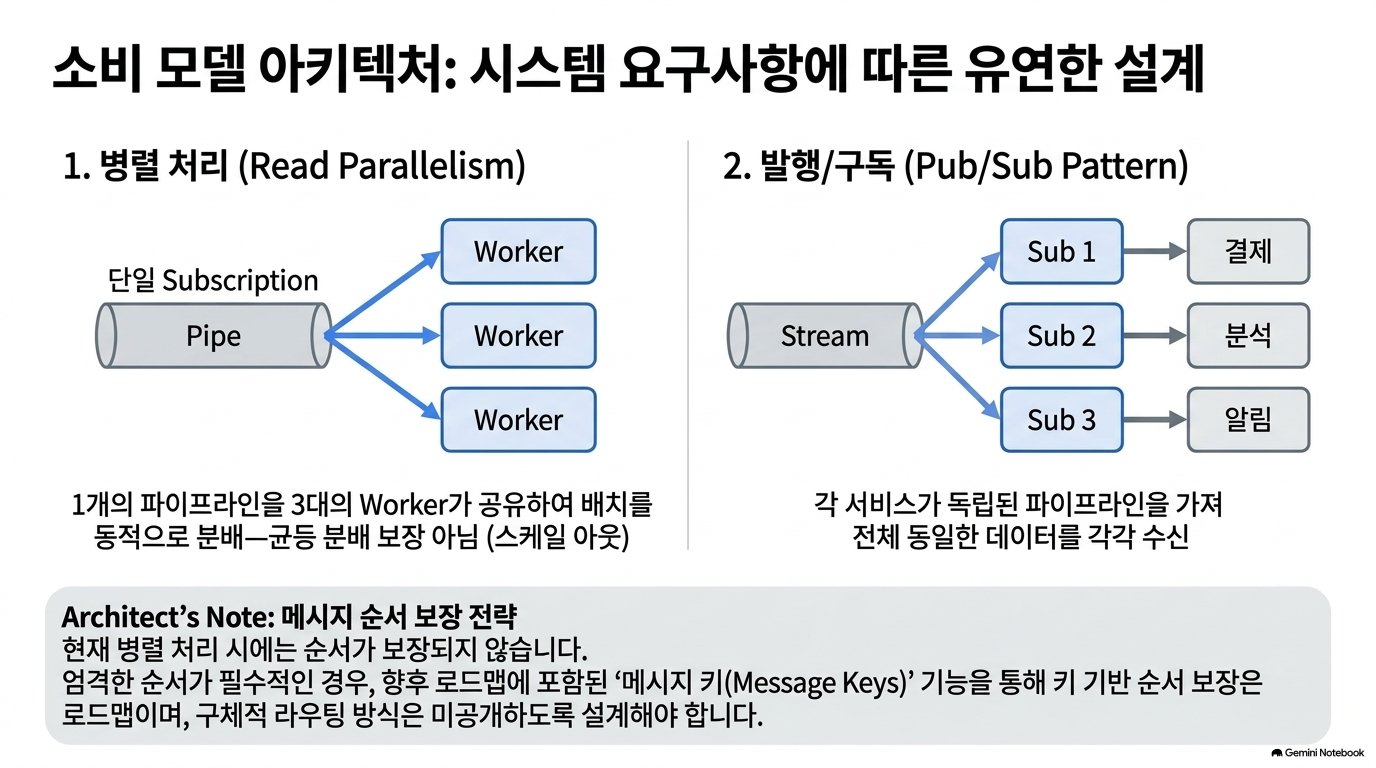
4.2 구독: 작업 분배와 팬아웃을 구분한다
하나의 구독을 공유하는 경우
K2 스트림
└── 구독 A
├── 소비자 A1: 일부 배치
├── 소비자 A2: 일부 배치
└── 소비자 A3: 일부 배치
같은 업무를 여러 소비자에게 나눠 처리하는 방식입니다.[1][5]
여러 독립 구독을 만드는 경우
K2 스트림
├── 분석 구독 ── 분석 소비자 풀
├── 품질검증 구독 ── 검증 소비자 풀
└── 이상탐지 구독 ── 탐지 소비자 풀
각 구독이 동일 이벤트를 독립적으로 읽는 방식입니다.[1][5]
실무 의미: 처리량 확장을 위해 소비자 수를 늘리는 것과, 새로운 업무가 전체 데이터를 읽도록 구독을 추가하는 것은 다릅니다. 후자는 소비 데이터량과 비용에도 영향을 줍니다.
4.3 배치 임대: 수신과 완료를 구분한다
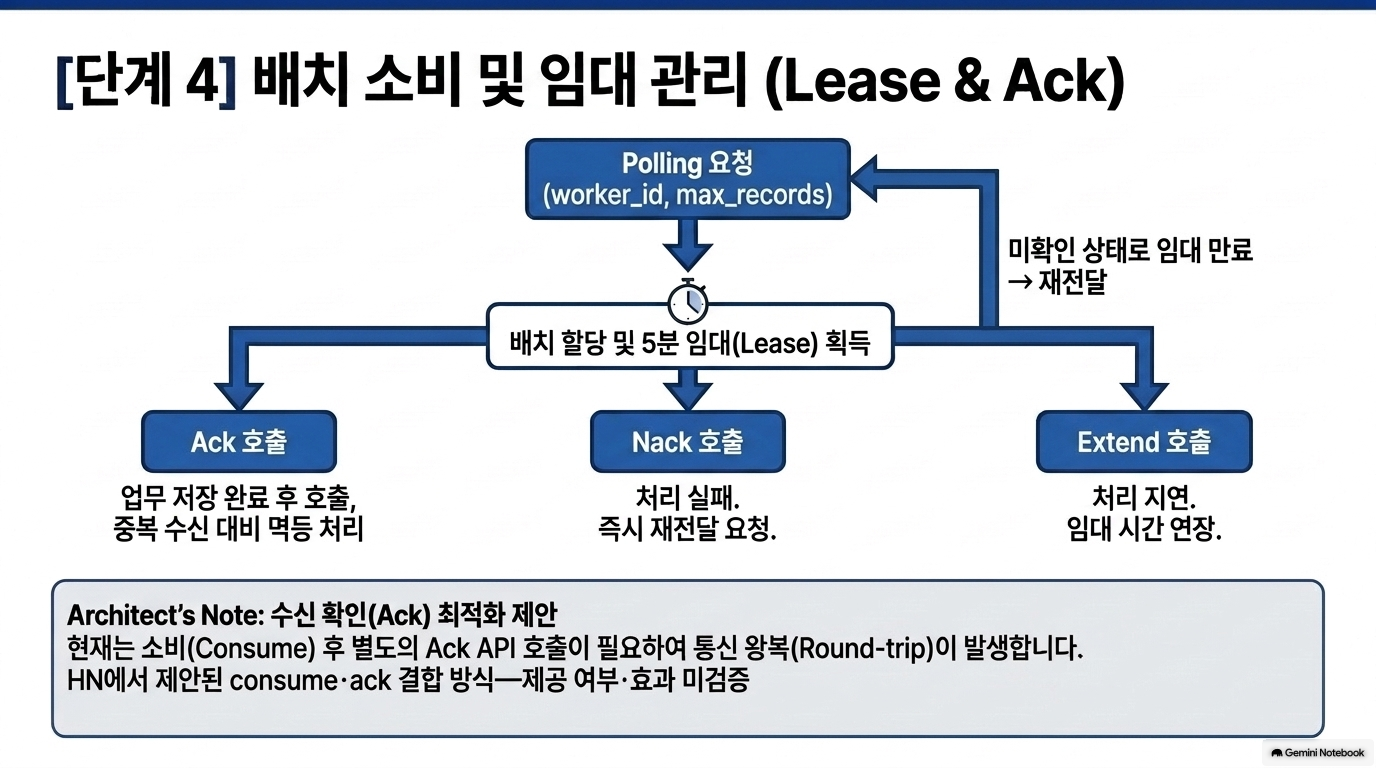
consume 호출은 배치를 “완료 처리”하는 것이 아니라, 소비자에게 5분 동안 처리할 권한을 임대하는 것입니다.[1][5]
| 동작 | 의미 |
| ack | 배치 처리 완료 |
| nack | 배치를 반환하고 재전달 요청 |
| extend | 처리 시간이 더 필요하여 임대 연장 |
| 임대 만료 | 미확인 레코드가 다시 전달될 수 있음 |
공식 문서는 최소 1회 전달(at-least-once)을 명시하며, 소비자가 같은 레코드를 여러 번 받을 수 있다고 설명합니다.[5]
중요한 실패 구간
소비자 DB 기록 성공
↓
ack 전송 또는 응답 수신 실패
↓
배치 재전달
↓
같은 이벤트를 다시 처리할 가능성
따라서 데이터 수신 여부, 업무 처리 여부, ack 여부를 구분해야 합니다.
4.4 로그 순서와 업무 처리 순서는 다르다
원문은 로그의 순서와 증가하는 오프셋을 설명하지만, 공식 소비 문서는 하나의 구독을 공유하는 여러 워커 사이에서 처리 순서를 보장하지 않는다고 명시합니다.[1][5]
분석: 주문 생성→결제→취소처럼 순서 의존성이 있는 업무라면, 단순히 “순서형 로그”라는 설명만으로 처리 결과의 순서를 보장할 수 없습니다. 키별 순차 처리나 상태 전이 검증이 필요하며, 키 기반 순서 보장은 원문에서 향후 기능으로 제시됩니다.[1]
4.5 원문 예제에서 보완해야 할 사항
[보완 필요: 인증] 원문 생성 응답에는 http.authentication: false가 표시됩니다. 공식 문서에 따르면 인증을 생략하거나 false로 설정하면, 엔드포인트를 아는 누구나 이벤트를 생산할 수 있습니다.[1][7]
권고 사항은 다음과 같습니다.
- 서버 간 수집은 생산 인증 또는 Workers 바인딩 활용
- 공개 입력이 필요하면 스키마 검증·남용 방지·데이터 오염 대응 추가
- CORS를 인증 수단으로 취급하지 않기
- 브라우저에 API 토큰을 포함하지 않기
[보완 필요: 예제 일관성] 원문의 스트림 생성·구독 생성·ack 예제는 d78b09ee1f50430e9ec92a8af92b0231을 사용하지만, consume 예제는 4d8f5394e3e733debdeca9c65c5b7439를 사용합니다. 동일 처리 흐름의 예제로는 식별자가 불일치하므로, 실제 사용 시 생성한 스트림의 엔드포인트를 일관되게 적용해야 합니다.[1]
5. Pricing and Availability — 저장보다 팬아웃 비용과 베타 한도를 봐야 한다
원문 내용
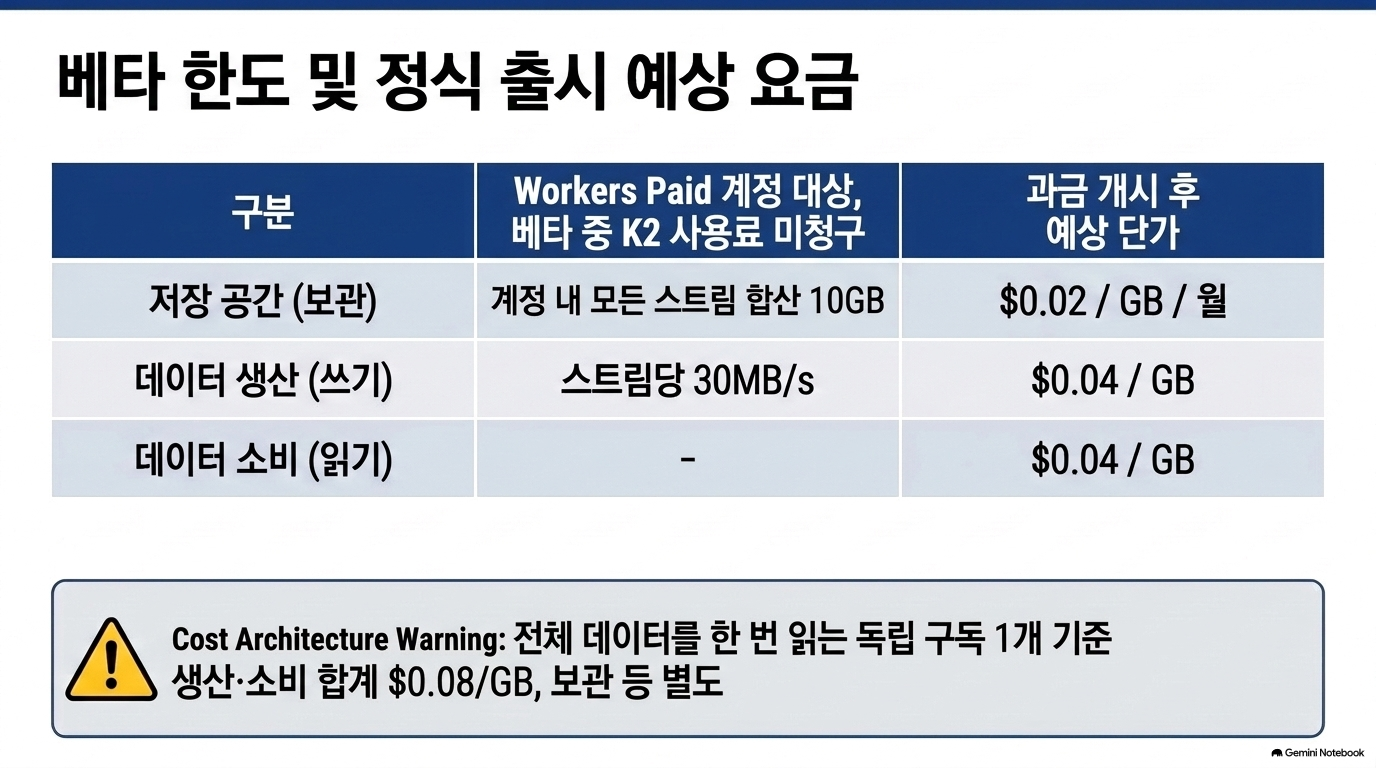
출시 글은 Workers Paid 계정에서 공개 베타를 사용할 수 있으며, 다음 한도를 제시합니다.[1]
- 저장 공간 10GB
- 스트림당 생산 처리량 30MB/s
- 베타 기간 K2 사용료 미청구
과금 시작 후 예상 요금은 다음과 같습니다. 확정 요금으로 표현하지 않는 것이 중요합니다.[1]
| 항목 | 예상 요금 |
| 생산 데이터 | $0.04/GB |
| 소비 데이터 | $0.04/GB |
| 보관 데이터 | $0.02/GB/월 |
5.1 팬아웃은 비용 변수다
다음은 원문의 예상 단가를 적용한 계산 예시이며, 현재 베타 요금이나 견적이 아닙니다.
가정:
- 월 생산량 1,000GB
- 각 독립 구독이 전체 데이터를 한 번씩 소비
- 월평균 보관량 100GB
- 재전달·재처리와 다른 서비스 비용 제외
| 독립 전체 소비 구독 수 | 생산 비용 | 소비 비용 | 보관 비용 | 합계 |
| 1 | $40 | $40 | $2 | $82 |
| 3 | $40 | $120 | $2 | $162 |
| 5 | $40 | $200 | $2 | $242 |
분석: 저렴한 저장소를 사용한다고 전체 처리 비용도 자동으로 낮아지는 것은 아닙니다. 여러 업무가 전체 데이터를 독립적으로 읽거나 재처리를 많이 하면 소비 비용이 커집니다.
GeekNews 토론의 팬아웃 비용 우려도 이 구조를 지적한 것입니다.[2]
5.2 처리량과 보관 용량은 별개다
공식 문서에서 10GB 한도는 스트림별이 아니라 계정의 모든 스트림을 합친 한도로 확인됩니다.[6]
단순히 10GB를 30MB/s로 나누면 약 333초, 5.56분입니다. 이는 십진 단위로 계산하고, 삭제 없이 계속 기록한다고 가정한 용량 소진 예시입니다.
분석: 30MB/s라는 생산 처리량을 보고 대규모 장기 보관이 베타 기본 한도에서 가능하다고 판단하면 안 됩니다. 지속 수집량·보관기간·계정 저장 한도를 함께 계산해야 합니다.
5.3 공식 문서의 추가 한도
| 항목 | 확인된 한도 |
| 계정당 스트림 | 20개 |
| 기본 보관기간 | 7일 |
| 일반 최대 보관기간 | 30일 |
| 생산 요청 크기 | 5MB |
| 레코드 크기 | 약 1MB |
| 스트림당 구독 | 100개 |
| 구독당 활성 임대 | 128개 |
| 소비 요청 max_records | 최대 10,000개 |
| 소비 응답 데이터 | 최대 10MB |
위 값은 공식 한도 문서 기준입니다.[6]
도입 시사점: 대용량 문서·이미지·음성 원본을 이벤트에 직접 넣기보다, 별도 저장소의 참조와 처리 메타데이터를 전달하는 구조를 검토하는 것이 합리적입니다.
6. What’s next — 목표 기능을 현재 기능으로 읽지 않는다
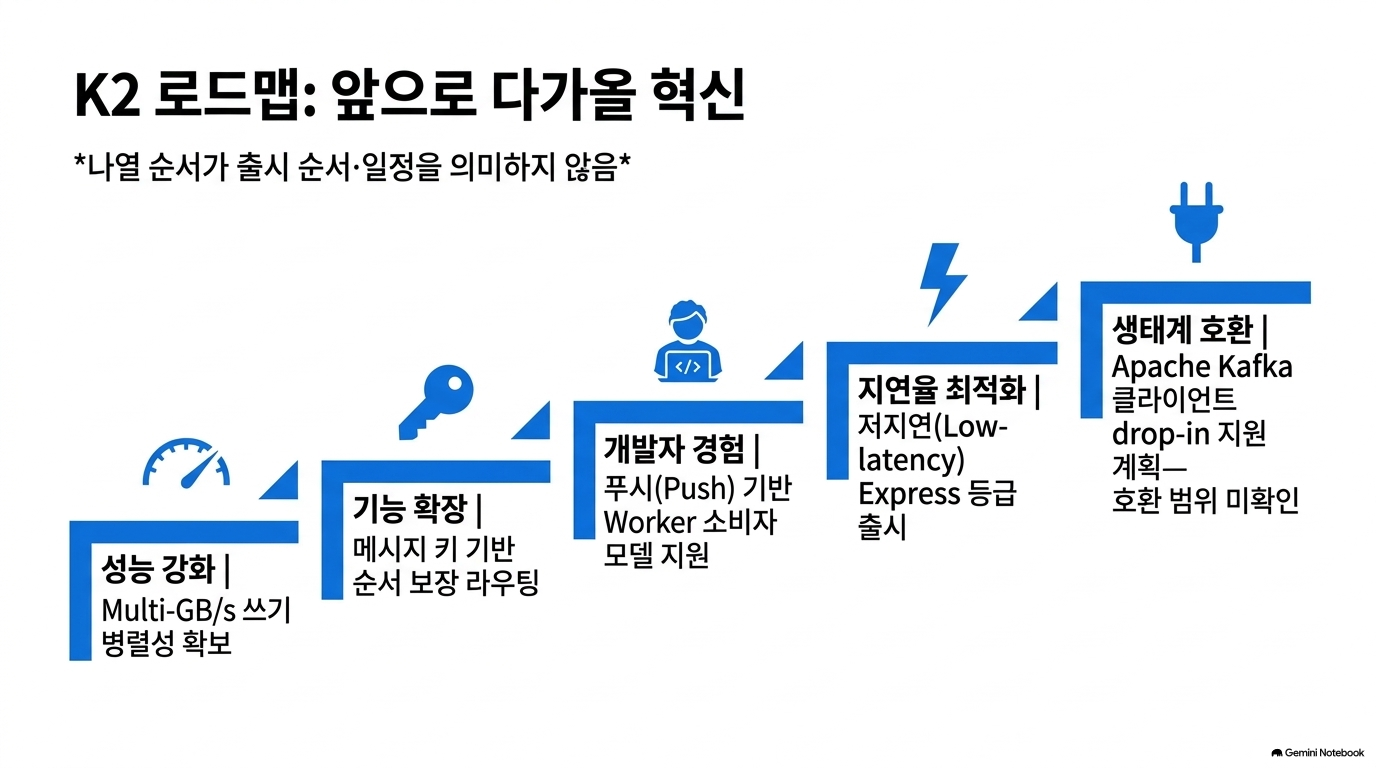
원문은 다음 항목을 향후 수개월의 로드맵으로 제시합니다.[1]
| 로드맵 | 의미 | 도입 판단 시 주의점 |
| multi-GB/s 스트림 | 쓰기 병렬성 확대 | 출시 처리량과 혼동 금지 |
| 메시지 키·키 기반 순서 | 동일 키의 순서 제어 | 현재 업무 순서 보장으로 가정 금지 |
| 푸시 기반 Worker 소비자 | 폴링 부담 완화 | 현재 예제는 풀 방식 |
| Express 등급 | 생산·종단 간 지연 축소 | 목표 지연·가격은 본문에 없음 |
| Kafka 클라이언트 호환 | 기존 클라이언트 활용 | 현재 호환 완료로 표현 금지 |
분석: 로드맵은 초기 제품의 보완 방향을 보여줍니다. 특히 키 기반 순서, 저지연, Kafka 호환이 중요한 사업이라면 계획이 아니라 실제 제공 여부와 계약 조건으로 판단해야 합니다.
Kafka 클라이언트 호환이 향후 제공되더라도, 그것만으로 트랜잭션·오프셋 관리·운영 도구까지 동일하다고 결론 내릴 수는 없습니다.
7. 공공·교육 데이터 플랫폼에 적용할 때의 검토사항
다음은 제품이 실제로 해당 사업에 적용됐다는 설명이 아니라, 문서에 근거한 설계·감리 관점의 권고입니다.
예를 들어 외부 발행사에서 수집한 학습 이벤트를 다음과 같이 분리할 수 있습니다.
외부 발행사 → 인증·검증 계층 → K2
├── 품질검증 구독
├── 학습분석 구독
└── 이상징후 탐지 구독
이 구조는 소비 업무를 분리하지만, 데이터 품질과 개인정보 통제를 대신하지는 않습니다.
| 우선순위 | 검토 항목 | 확인할 내용 |
| 높음 | 수집 보안 | 생산 인증, 권한 분리, 공개 입력 통제 |
| 높음 | 중복 처리 | 이벤트 ID, 멱등 저장, 재전달 테스트 |
| 높음 | 장애 복구 | 보관기간 내 장애 복구·적체 해소 가능 여부 |
| 높음 | 데이터 순서 | 학습자·세션별 순서 의존성과 병렬 처리 영향 |
| 높음 | 개인정보 | 저장 위치·이전·접근·삭제 정책과 계약 조건 |
| 중간 | 오류 격리 | 불량 레코드가 배치 재처리를 반복시키는지 |
| 중간 | 시간 관리 | 발생시각·수신시각·처리시각 구분 |
| 중간 | 비용 | 독립 구독 수, 재처리량, 보관량 |
| 중간 | 관측성 | 적체, 중복, 오류, 임대 만료, 종단 간 지연 |
| 후순위 | 이전 가능성 | 데이터 내보내기, 다른 스트리밍 시스템과의 연결 |
특히 공식 문서는 보관기간 만료 후 레코드를 백그라운드에서 삭제하며, 정확한 만료 시점에 읽기 불가능해지는 것을 보장하지 않는다고 설명합니다.[7]
따라서 보관기간 설정을 개인정보의 정확한 시점 파기 증적으로 그대로 사용해서는 안 됩니다. 별도 삭제 정책과 이행 증빙을 검토해야 합니다.
종합 결론
이 글의 핵심은 “Kafka를 없앴다”가 아니라, “Cloudflare의 엣지 환경에 맞춰 객체 스토리지 중심의 이벤트 로그를 설계했다”는 것입니다.
- 검토할 만한 영역: 여러 시스템이 동일 이벤트를 독립적으로 처리하고, 초 단위 지연을 허용하며, 클러스터 운영 부담을 줄이고 싶은 경우
- 별도 검증이 필요한 영역: 엄격한 저지연, 업무 순서 보장, 중복 없는 처리, 개인정보의 정확한 파기, 대규모 장기 보관
- 현재 기능으로 전제하면 안 되는 항목: Kafka 클라이언트 호환, 키 기반 순서 보장, Express 저지연 등급
데이터 품질 관점에서는 ‘유실 방지’와 ‘정확한 업무 반영’을 분리해야 합니다. K2가 이벤트 전달·보존의 기반을 제공하더라도, 중복·순서·스키마·오류 격리·개인정보 통제는 애플리케이션과 운영체계에서 완성해야 합니다.
Sources
[1] https://blog.cloudflare.com/cloudflare-k2-streams
[2] https://news.hada.io/topic?id=34629
[3] https://developers.cloudflare.com/k2
[4] https://developers.cloudflare.com/k2/features/produce
[5] https://developers.cloudflare.com/k2/features/consume
[6] https://developers.cloudflare.com/k2/platform/limits
[7] https://developers.cloudflare.com/k2/configuration