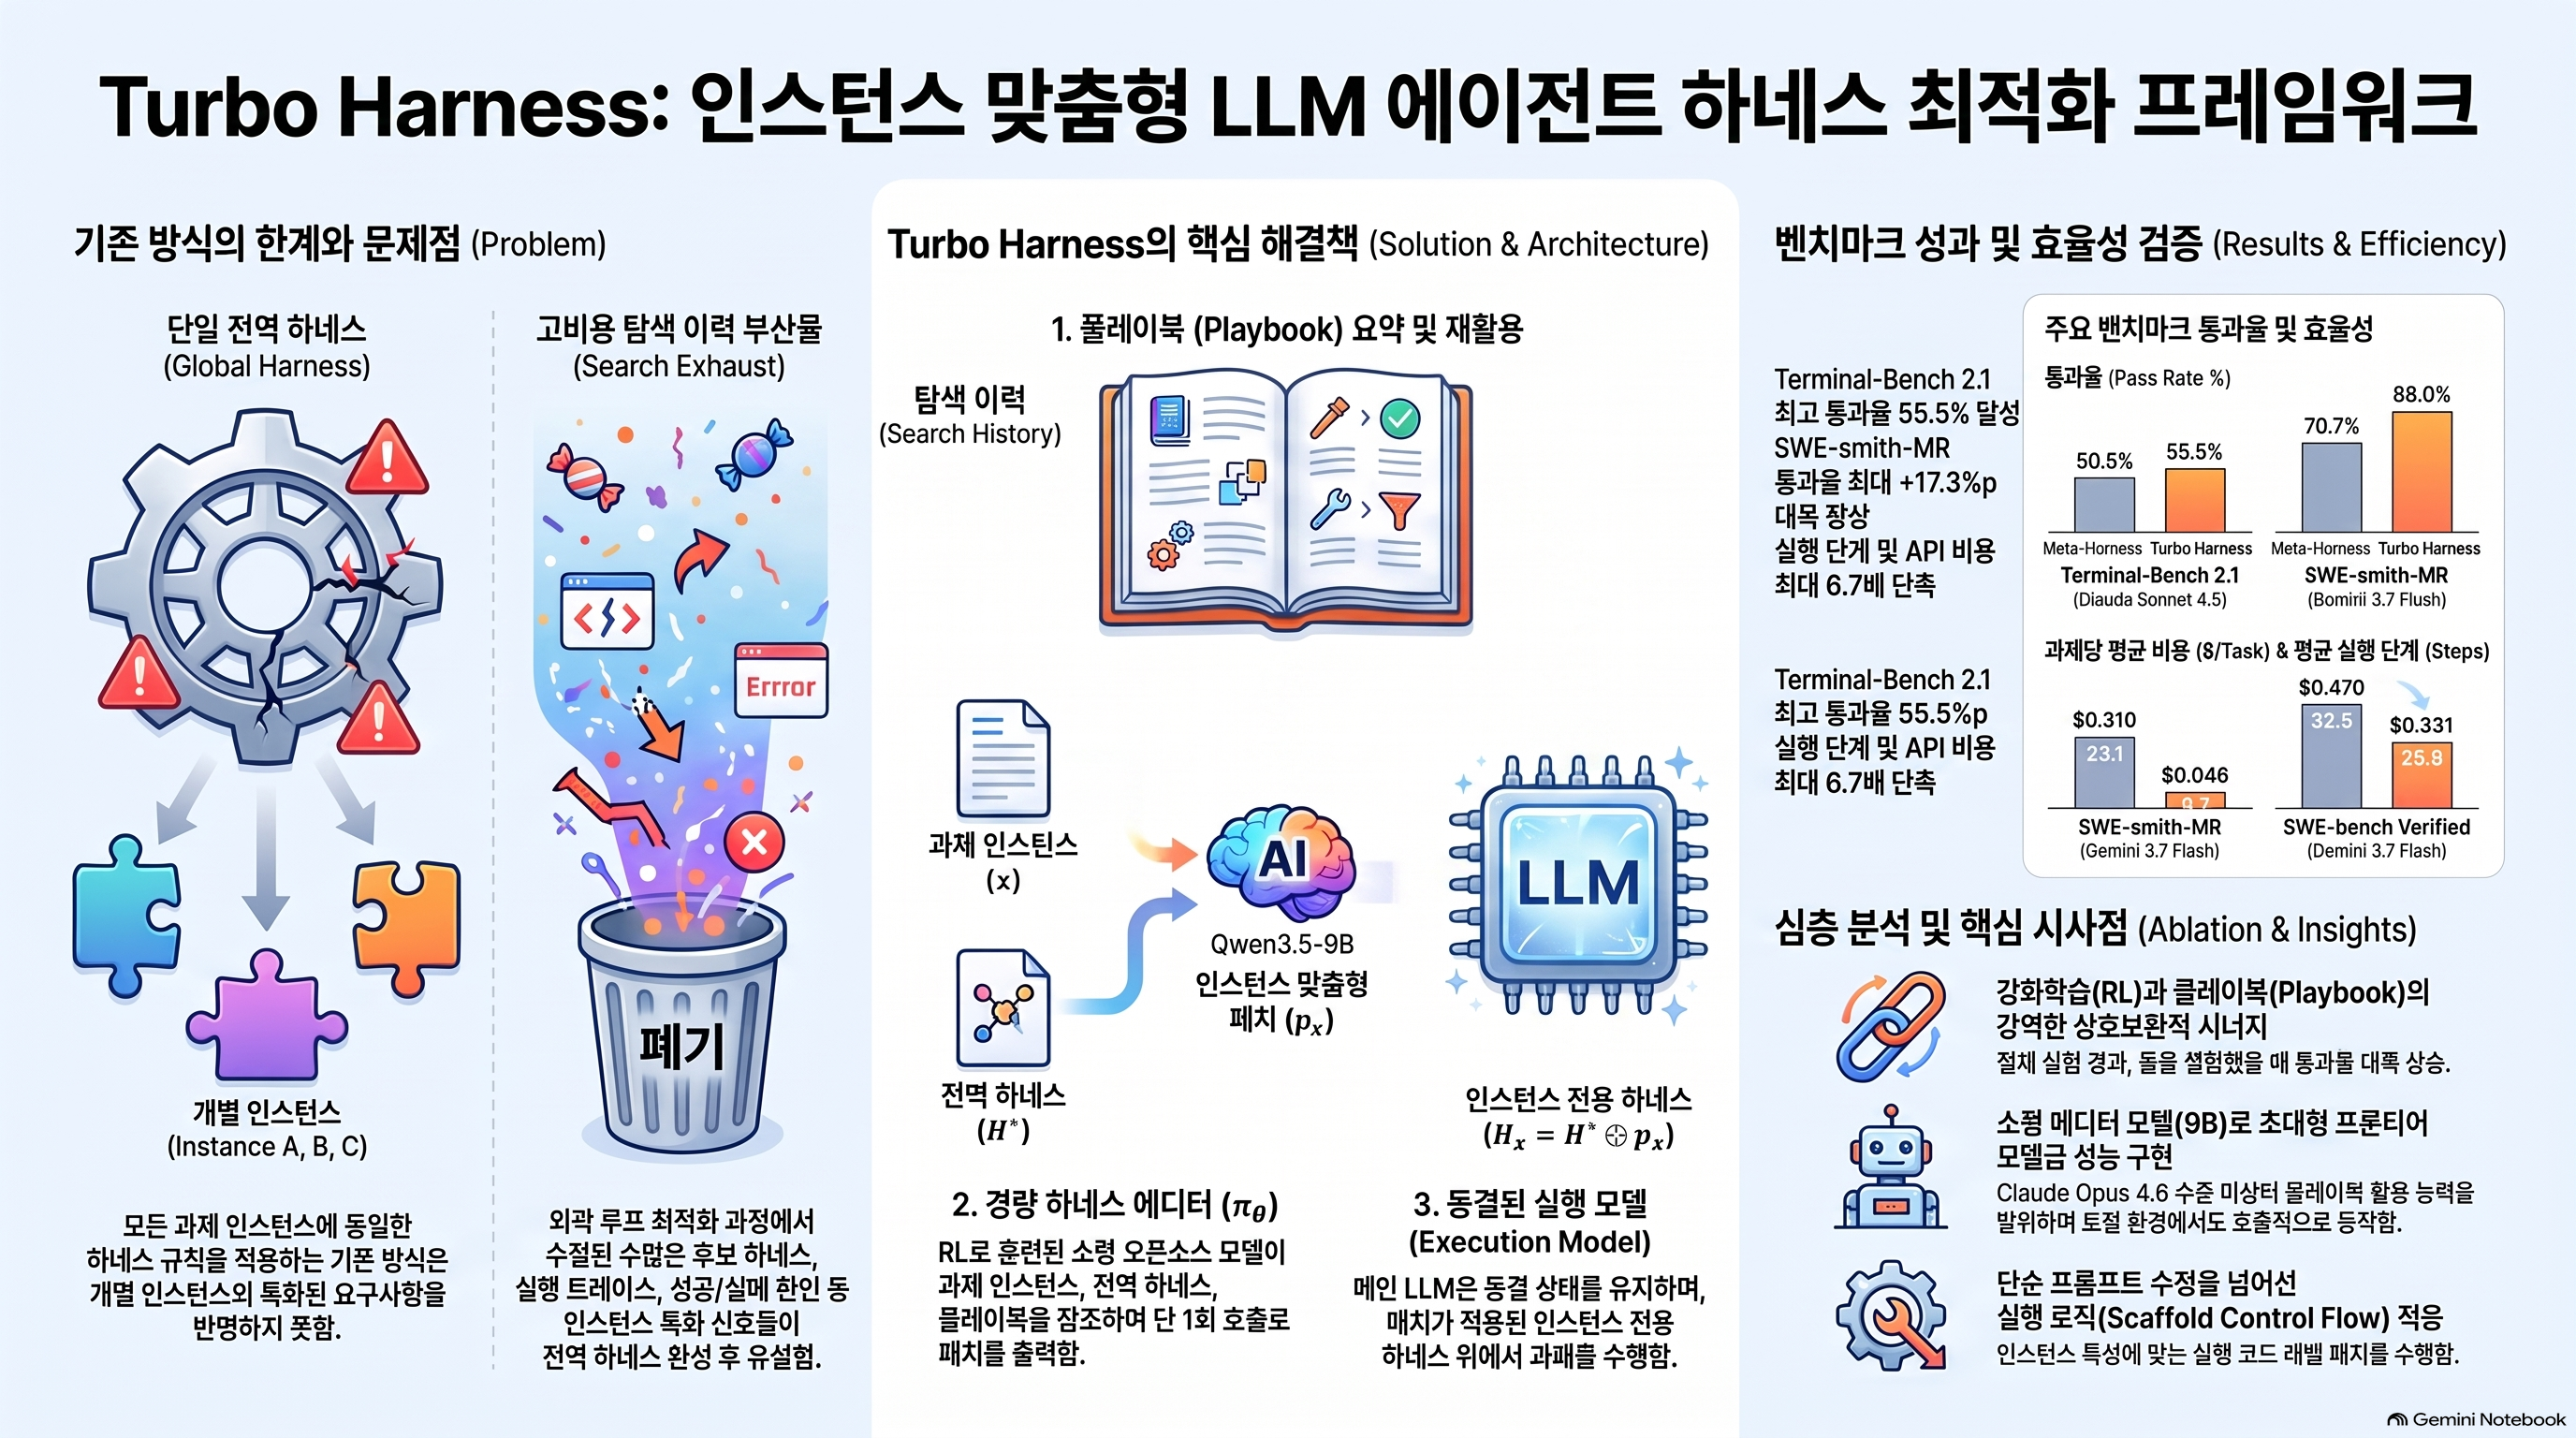
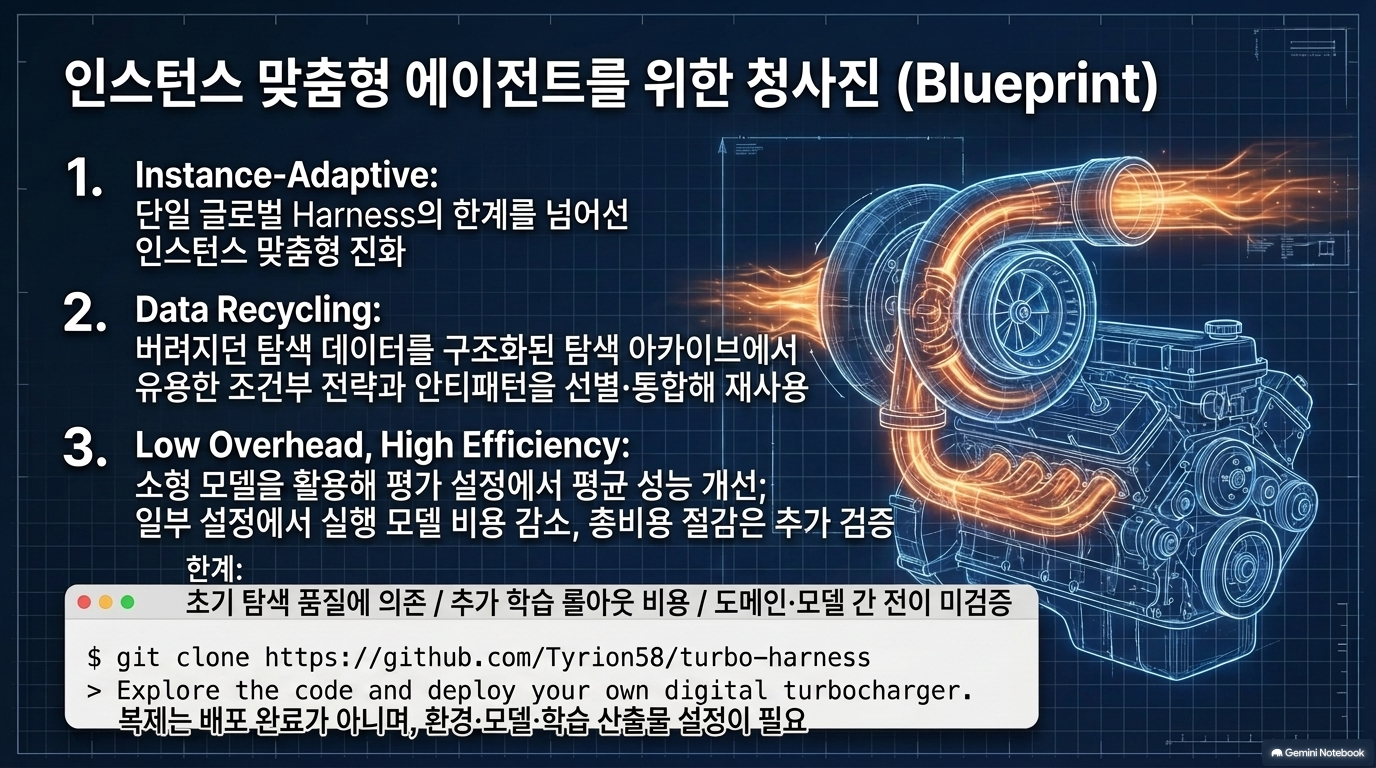
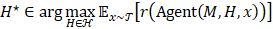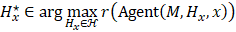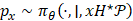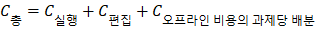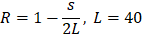제시된 문헌은 고정된 단일 환경 설정 대신 각 작업 인스턴스의 고유한 특성에 맞춰 최적의 실행 환경을 동적으로 조정하는 터보 하네스(Turbo Harness)라는 혁신적인 프레임워크를 소개하고 있습니다. 기존 방식은 모든 작업에 일괄적인 전역 해니스를 적용하여 비효율적이었으나, 본 연구는 과거 최적화 과정에서 버려지던 방대한 시행착오 데이터를 구조화된 플레이북으로 재활용합니다. 특히, 강화학습을 통해 훈련된 가벼운 해니스 편집기를 도입하여 최소한의 연산 비용으로 인스턴스별 맞춤형 코드를 생성함으로써, 다양한 벤치마크에서 작업 성공률을 대폭 높이고 전체적인 실행 비용과 단계를 획기적으로 절감할 수 있음을 입증합니다.
핵심 결론: 이 논문은 “모든 과제에 하나의 최적 실행 절차를 적용하는 방식”에서 벗어나, 기존 최적화 과정에서 축적한 성공·실패 경험을 활용하여 과제별로 실행 하네스를 수정하는 방식 을 제안합니다. 실행 모델 자체는 고정하고, 작은 편집 모델이 실행 절차와 런타임 코드를 조정합니다.[1]
핵심 결론:이 논문은 “모든 과제에 하나의 최적 실행 절차를 적용하는 방식”에서 벗어나, 기존 최적화 과정에서 축적한 성공·실패 경험을 활용하여 과제별로 실행 하네스를 수정하는 방식을 제안합니다. 실행 모델 자체는 고정하고, 작은 편집 모델이 실행 절차와 런타임 코드를 조정합니다.[1]
Tunyu Zhang, Hao Wang, Kai Xu, Dimitris N. Metaxas
소속
Rutgers University, Red Hat AI Innovation, MIT-IBM Watson AI Lab
분석 버전
arXiv:2609.40330v1, 2026년 9월 30일
분석 범위
본문 1~6장 및 부록 A~D, PDF 인쇄 페이지 기준 총 20쪽
핵심 구성
전역 하네스 + 탐색 경험 플레이북 + 강화학습된 하네스 편집 모델
편집 모델
Qwen3.5-9B
평가
상호작용형 에이전트·소프트웨어 수정·장기 터미널 작업의 7개 벤치마크
위 정보와 실험 결과는 원문에 근거하며, 아래의 ‘분석’ 및 ‘실무 시사점’은 원문을 바탕으로 한 해석입니다. 논문을 직접 재현 실행하거나 저자 보고 수치를 독립 검증한 것은 아닙니다.[1]
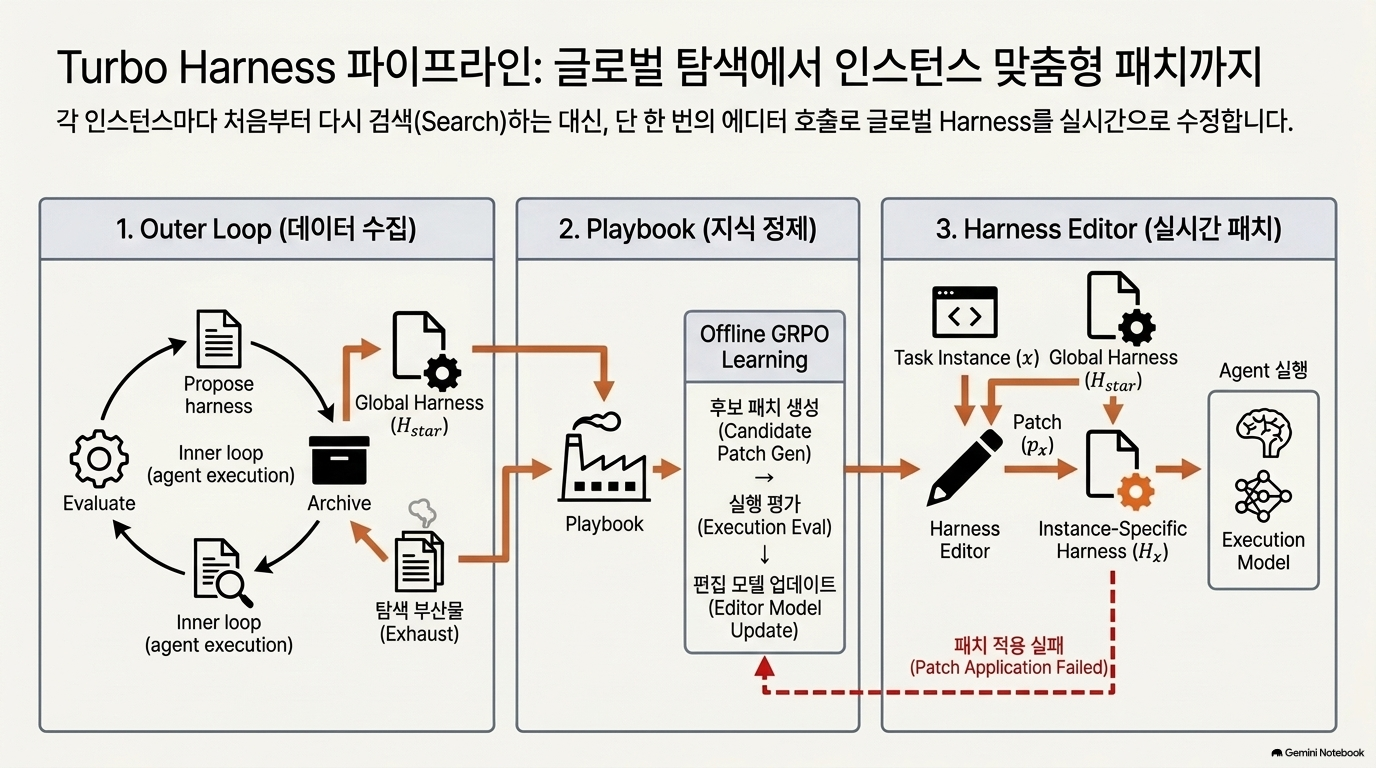
전체 논리 구조
기존 하네스 탐색
├─ 최종 전역 하네스 H*
└─ 탐색 아카이브 A
├─ 후보 하네스
├─ 실행 궤적
├─ 성공·실패 결과
└─ 수정 내역
↓
조건부 전략 플레이북 P
↓
작은 하네스 편집 모델의 RL 학습
↓
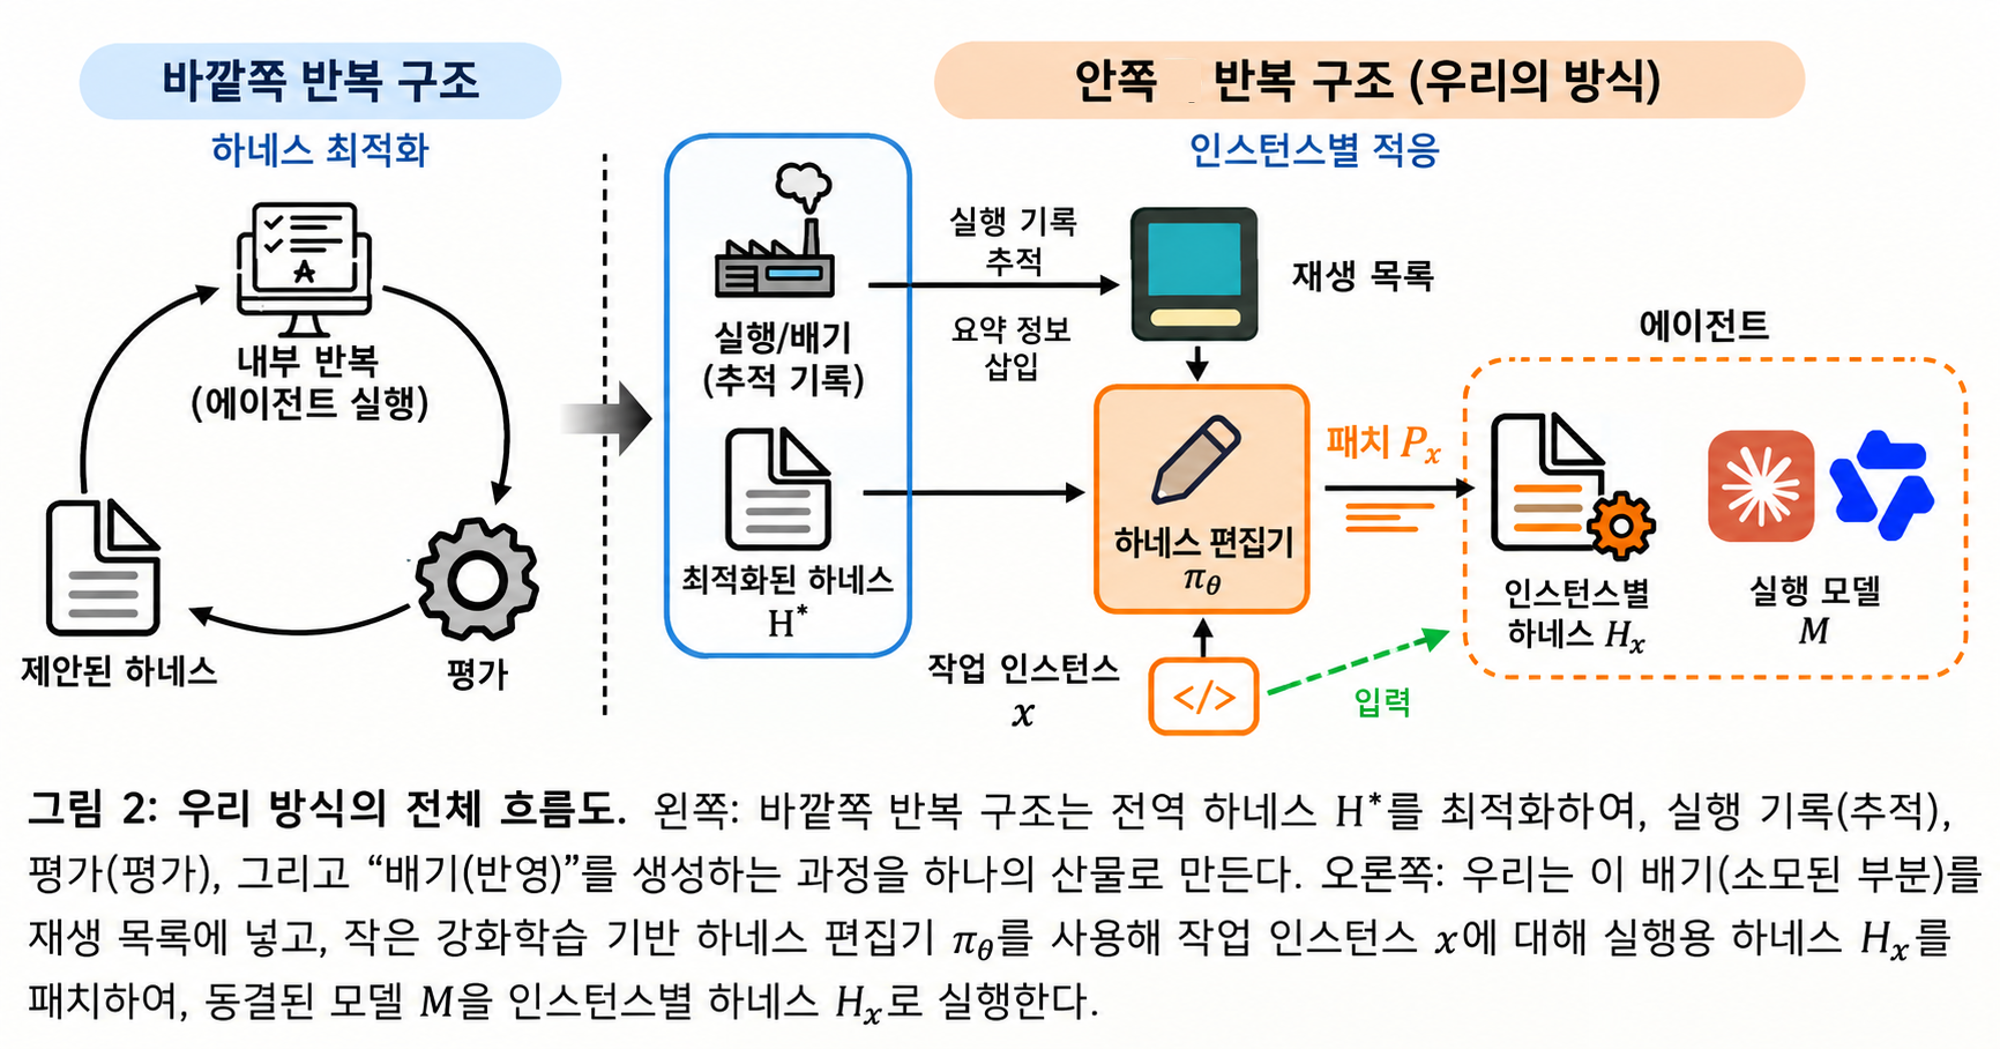
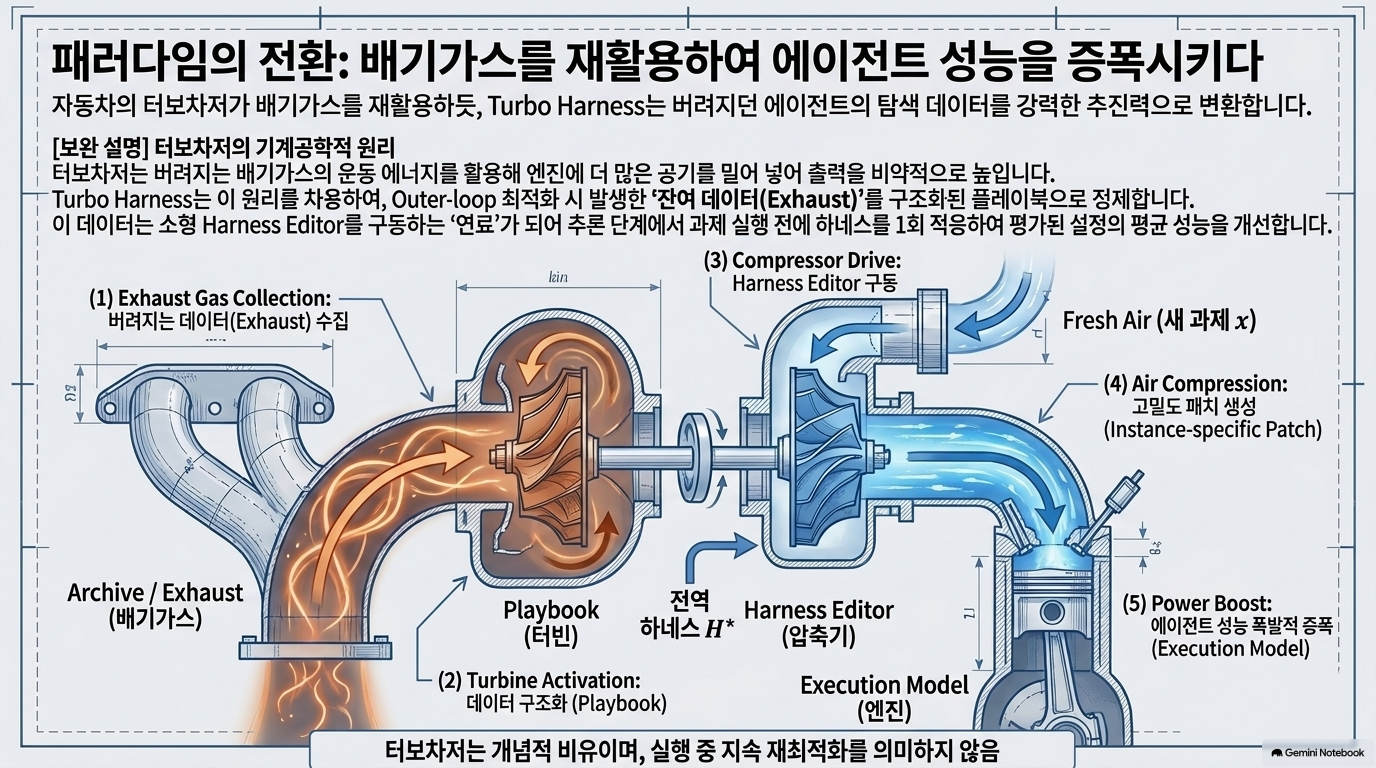
새로운 과제 x + H* + P
↓
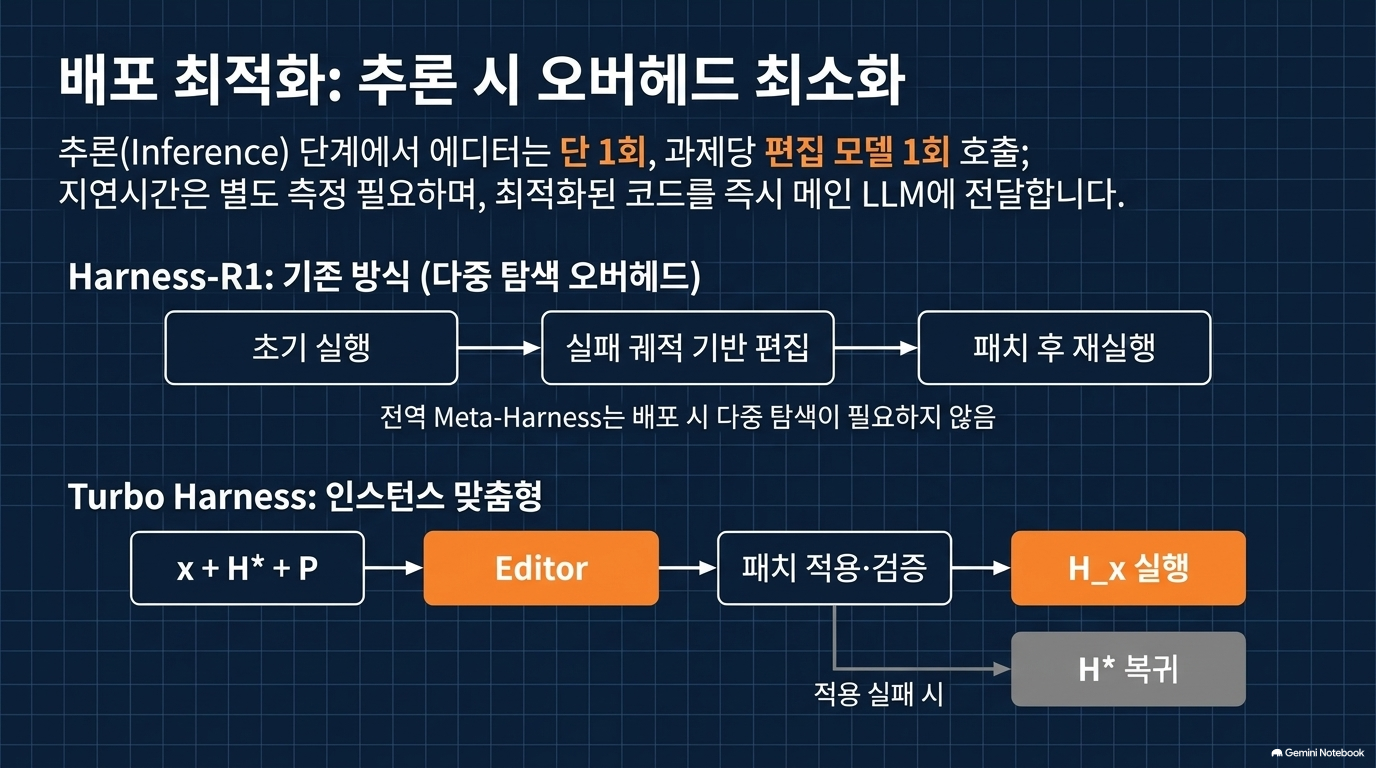
과제별 패치 px 생성 — 편집 모델 1회 호출
↓
과제별 하네스 Hx = H* ⊕ px
↓
고정된 실행 모델 M이 과제 수행
이 구조는 논문의 Figure 2와 Algorithm 1을 정리한 것입니다.[1]
읽을 때 특히 구분해야 할 세 가지는 다음과 같습니다.
하네스의 전역 최적화와 과제별 적응은 별도 단계입니다.
작은 모델이 수정하는 대상은 과제의 최종 답안이 아니라 실행 모델을 둘러싼 하네스입니다.
추론 때는 편집 모델을 한 번 호출하지만, 이를 학습하는 과정에서는 여러 후보 패치와 환경 실행이 필요합니다.[1]
1장. Introduction — 왜 전역 하네스만으로는 부족한가?
원문 pp. 1–3
1.1 하네스를 프롬프트보다 넓게 정의한다
논문에서 하네스는 단순한 시스템 프롬프트나 도구 목록이 아닙니다. 다음과 같은 모델 주변의 실행 기반 전체를 포함합니다.[1]
하네스 구성
결정하는 사항
컨텍스트 관리
어떤 정보를 모델에 보여줄 것인가
상태·메모리 관리
무엇을 기억하고 유지할 것인가
워크플로 제어
어떤 순서로 탐색·수정·검증할 것인가
도구 사용
언제 어떤 도구를 호출할 것인가
검증
어느 시점에 테스트하거나 결과를 확인할 것인가
계산 예산
단계별로 얼마나 많은 실행을 허용할 것인가
분석:에이전트 성능을 모델의 추론 능력만으로 설명하지 않고, 모델 능력과 실행 구조가 결합된 결과로 보는 관점입니다. 따라서 모델을 바꾸지 않아도 실행 구조를 개선해 성능을 높일 수 있다는 것이 출발점입니다.
1.2 기존 연구의 한계 ①: 평균적으로 좋은 절차가 모든 과제에 좋은 것은 아니다
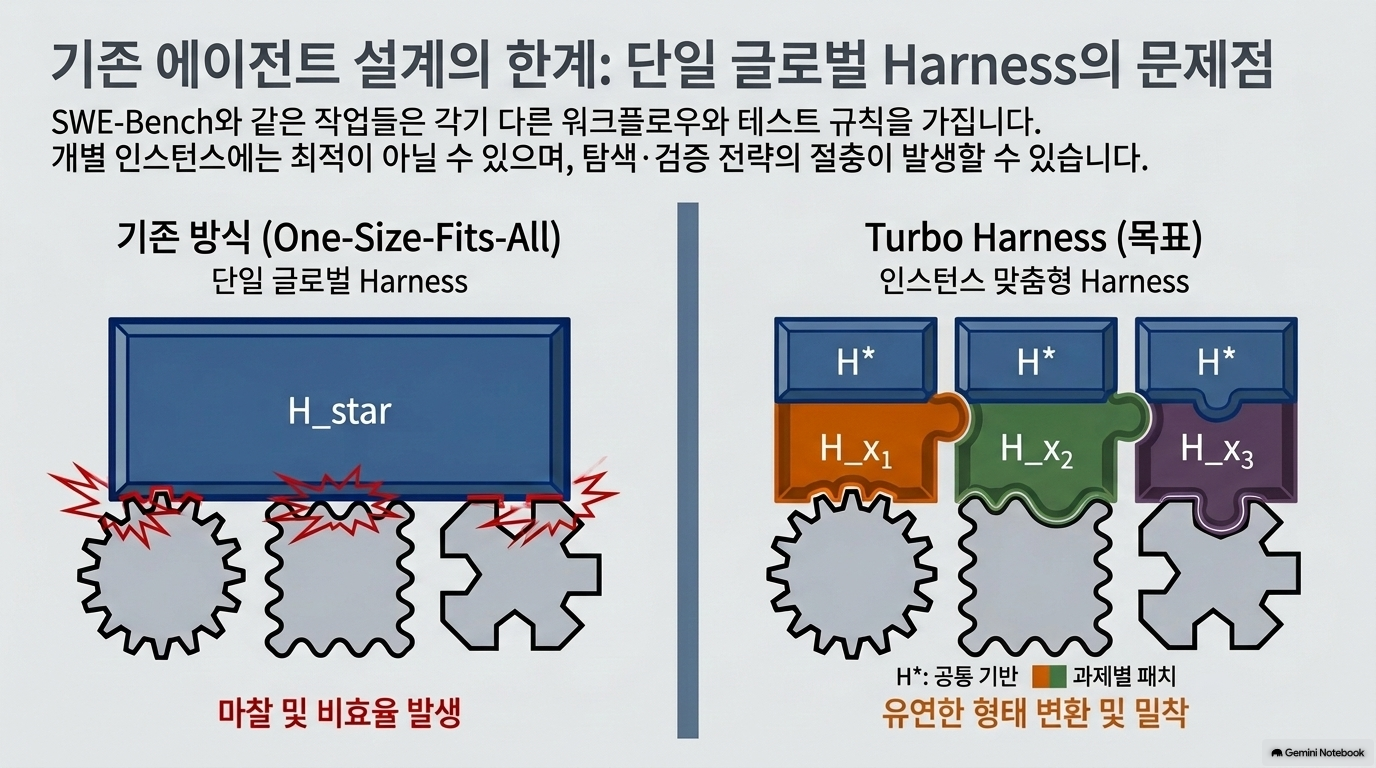
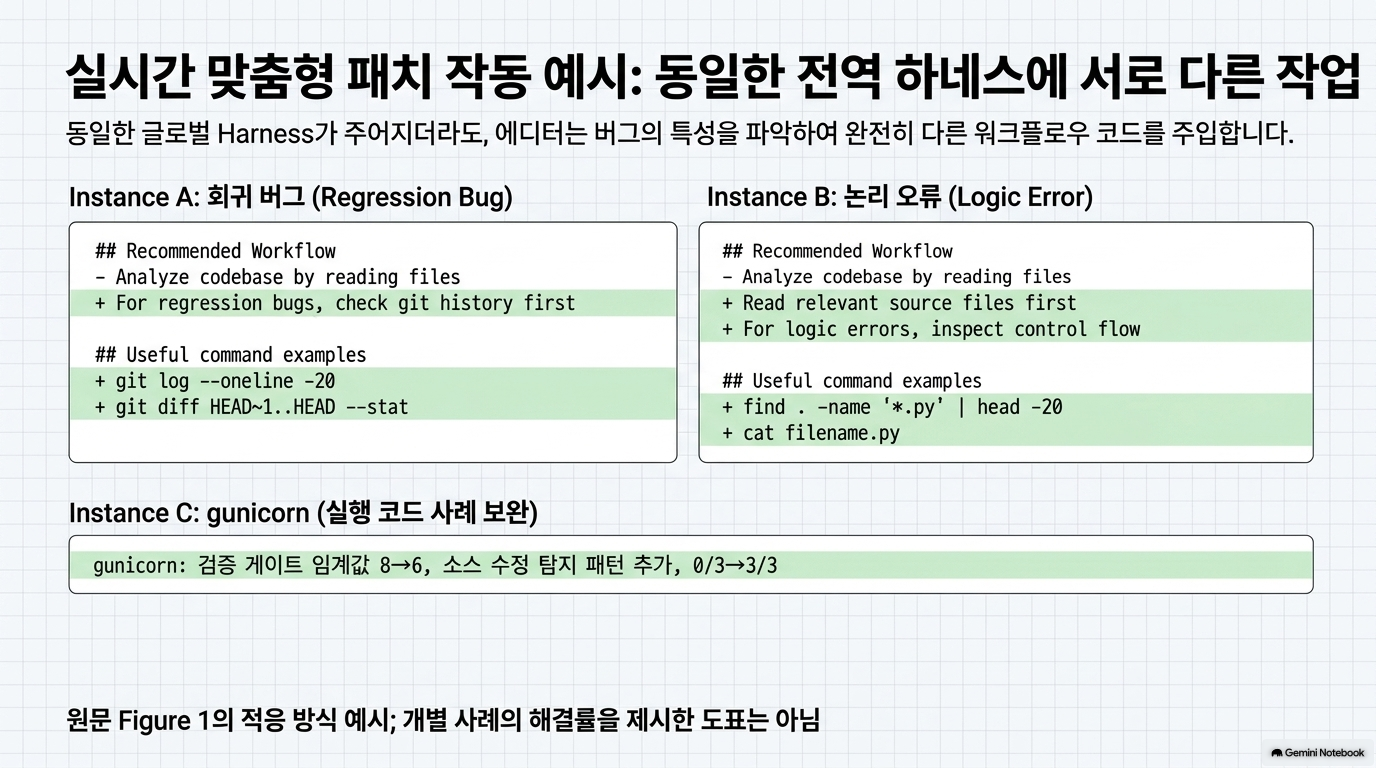
기존 하네스 최적화는 대체로 여러 과제에서 평균 성능이 좋은 하나의 전역 하네스를 산출합니다. 그러나 저장소마다 개발 관행·테스트 방식이 다르고, 단순한 수정과 복잡한 수정이 요구하는 탐색·검증 전략도 다를 수 있습니다.[1]
예를 들어:
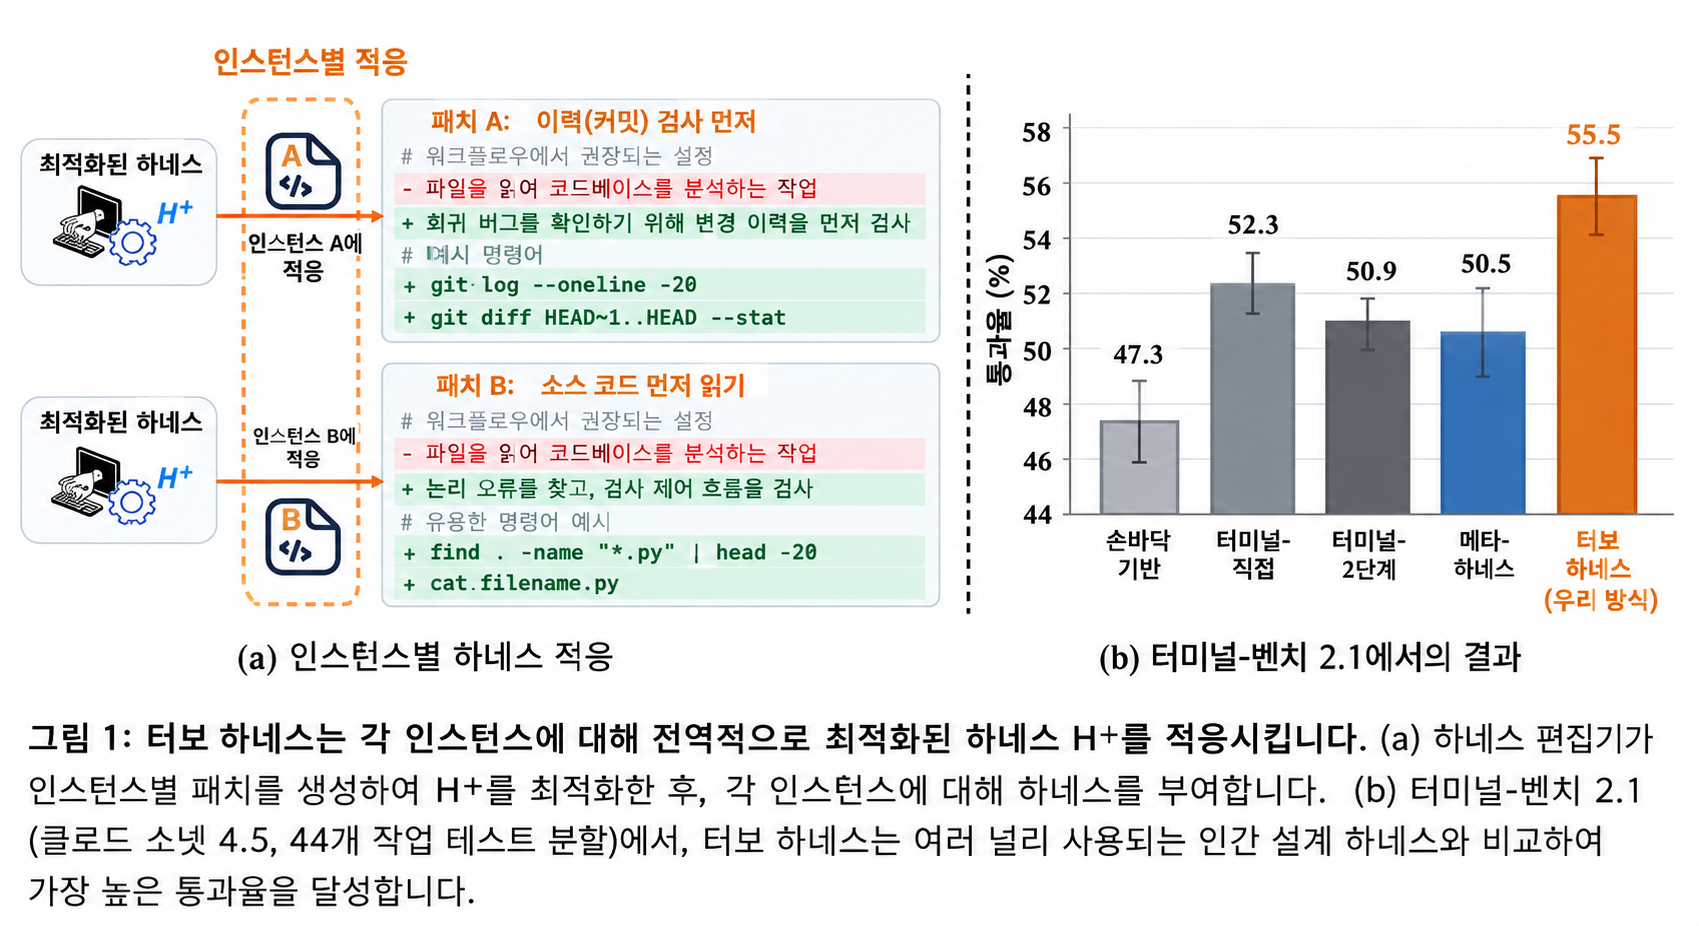
회귀 버그는 변경 이력을 먼저 조사하는 것이 유리할 수 있습니다.
제어 흐름 오류는 관련 소스부터 읽는 것이 유리할 수 있습니다.
쉬운 수정은 짧은 수정–검증 루프로 충분할 수 있습니다.
어려운 수정은 탐색과 검증에 더 많은 단계를 배분해야 할 수 있습니다.[1]
분석:전역 하네스는 서로 다른 과제에 대한 절충안입니다. 논문은 이 절충 과정에서 사라지는 과제별 차이를 다시 회복하려 합니다.
1.3 기존 연구의 한계 ②: 탐색 과정의 경험을 충분히 활용하지 않는다
하네스 최적화 중에는 최종 채택된 후보 외에도 많은 후보와 실행 기록이 생성됩니다. 논문은 이 아카이브에 어떤 조건에서 어떤 수정이 성공하거나 실패했는지에 대한 정보가 남아 있다고 봅니다.[1]
핵심은 실패한 후보도 가치가 있다는 것입니다.
“전체 평균 성능이 낮아 탈락한 수정”이 특정 유형의 과제에서는 유용할 수 있습니다.
따라서 Turbo Harness는 최종 하네스만 보존하지 않고, 탐색 부산물을 조건부 전략과 안티패턴으로 재구성합니다.[1]
1.4 서론의 주장과 검증 범위
저자들은 과제별 적응이 성능을 높이고, 작은 편집 모델을 사용할 수 있으며, 편집 모델을 과제당 한 번만 호출하므로 추론 오버헤드가 작다고 주장합니다.[1]
다만 다음처럼 읽어야 합니다.
성능 개선:뒤의 실험에서 확인할 수 있습니다.
작은 편집 모델:실행 모델보다 작은 9B 모델을 사용했다는 의미입니다.
낮은 총비용:실행 모델 비용 감소만으로 확정할 수 없습니다. 편집·학습·플레이북 구성 비용을 함께 보아야 합니다.
2장. Related Work — 기존 연구와 무엇이 다른가?
원문 p. 3
논문은 관련 연구를 세 범주로 나눕니다.[1]
2.1 프롬프트·컨텍스트 최적화
방법
논문에서 설명하는 역할
GEPA
실행 궤적을 평가하고 프롬프트 후보를 진화
ACE
생성·성찰·큐레이션을 통해 전략 플레이북 축적
MCE
컨텍스트 엔지니어링 스킬과 질의별 컨텍스트 함수를 함께 진화
이 계열의 중심은 모델에 어떤 정보를 제공할 것인가입니다. 반면 하네스 최적화는 정보 제공뿐 아니라 실행 제어 흐름과 검증 메커니즘 등도 수정할 수 있습니다.[1]
분석: Turbo Harness가 ACE의 플레이북 개념을 활용하더라도, 결과물이 단순한 조언 문서에 머무르지 않고 실행 가능한 런타임 패치로 이어질 수 있다는 점이 중요합니다.
2.2 자동 하네스 최적화
Meta-Harness는 강한 외부 코딩 에이전트가 기존 구현·점수·실행 기록을 보고 새로운 하네스를 탐색합니다. Self-Harness는 대상 모델이 실패 패턴을 분석하고 하네스를 수정합니다. 이러한 방식은 여러 과제에 공통 적용할 하네스를 만드는 데 초점을 둡니다.[1]
Turbo Harness는 이 탐색을 대체하기보다 탐색이 끝난 뒤에 추가하는 적응 계층에 가깝습니다.
2.3 적응형 프롬프트·하네스 최적화
비교 대상
Turbo Harness와의 차이
Advisor Models
과제별 프롬프트 최적화에 초점
TTHE
라벨 없는 테스트 배치에서 하네스를 탐색하고 다음 배치에 전달
Harness-R1
초기 실행의 실패 궤적을 수집한 뒤 패치하여 재실행
JIT-Agent
과제별 하네스를 처음부터 생성
Turbo Harness
기존 전역 하네스를 과제 수행 전에 한 번 수정
위 비교는 해당 선행연구를 논문이 설명한 방식에 따른 것입니다.[1]
이 장의 핵심 차별성
“과제별 적응” 자체보다, “이미 확보한 전역 하네스와 탐색 경험을 이용해 한 번의 편집으로 적응한다”는 조합이 핵심입니다.
분석:이는 과제마다 비싼 온라인 탐색을 반복하는 대신, 오프라인 학습에 탐색 비용을 옮기는 접근으로 이해할 수 있습니다.
3장. Preliminaries — 하네스 최적화의 수학적 정의
원문 pp. 3–4
3.1 전역 최적화의 목적함수
논문의 식 (1)은 다음과 같습니다.[1]
기호
의미
고정된 실행 모델
하네스
허용된 하네스 공간
과제 인스턴스
과제 분포
과제 성능 평가 함수
기대 성능을 최대화하는 전역 하네스
뜻은 “실행 모델을 고정하고, 여러 과제에서 평균적으로 가장 좋은 하네스를 찾는다”입니다. 기대값에는 에이전트 실행의 확률적 변동도 포함됩니다.[1]
3.2 Inner loop와 Outer loop
Inner loop:후보 하네스로 과제를 실행해 점수·도구 출력·실패 기록 등을 수집합니다.
Outer loop:이 피드백을 분석해 하네스를 수정하고 다음 후보를 제안합니다.[1]
후보 하네스 → 과제 실행 → 피드백 수집 → 하네스 수정 → 다음 후보
분석
이 장은 다음 장의 전환을 준비합니다.
기존 목표: 과제 분포 전체에 좋은 하나의 하네스
새 목표: 각 과제에 적합한 하네스
단, 목적함수에 argmax가 있다고 해서 실제 알고리즘이 최적해를 보장하는 것은 아닙니다. 논문은 학습된 편집 모델을 이용하는 경험적 방법을 제안하며, 최적성 증명을 제공하지는 않습니다.
4장. Our Method — Turbo Harness의 실제 작동 방식
원문 pp. 4–6
4.1 Instance-Specific Harness Optimization
① 과제별 하네스로 목표를 변경한다
식 (2)는 각 과제
에 대해 좋은 하네스
를 찾는 목표를 제시합니다.[1]
하지만 실제 배포 때 과제마다 여러 하네스를 시험해 최선을 고르지는 않습니다. 학습된 편집 모델이 적합한 패치를 바로 제안합니다.[1]
② 편집 모델의 입력과 출력
편집 모델은 다음 세 가지를 입력받습니다.[1]
과제
전역 하네스의 소스 코드
전략 플레이북
출력은 패치
이며 다음처럼 적용됩니다.[1]
중요:편집 모델은 버그의 최종 수정안을 직접 만드는 역할과 구분됩니다. 버그를 수정할 실행 모델의 작업 방식을 바꾸는 것이 주된 역할입니다.
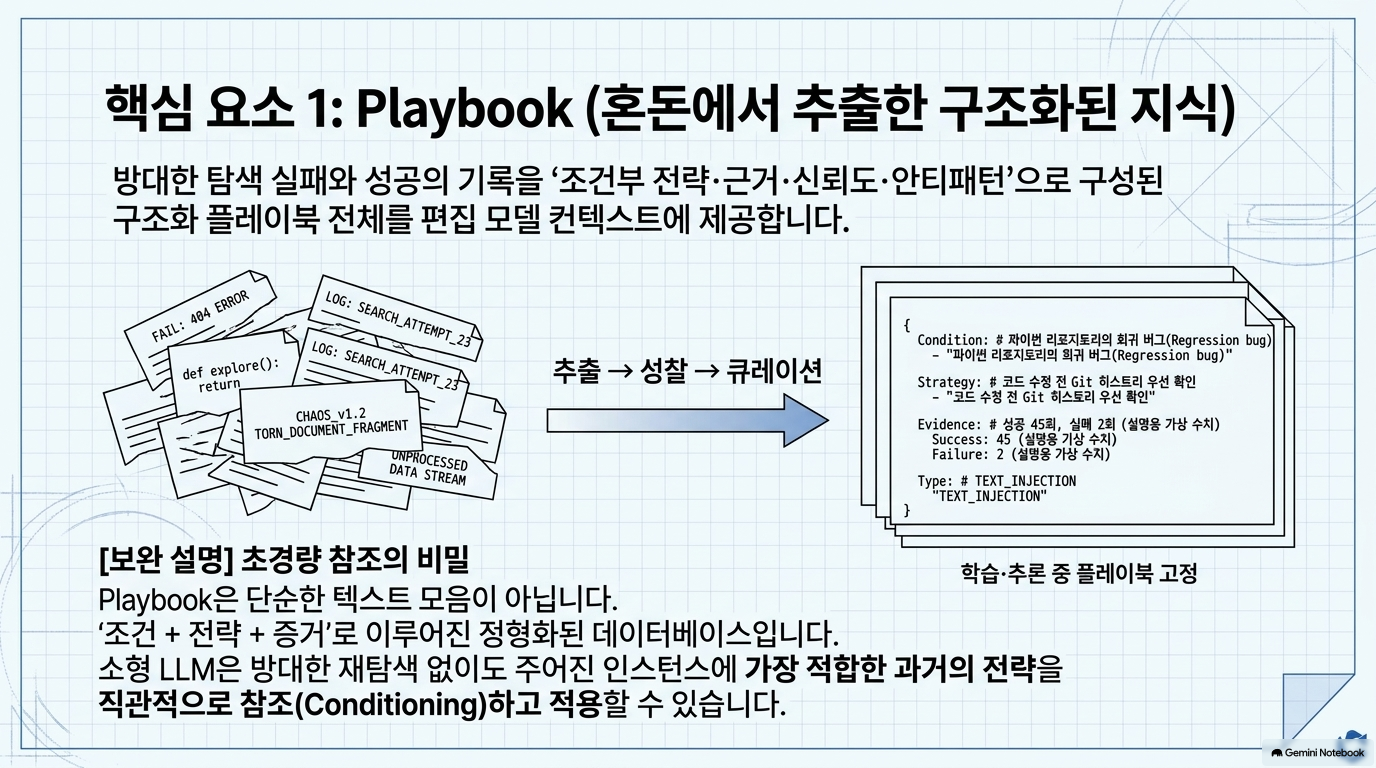
③ 플레이북은 고정된 조건부 경험집이다
플레이북에는 성공한 수정뿐 아니라 실패한 수정과 적용 조건도 포함됩니다. 학습 및 추론 중에는 플레이북을 고정하며, 전체 플레이북을 편집 모델의 컨텍스트에 넣습니다.[1]
따라서 이 구현은:
과제마다 관련 전략을 외부 검색하는 RAG 방식이 아니고,
배포 중 플레이북을 계속 갱신하는 온라인 학습 방식도 아닙니다.[1]
분석:학습의 중심은 “새 전략을 무한히 발명하기”보다 주어진 과제에 맞는 경험을 선택하고 적용하기에 있습니다. 다만 패치 출력이 사전 정의된 전략 선택만으로 제한된다는 뜻은 아닙니다.
4.2 Training a Harness Editor
① 한 과제에 여러 후보 패치를 생성한다
학습 때는 과제별로
개의 후보 패치를 생성하고, 각 패치를 적용한 하네스로 실행 모델을 돌려 보상을 계산합니다.[1]
동일한 과제 x
├─ 패치 1 → 실행 → 보상 1
├─ 패치 2 → 실행 → 보상 2
└─ 패치 G → 실행 → 보상 G
↓
편집 모델 업데이트
적용할 수 없거나 검증을 통과하지 못한 패치는 실행하지 않고 보상 0을 부여합니다.[1]
② GRPO로 좋은 패치의 생성 확률을 높인다
GRPO 목적함수는 동일 과제의 후보들 사이에서 상대적으로 좋은 보상을 얻은 패치를 선호하도록 편집 모델을 학습합니다. 확률비 클리핑과 초기 편집 모델에 대한 KL 페널티를 사용하며, 실행 모델
은 계속 고정됩니다.[1]
분석:여기서 학습되는 것은 “답변 문장을 잘 생성하는 능력”이 아니라, 다른 모델의 실제 실행 성과를 높이는 하네스 수정 능력입니다. 따라서 보상 계산에 실제 환경 실행이 필요하고, 이것이 학습 비용의 주요 원인이 됩니다.
③ 추론은 한 번의 편집 호출로 끝난다
배포 시 흐름은 다음과 같습니다.[1]
편집 모델이 패치 하나 생성
전역 하네스에 적용
수정된 하네스로 실행 모델이 과제 수행
패치 적용 실패 시 전역 하네스로 복귀
이 장의 평가
강점
기존 최적화 자산을 재사용합니다.
실행 모델을 재학습하지 않습니다.
과제마다 다중 후보 탐색을 반복하지 않습니다.
적용 실패 시 기본 하네스로 돌아가는 경로가 있습니다.[1]
[확인 필요: §4.2]
패치가 적용되고 형식 검증을 통과했다는 사실은 의미적으로 올바르거나 안전하다는 보장과 다릅니다. 잘못된 검증 시점이나 과도한 도구 호출 정책도 실행 가능한 패치일 수 있으므로, 운영에서는 별도 의미·정책 검증이 필요합니다.
5장. Experiments — 성능과 효율성은 얼마나 개선되는가?
원문 pp. 6–9
5.1 Experimental Setup — 실험 조건
벤치마크와 실행 모델
영역
벤치마크
지표
실행 모델
생활 과제 수행
ALFWorld
성공률
Qwen3.5-9B
과학 실험 절차
ScienceWorld
평균 점수, 0~100
Qwen3.5-9B
데이터베이스 질의
DBBench
정확도
Qwen3.5-9B
상품 탐색·구매
WebShop
Success@1
Qwen3.5-9B
다중 저장소 버그 수정
SWE-smith-MR
해결률
Haiku 4.5 / Gemini 3.7 Flash
실제 GitHub 이슈 수정
SWE-bench Verified 부분집합
해결률
Haiku 4.5 / Gemini 3.7 Flash
장기 터미널 작업
Terminal-Bench-2.1
통과율
Sonnet 4.5
편집 모델은 모든 설정에서 Qwen3.5-9B이며, 플레이북과 편집 모델 학습은 벤치마크·실행 모델별로 구성합니다.[1]
결과 해석에 중요한 제약
코딩 실험은 이슈당 40단계·3달러 제한입니다. SWE-bench Verified는 전체 500개가 아니라 분리된 테스트 150개를 사용합니다.[1]
따라서 이 실험은 일반적인 리더보드 성능보다 제한된 예산 안에서 하네스가 얼마나 효과적으로 작동하는지를 평가하는 성격이 강합니다.
[확인 필요: §5.1·부록 B.5] 이 해결률을 전체 SWE-bench Verified 리더보드 수치와 직접 비교해서는 안 됩니다.
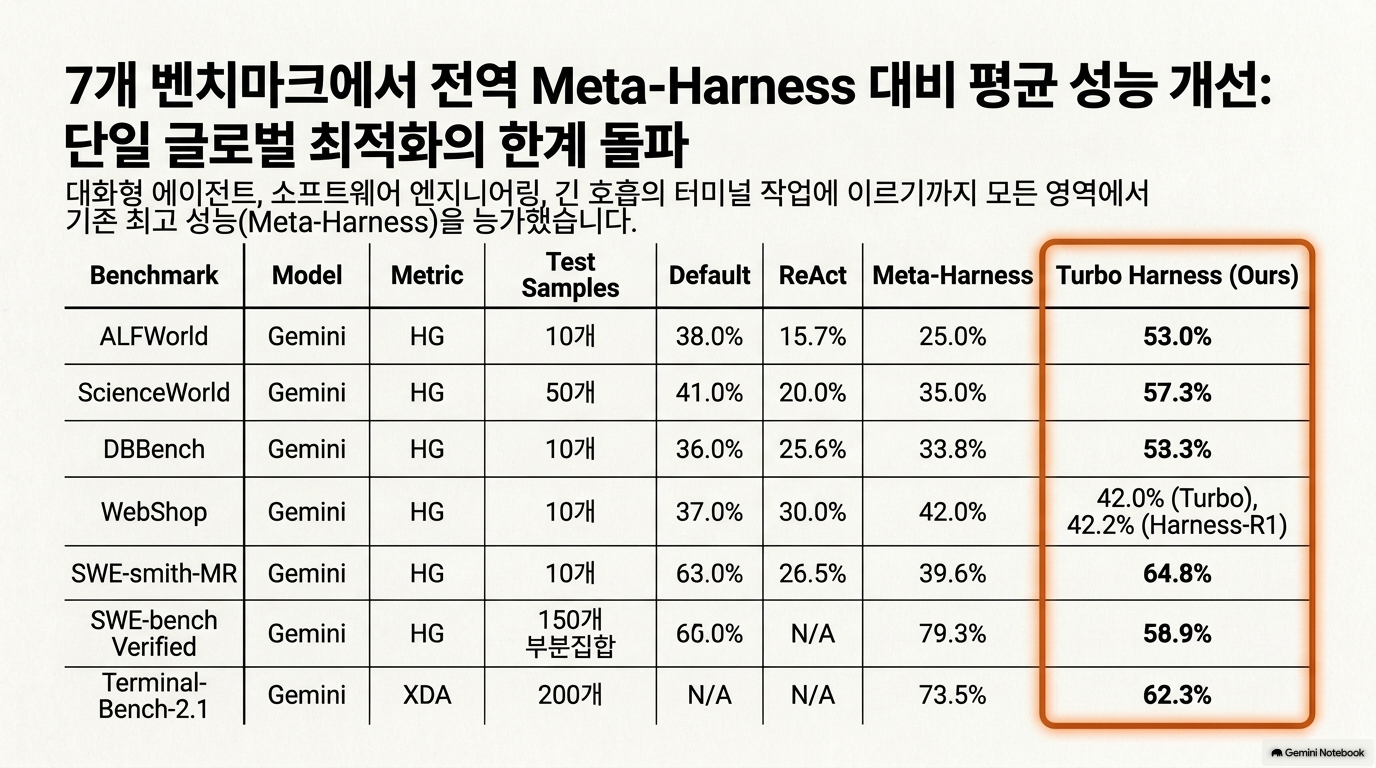
5.2 Task Performance — 과제 성능
A. 상호작용형 에이전트 결과
방법
ALFWorld 성공률
ScienceWorld 점수
DBBench 정확도
WebShop Success@1
Default
40.7%
25.7
57.5%
34.5%
ReAct
60.7%
26.7
55.8%
33.5%
Self-Refine
40.7%
21.3
53.3%
18.5%
Reflection
50.0%
38.2
60.8%
41.0%
Harness-R1
54.0%
28.2
60.0%
42.2%*
Meta-Harness
60.7%
35.1
65.0%
40.0%
Turbo Harness
70.7%
42.4
69.2%
42.0%
*Harness-R1의 WebShop 결과는 저자 보고값을 사용합니다. 원문 Table 1 기준입니다.[1]
분석
Meta-Harness 대비 네 과제 모두 개선됩니다. ALFWorld +10.0%p, ScienceWorld +7.3점, DBBench +4.2%p, WebShop +2.0%p입니다.[1]
모든 비교 방법을 항상 이긴 것은 아닙니다. WebShop에서는 Harness-R1의 42.2%가 Turbo의 42.0%보다 수치상 높습니다.[1]
자기 성찰을 추가한다고 자동으로 좋아지지 않습니다. Self-Refine은 여러 설정에서 Default보다 낮습니다. 이 결과는 적어도 해당 구현과 예산에서 성찰 절차가 성능 향상을 보장하지 않음을 보여줍니다.[1]
표의 평균은 단일 성공률이 아닙니다.성공률·정확도·부분점수처럼 서로 다른 지표의 동일 가중 평균이므로, “전체 과제 성공률 56.1%”로 읽으면 안 됩니다.[1]
B. 코딩 벤치마크 결과
벤치마크
실행 모델
Meta-Harness
Turbo Harness
개선 폭*
SWE-smith-MR
Haiku 4.5
50.7 ± 2.9%
64.0 ± 1.2%
+13.3%p
SWE-smith-MR
Gemini 3.7 Flash
70.7 ± 2.4%
88.0 ± 1.2%
+17.3%p
SWE-bench Verified 부분집합
Haiku 4.5
56.7 ± 2.0%
59.3 ± 1.4%
+2.6%p
SWE-bench Verified 부분집합
Gemini 3.7 Flash
38.4 ± 0.4%
54.4 ± 2.3%
+16.0%p
각 값은 3회 실행 평균 ± 평균의 표준오차(SEM)입니다.[1] *개선 폭은 표에 표시된 반올림 수치로 계산했습니다. 원문 본문은 Verified–Haiku 개선을 +2.7%p로 서술하지만, 표시값의 차이는 +2.6%p입니다.
분석
가장 큰 개선은 SWE-smith-MR–Gemini 설정에서 나타납니다.
Verified–Haiku 설정은 평균 개선 폭이 작습니다.
저자들은 기존 전역 하네스가 이미 개선 여지를 많이 소진한 설정에서는 추가 적응의 효과가 작다고 해석합니다.[1]
다만 “남은 개선 여지 때문에 효과 차이가 발생했다”는 것은 저자의 설명이지, 별도 통제 실험으로 확정된 인과관계는 아닙니다.과제 특성과 모델–하네스 조합 등도 영향을 줄 수 있습니다.
5.3 Execution Efficiency — 실행 비용과 단계 수
설정
평균 단계: Meta → Turbo
실행 모델 비용: Meta → Turbo
비용 변화*
SWE-smith-MR / Haiku
18.5 → 17.3
$0.151 → $0.136
−9.9%
SWE-smith-MR / Gemini
23.1 → 8.7
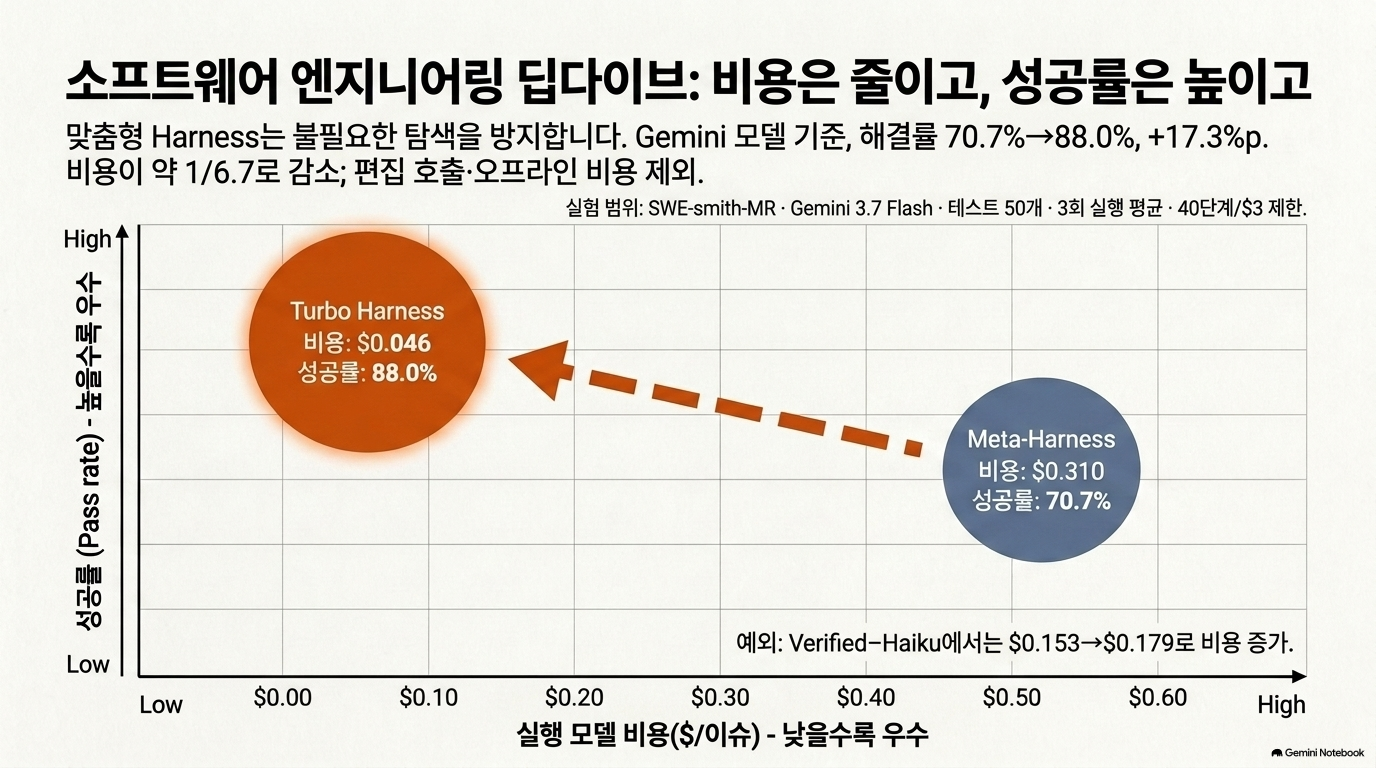
$0.310 → $0.046
−85.2%
Verified / Haiku
18.8 → 20.4
$0.153 → $0.179
+17.0%
Verified / Gemini
32.5 → 25.9
$0.470 → $0.331
−29.6%
원자료는 Table 2이며, 비용 변화율은 표시값으로 계산했습니다.[1]
핵심 해석
성능 향상과 실행 비용 감소가 동시에 발생하는 설정이 있지만, 항상 그런 것은 아닙니다.
특히 Verified–Haiku는 해결률이 조금 높아지는 대신 단계 수와 비용이 증가합니다. 따라서 이 방법을 보편적인 비용 절감 기법으로 소개하면 과장입니다.
가장 중요한 비용 경계
논문은 Table 2 비용이 실행 모델 비용만 포함하며 다음 비용은 제외한다고 명시합니다.[1]
전역 하네스 최적화
플레이북 구성
편집 모델 학습
과제당 편집 모델 호출
실무 분석:총비용은 다음처럼 평가해야 합니다.
[보완 필요: §5.3·Table 2] “실행 모델 API 비용이 감소했다”와 “전체 시스템 비용이 감소했다”를 분리해 보고해야 합니다.
5.4 Long-Horizon Terminal Tasks — 장기 터미널 작업
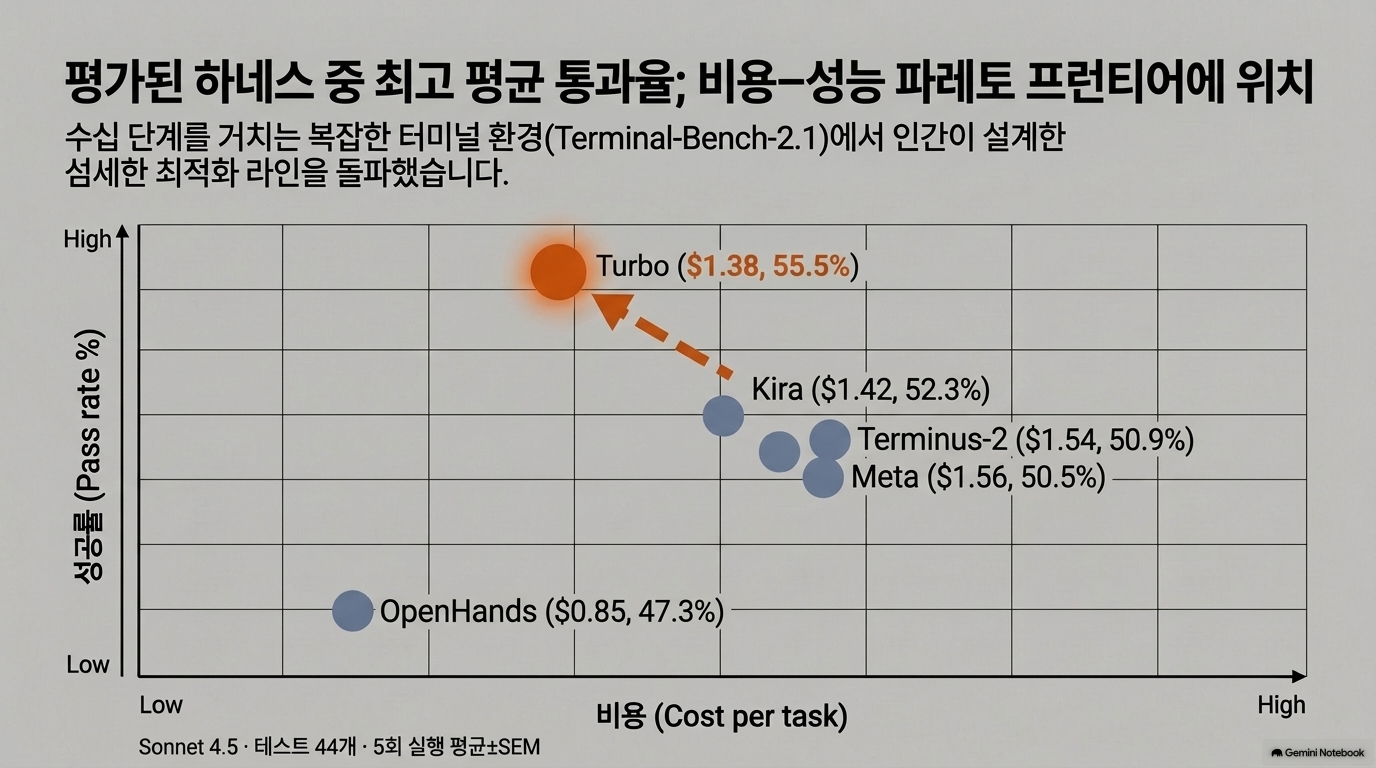
하네스
통과율
평균 턴
과제당 비용
입력 토큰
OpenHands
47.3 ± 1.5%
54.4
$0.85
1.55M
Terminus-Kira
52.3 ± 1.1%
72.2
$1.42
2.76M
Terminus-2
50.9 ± 0.8%
75.2
$1.54
3.00M
Meta-Harness
50.5 ± 1.7%
76.3
$1.56
3.15M
Turbo Harness
55.5 ± 1.4%
71.2
$1.38
2.65M
44개 테스트 과제, 5회 실행 결과입니다.[1]
이 실험이 중요한 이유
이 설정에서는 전역 최적화된 Meta-Harness가 인간 설계 하네스보다 좋지 않습니다. 그럼에도 과제별 적응을 추가한 Turbo는 가장 높은 평균 통과율을 기록합니다.[1]
즉, 전역 탐색의 최종 결과가 최고가 아니더라도 그 과정의 경험에는 활용 가치가 있을 수 있다는 주장에 힘을 줍니다.
파레토 프런티어 해석
Turbo는 비교 대상 중 최고 통과율이지만 최저 비용은 아닙니다. OpenHands가 더 저렴합니다.[1]
따라서:
높은 통과율을 중시하면 Turbo가 유리하고,
더 낮은 비용을 우선하면 OpenHands도 선택지가 됩니다.
이것이 논문의 정확도–비용 파레토 프런티어 주장에 대한 적절한 해석입니다.
5.5 Ablation Studies — 무엇이 성능 향상을 만드는가?
A. 강화학습과 플레이북의 결합
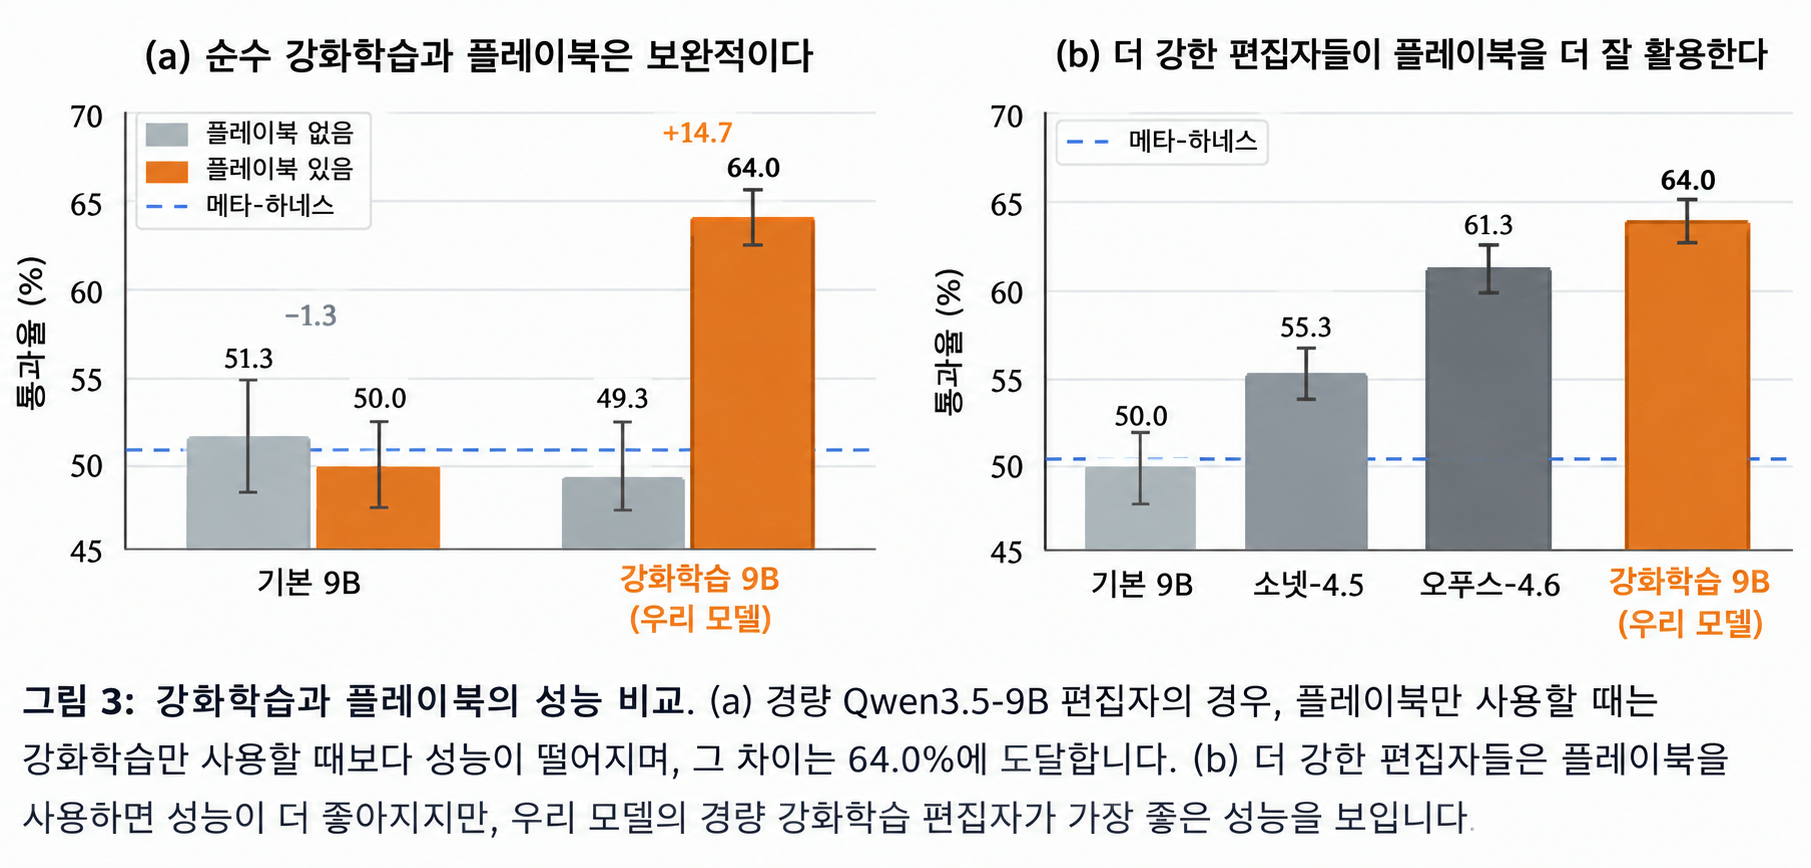
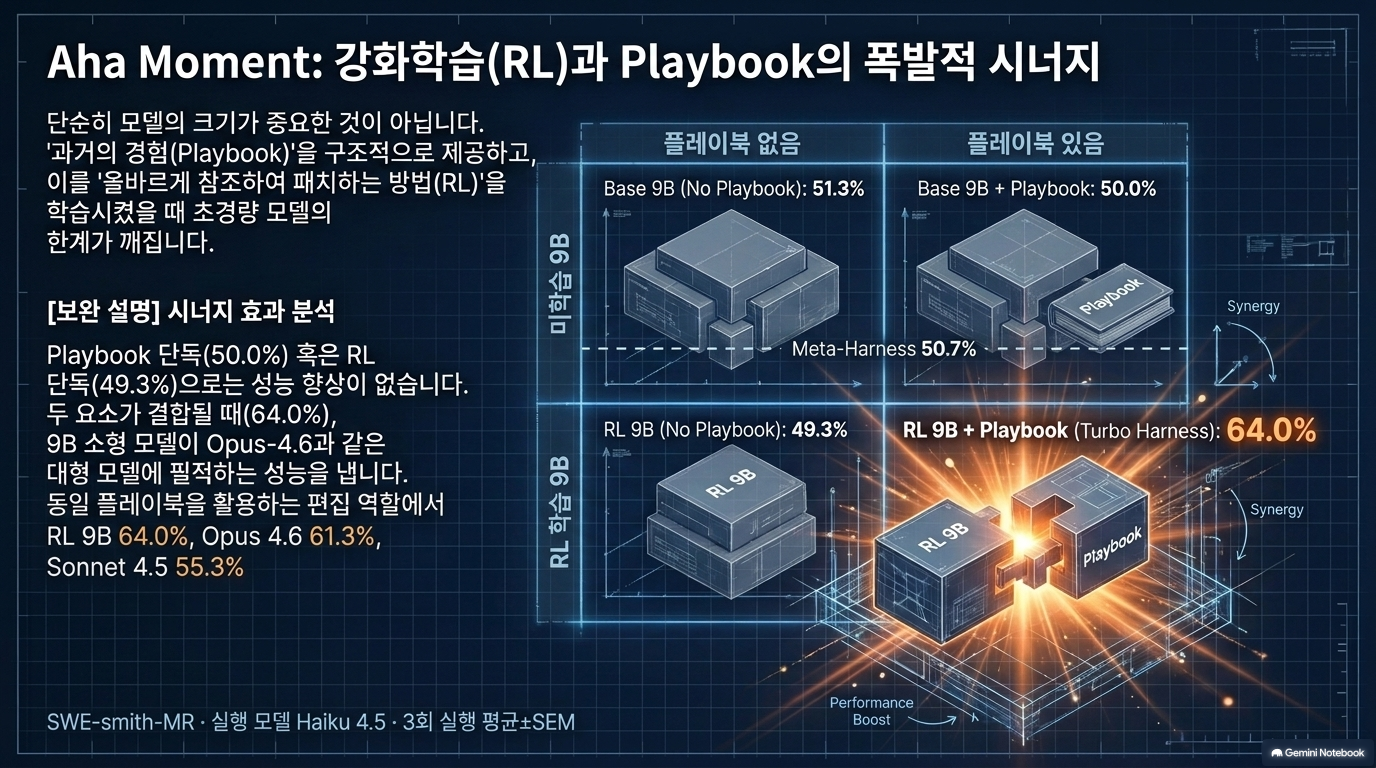
SWE-smith-MR, 실행 모델 Haiku 4.5 설정입니다.[1]
편집 모델 구성
해결률
전역 Meta-Harness, 과제별 편집 없음
50.7%
미학습 9B 편집 모델, 플레이북 없음
51.3%
미학습 9B 편집 모델 + 플레이북
50.0%
RL 학습 9B 편집 모델, 플레이북 없음
49.3%
RL 학습 9B 편집 모델 + 플레이북
64.0%
핵심:작은 모델에 플레이북만 제공하거나 RL만 적용하는 것으로는 큰 개선이 나타나지 않습니다. 플레이북을 활용하도록 학습하는 결합에서 개선이 나타납니다.[1]
분석:경험을 저장하는 것과 경험을 적절히 활용하는 것은 별개입니다. 이 논문은 그 사이의 간극을 편집 모델의 강화학습으로 메우려 합니다.
B. 편집 모델의 능력 차이
동일 플레이북을 사용하는 경우입니다.[1]
편집 모델
해결률
미학습 Qwen3.5-9B
50.0%
Sonnet 4.5
55.3%
Opus 4.6
61.3%
RL 학습 Qwen3.5-9B
64.0%
이 결과는 작은 모델도 특정 편집 역할에 맞게 학습하면 강한 범용 모델과 경쟁할 수 있다는 근거입니다.[1]
다만 9B 모델의 범용 능력이 Opus보다 높아졌다는 뜻은 아닙니다.해당 과제·플레이북·편집 역할에 한정된 결과입니다.
또한 이 절제 실험은 하나의 코딩 설정에 집중되어 있으므로, 같은 결합 효과가 모든 도메인에서 동일하게 나타난다고 단정할 수는 없습니다.
6장. Conclusion, Limitations, and Future Work
원문 pp. 9–10
6.1 결론
논문은 전역 하네스 탐색의 중간 산출물을 버리는 대신 재사용 가능한 경험으로 전환하고, 이를 활용한 과제별 하네스 적응이 성능을 높이며 경우에 따라 실행 비용도 줄인다고 결론짓습니다.[1]
6.2 저자가 명시한 한계
한계 ①: 원래 탐색 아카이브의 품질에 의존한다
초기 탐색이 약한 전략만 시도했거나 유용한 경험이 부족하다면 과제별 적응의 효과도 제한될 수 있습니다.[1]
분석:이는 “좋은 학습 데이터가 있어야 좋은 모델이 나온다”를 넘어, 다양한 성공·실패 조건을 관찰해야 좋은 적응 정책이 나온다는 문제입니다.
한계 ②: 편집 모델 학습에도 추가 실행 비용이 든다
후보 패치를 실제 환경에서 평가해야 하므로, 에이전트 과제에서 학습 비용이 커질 수 있습니다.[1]
분석: “작은 편집 모델”이라는 표현은 배포 모델의 크기를 설명할 뿐, 학습 전체가 저비용임을 의미하지 않습니다.
6.3 미래 연구
저자들은 다음을 제안합니다.[1]
더 샘플 효율적인 학습
기존 실행 데이터의 재사용
과제·도메인·하네스 탐색 실행 간 편집 모델과 플레이북의 전이
중요:범용 전이 능력은 이 논문에서 입증한 성과가 아니라 향후 연구 과제입니다.
부록 A. Benchmarks and Data Splits — 일반화 범위
원문 pp. 14–15
A.1 벤치마크 성격
부록은 각 과제가 하네스에 민감한 이유를 설명합니다. ScienceWorld는 실험 절차와 focus 행동의 시점, DBBench는 SQL 실행과 최종 답안 제출, 코딩 과제는 탐색·수정·검증·제출 절차가 중요합니다.[1]
분석:하네스 적응은 단순 지식 문제보다 행동 순서와 실행 제어가 성패를 좌우하는 과제에서 더 직접적인 의미가 있습니다.
A.2 데이터 분할
벤치마크
학습
검증
테스트
ALFWorld
100
169
150
ScienceWorld
120
60
149
DBBench
120
60
120
WebShop
120개 후보 중 65개로 편집 모델 학습
60
200
SWE-smith-MR
50
없음
50
SWE-bench Verified
251
99
150
Terminal-Bench-2.1
45
별도 분할 미기재
44
원문 부록 A.2 및 B.2 기준입니다.[1]
가장 중요한 일반화 제약
코딩 벤치마크는 이슈 단위 분할입니다. 학습과 테스트에 같은 저장소가 포함됩니다.[1]
따라서 입증된 것은:
선택된 저장소에서 보지 않은 이슈에 대한 적응
이지,
전혀 보지 않은 저장소에 대한 일반화
가 아닙니다.
A.3 SWE-smith-MR의 구성 의도
25개 Python 저장소에서 저장소당 학습 이슈 2개와 테스트 이슈 2개를 뽑아 저장소별 가중치를 동일하게 맞춥니다. 서로 다른 구조·테스트 관행에서 과제별 적응이 유용한지 확인하려는 설계입니다.[1]
분석:저장소 다양성을 고려한 장점은 있지만, 테스트 이슈 수가 작고 저장소는 공유하므로 효과 크기의 외삽에는 주의가 필요합니다.
부록 B. Training and Evaluation Protocol — 실제 재현에 필요한 내용
원문 pp. 15–17
B.1 플레이북 구성: 추출 → 성찰 → 큐레이션
1단계: 경험 추출
과제별로 여러 하네스의 결과와 실행 궤적을 모아 다음처럼 분류합니다.[1]
일부 하네스는 성공하고 일부는 실패
모두 성공
모두 실패
성공·실패가 갈리는 과제에서는 서로 다른 성공·실패 하네스의 소스 차이도 계산합니다.[1]
2단계: 강한 모델의 성찰
강한 모델이 다음을 구조화합니다.[1]
과제의 특징
하네스별 행동 차이
후보 편집 전략
이유
신뢰도 점수
3단계: 큐레이션
유사 전략을 통합하고 도움·유해 증거를 집계합니다. 순효과가 해로운 전략은 안티패턴으로 정리하며, 모호하거나 지나치게 특정적인 전략은 걸러냅니다.[1]
전략 유형은 다음으로 구분됩니다.[1]
SCAFFOLD_MODIFICATION: 실행 제어 코드 수정
TEXT_INJECTION: 모델에 제공하는 정보 수정
TB2.1 플레이북은 전략 6개와 안티패턴 9개로 구성됩니다.[1]
분석상 주의점
플레이북의 confidence는 모델이 생성한 판단 점수입니다. 독립적으로 측정된 전략 정확도나 성공 확률과 동일하지 않습니다.
또한 성공·실패 하네스의 차이와 실행 결과를 함께 분석하는 것은 유용하지만, 여러 변경과 실행의 확률성이 섞여 있다면 특정 변경 하나의 인과효과가 완전히 분리되는 것은 아닙니다.
B.2 편집 모델 학습
모든 편집 모델은 FSDP를 사용한 전체 파라미터 미세조정이며 LoRA 방식이 아닙니다. 기본 학습률은 , KL 계수는 , 설정별 GPU 수는 4개 또는 8개입니다.[1]
분석:배포 시 9B 모델을 쓰는 것은 비교적 가볍지만, 학습 인프라까지 개인용 단일 GPU 수준이라고 해석하면 안 됩니다.
WebShop은 부분점수 과제 65개를 선별하고, 그룹 내 보상 표준편차로 나누는 절차를 끄며 별도 보상 구성을 사용합니다.[1]
[보완 필요: Table 4 캡션·B.2] Table 4 캡션은 보너스·기권 페널티 사용 여부가 모호하게 읽히지만, B.2 본문과 B.3은 이를 사용한다고 설명합니다. 재현 시 실제 설정 파일과 대조할 필요가 있습니다.
B.3 보상 함수
코딩 과제가 해결되면 보상은 다음과 같습니다.[1]
실패하면 0입니다.[1]
계산 예시는 다음과 같습니다.
성공 시 실행 단계
보상
8
0.90
20
0.75
40
0.50
분석:성공을 우선하면서 빠른 해결을 추가로 선호하는 구조입니다. 따라서 실행 단계 감소는 우연히 관찰된 효과일 뿐 아니라 학습 목표에도 반영된 결과입니다.
일부 비코딩 과제에서는 수정하지 않겠다는 명시적 기권에 0.05 페널티를 적용합니다.[1]
운영 시사점:실제 업무에서는 “수정하지 않는 것이 더 안전한 경우”도 있으므로, 기권 페널티를 그대로 적용하기보다 무수정·안전성·성공률의 균형을 별도 검증해야 합니다.
보상 조작 방지
과제 결과는 편집된 하네스 밖에서 계산합니다. 평가 함수 접근을 제한하고, 보호된 평가 내부에 대한 참조를 소스 검사로 차단하며, 코딩 과제는 부모 프로세스가 제출 패치를 채점합니다.[1]
이는 중요한 설계입니다. 다만 저자들도 보상 조작 기회를 줄인다고 표현하며, 모든 우회 가능성을 제거했다고 주장하지는 않습니다.
B.4 체크포인트 선택
벤치마크별로 최종 체크포인트 또는 검증 성능을 사용합니다. Verified–Haiku에서는 검증 해결률이 가장 높은 체크포인트가 정책 엔트로피 붕괴 때문에 제외됩니다.[1]
분석:가장 높은 검증 점수를 무조건 선택하지 않고 학습 안정성 진단을 반영한 점은 의미가 있습니다. 재현에는 성능뿐 아니라 엔트로피와 제외 규칙도 필요합니다.
B.5 평가와 오차막대
코딩 실험은 이슈별 하네스를 한 번 생성한 뒤 3회 실행에 재사용합니다. SEM은 반복 실행 사이의 변동을 나타내며, 편집 모델 학습 시드나 데이터 분할 변동은 평가하지 않습니다. 상호작용형 네 벤치마크는 각각 한 번 평가합니다.[1]
[확인 필요: B.5] 작은 SEM을 전체 파이프라인의 재현성이나 통계적 우월성 보장으로 읽으면 안 됩니다. 고정된 학습 결과·분할·하네스에서 실행이 얼마나 변하는지를 보여주는 수치입니다.
부록 C. Baseline Details — 비교 공정성
원문 pp. 17–18
C.1 Default
코딩 Default는 mini-swe-agent의 기본 설정을 사용하고, 다른 코딩 방법과 동일한 40단계·3달러 제한을 적용합니다.[1]
C.2 프롬프트 기반 방법
ReAct: 추론–행동 예시와 Thought 생성
Self-Refine: 행동 전 제안–비평–수정
Reflection: 실패 시 성찰 후 두 번째 실행, 두 실행 중 더 좋은 결과 보고[1]
Turbo는 단일 실행인데 Reflection은 두 번의 시도를 사용할 수 있으므로, 방법별 호출·실행 예산이 동일하지 않습니다.[1]
C.3 Harness-R1
Harness-R1은 일부 과제에서 다른 런타임을 사용하고, 초기 실행 후 패치 재실행을 수행합니다. ScienceWorld는 저자들이 별도로 이식하고 학습한 버전입니다.[1]
분석: Harness-R1 비교는 실용적 성능 참고로는 유효하지만, 편집 알고리즘만 바꾼 완전 통제 비교는 아닙니다. 가장 직접적인 비교는 같은 출발점의 Meta-Harness 대비 추가 효과입니다.
부록 D. Additional Results and Analyses — 일관성과 패치 사례
원문 pp. 18–20
D.1 반복 실행의 일관성
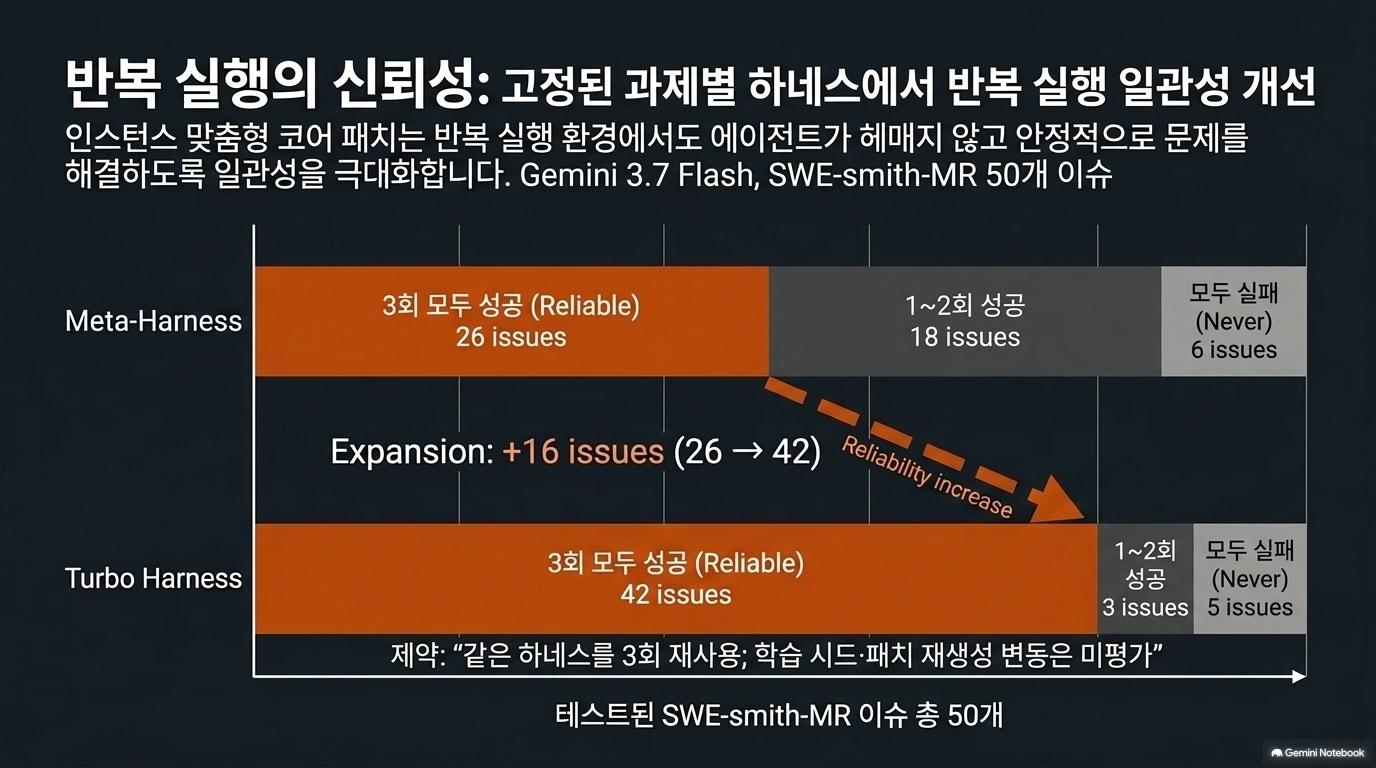
SWE-smith-MR의 50개 테스트 이슈 중 세 번 모두 해결한 이슈 수입니다.[1]
실행 모델
Meta-Harness
Turbo Harness
Haiku 4.5
20개
28개
Gemini 3.7 Flash
26개
42개
평균 해결률 개선과 함께 반복적으로 해결되는 이슈도 증가합니다.[1]
다만 이는 고정된 과제별 하네스의 실행 일관성이며, 다시 학습하거나 다시 패치를 생성해도 동일하다는 뜻은 아닙니다.
D.2 실제 패치 사례
사례 ① Jinja2 회귀 버그
변경 이력을 먼저 확인하도록 안내를 추가한 사례입니다. 같은 전역 하네스라도 다른 라이브러리의 문제에는 다른 안내를 적용합니다.[1]
의미:하나의 조사 순서를 모든 버그에 강제하지 않습니다.
사례 ② django-13315의 단계 예산 재배분
단계
전역 하네스
과제별 수정
이해
5~10단계
10~15단계
수정
1단계
5~10단계
마무리·제출
즉시 제출, 1단계
5~10단계
해결 결과는 1/3에서 3/3으로 개선됩니다. 반면 sympy-16766은 수정 단계만 늘리고 제출 단계는 유지합니다.[1]
의미:과제별 적응은 단순히 모든 예산을 늘리는 것이 아니라 필요한 단계에 재배분하는 것입니다.
사례 ③ gunicorn의 실행 코드 수정
검증 관련 게이트의 임계값을 8에서 6으로 변경하고, 소스 수정 탐지에 추가 리다이렉션 패턴을 포함합니다. 해당 이슈는 0/3에서 3/3으로 개선됩니다.[1]
의미:이 방법은 프롬프트 문구만 바꾸는 것이 아니라 실제 제어 코드도 수정합니다.
사례 ④ 강제 도구 호출의 상반된 효과
chess-best-move에서는 매 턴 도구 호출을 강제하는 변경이 유용하지만, 다른 과제에서는 같은 정책이 불리할 수 있습니다.[1]
[확인 필요: D.2] 이 터미널 사례는 테스트에서 생성된 Turbo 패치가 아니라 학습 과제의 전역 탐색 단계 사례입니다. TB2.1의 과제별 테스트 패치가 저장되지 않았기 때문에 메커니즘 설명용으로 제시됩니다.[1]
종합 평가: 무엇을 입증했고, 무엇이 남았는가?
1. 비교적 강하게 뒷받침되는 결론
평가된 설정에서 과제별 적응은 전역 Meta-Harness보다 높은 평균 성능을 보입니다.[1]
작은 편집 모델에서는 플레이북과 RL의 결합이 중요한 역할을 합니다.[1]
일부 코딩 설정에서는 성능 향상과 실행 모델 비용 감소가 동시에 발생합니다.[1]
패치 대상은 텍스트 안내뿐 아니라 실행 제어 코드까지 포함됩니다.[1]
2. 아직 입증되지 않은 결론
주장
남은 검증
전체 시스템 비용이 더 저렴하다
편집·학습·최적화 비용을 포함한 총비용
모든 과제에서 효율적이다
비용 증가 설정 및 효과가 작은 설정 분석
보지 않은 저장소에도 잘 일반화한다
저장소 단위 홀드아웃
하나의 편집 모델이 범용적으로 작동한다
도메인·실행 모델 간 전이
자동 런타임 수정이 안전하다
의미 검증·권한 경계·공격 평가
전체 파이프라인이 안정적으로 재현된다
학습 시드·분할·패치 생성 반복 실험
위 구분은 논문의 실험 범위와 부록의 평가 제약에 근거한 분석입니다.[1]
3. 공공 AI·업무 에이전트에 적용할 때의 시사점
아래는 논문 자체의 검증 결과가 아니라 운영·감리 관점의 권고입니다.
우선순위
적용 항목
권고
높음
변경 가능 범위
프롬프트·탐색 예산과 권한·감사·검증 코드를 분리
높음
검증 독립성
편집 대상 밖에 최종 검증기를 유지
높음
추적성
기본 하네스·플레이북·편집 모델 버전과 실제 패치를 기록
높음
비용 평가
실행 모델 비용과 총비용을 함께 보고
중간
일반화
새로운 저장소·업무 유형·기관 데이터에서 별도 검증
중간
무수정 정책
안전한 기권과 불필요한 편집의 균형을 평가
후순위
범용화
도메인별 효과가 확인된 뒤 편집 모델 통합 검토
특히 에이전트가 자신의 실행 방식을 수정하더라도 권한·승인·감사 경계까지 수정하게 해서는 안 됩니다.과제별 적응의 유연성과 운영 통제의 불변성을 분리하는 것이 중요합니다.
최종 판단
이 논문의 핵심 기여는 “더 좋은 전역 하네스 하나”가 아니라, “전역 최적화 경험을 과제별 실행 정책으로 바꾸는 학습 구조”입니다.
성능 결과는 유망하며, 성공 경험뿐 아니라 실패한 탐색 후보까지 재사용한다는 점이 실무적으로 가치가 있습니다. 다만 도입 판단은 제한된 예산에서의 성능 개선, 총비용, 새로운 업무에 대한 일반화, 런타임 변경의 통제 가능성을 분리해 내려야 합니다.