LLM - XiaomiMiMo, System Card: MiMo-V2.6-Pro-RL
https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL/blob/main/MiMo_V2_6_technical_report.pdf
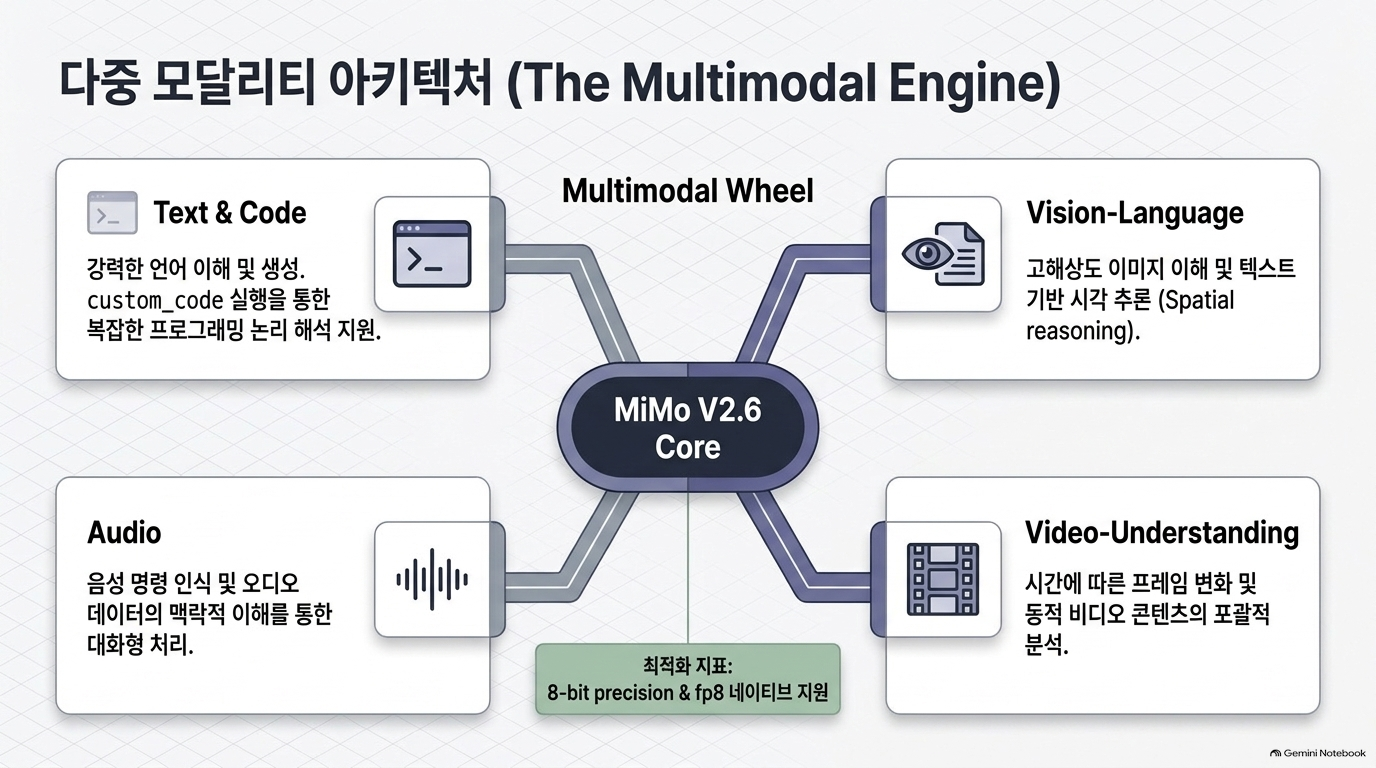
2026.9.22
[MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvemen]
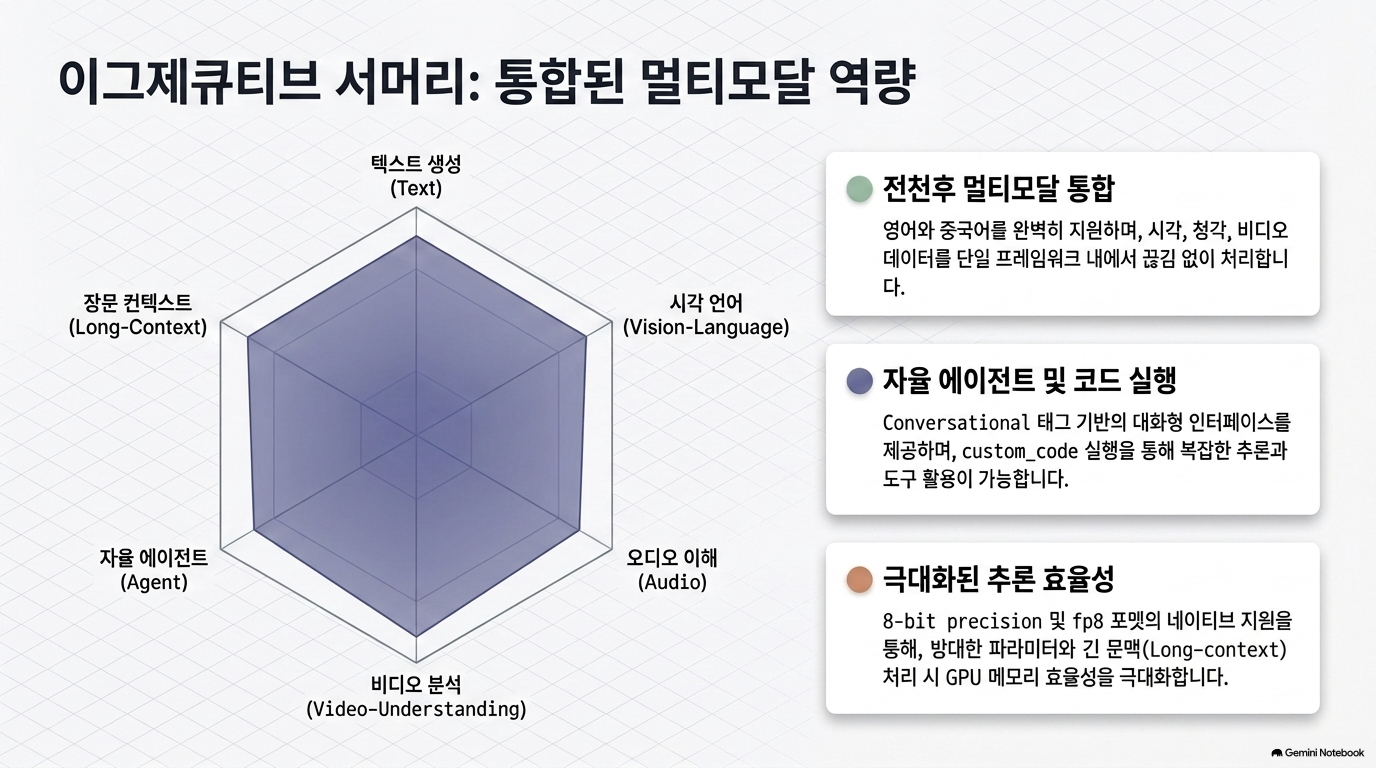
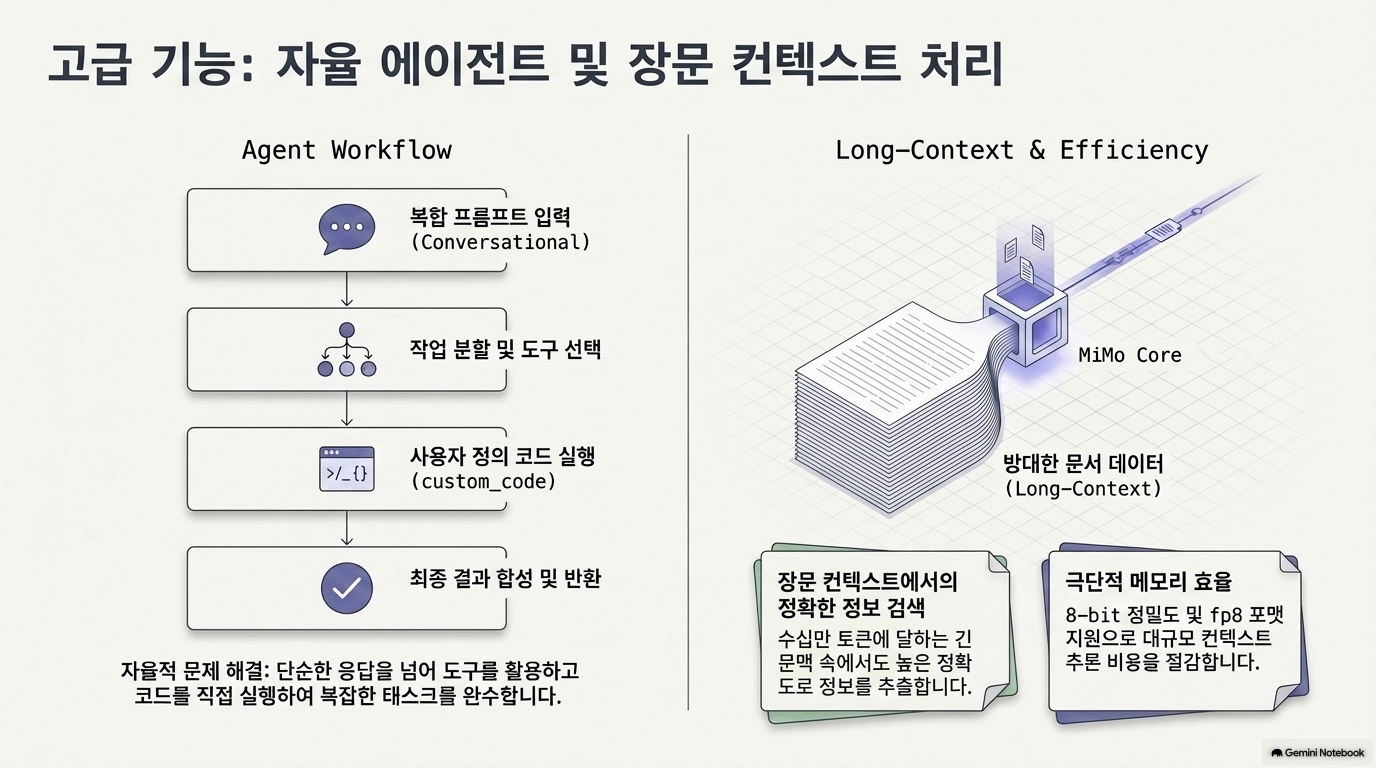
제공된 문서는 샤오미(Xiaomi)가 개발한 옴니모달 기반 대규모 언어 모델인 MiMo-V2.6 시리즈와 그 강화학습(RL) 기술 보고서를 담고 있습니다. 본 문서는 모델의 구조, 사전 학습 및 중기 학습 과정을 설명하고, 특히 컴퓨트 자원, 학습 환경, 평가 시스템이라는 세 가지 핵심 축을 중심으로 강화학습을 대규모로 확장하는 방법론을 상세히 다룹니다. 아울러 대규모 에이전트 기반 학습을 안정적으로 지원하기 위해 구축된 고성능 인프라와 비동기 학습 파이프라인을 소개하며, 최종적으로 코딩, 비주얼 디자인, 사이버 보안 등 다양한 벤치마크 전반에서 모델의 성능이 지속적으로 향상됨을 입증합니다.
장기·다단계 업무를 수행하는 AI 에이전트를 강화학습으로 개선하기 위해 모델·환경·평가자·분산 인프라를 어떻게 공동 설계했는지 설명하는 기술보고서
제목의 Self-Improvement는 완성된 자율적 재귀 자기개선 시스템을 의미하지 않습니다. 실제로 입증한 것은 설계된 환경과 평가 체계 안에서 대규모 강화학습을 수행하면 에이전트 능력이 지속적으로 개선된다는 것입니다.
분석 대상은 《MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement》, 총 44페이지입니다. 아래 페이지는 PDF에 인쇄된 페이지 번호를 기준으로 합니다. 성능 수치는 연구팀의 보고값이며, 제가 독립적으로 벤치마크를 재실행한 결과는 아닙니다.[1]
0. 전체 구조와 읽는 관점
| 챕터 | 범위 | 핵심 질문 |
| 1. Introduction | pp.3–4 | 에이전트 자기개선에 무엇이 필요한가? |
| 2. Architecture | pp.4–6 | 1M 문맥과 멀티모달 처리를 어떤 구조로 지원하는가? |
| 3. Pre-Training | p.7 | RL 이전에 어떤 기반 능력과 탐색 공간을 확보하는가? |
| 4. Scaling Reinforcement Learning | pp.8–20 | 연산·환경·평가를 어떻게 함께 확장하는가? |
| 5. Experiments: You Only RL Once | pp.20–26 | 실제 성능 향상과 학습 안정성은 어느 정도인가? |
| 6. RL and OPD Infrastructure | pp.26–33 | 대규모 비동기 에이전트 학습을 어떻게 운영하는가? |
| 7. Open Foundations for Agentic RL | pp.33–36 | 소형 모델과 공개 환경에서도 개선이 재현되는가? |
| 8. Conclusion | p.36 | 무엇을 입증했고 무엇이 남아 있는가? |
참고문헌은 pp.37–43에 걸쳐 배치되어 있으며, p.37에는 웹사이트 생성 사례 Figure 17도 포함됩니다. 부록 A는 p.44의 기여자·감사 목록입니다.[1]
전체 논리는 다음과 같습니다.
멀티모달 기반 모델 확보 → 에이전트 중심 중간학습 → 연산·환경·평가자 동시 확장 → 학습 안정화 → 다양한 업무와 실행 프레임워크로의 전이 → 소형 모델·환경·프레임워크 공개
여기서 가장 중요한 개념은 “탐색할 수 있는 능력”과 “좋은 탐색을 식별할 수 있는 평가”를 함께 확보해야 한다는 점입니다.
1. Introduction — 자기개선을 ‘실행과 피드백’의 문제로 재정의
원문: pp.3–4
1.1 문제 정의
보고서는 재귀적 자기개선, 즉 RSI를 모델이 지속적인 탐색과 피드백을 통해 능력을 확장하는 비전으로 제시합니다. 이를 구현하려면 모델이 텍스트만 생성하는 것이 아니라, 환경과 상호작용하며 여러 단계의 행동을 수행하는 에이전트여야 한다고 봅니다.[1]
연구팀이 제시하는 장애물은 두 가지입니다.
- 기반 모델의 구조와 탐색 공간
- 강화학습 확장의 복잡성
1.2 모델군의 역할
| 모델 | 전체 파라미터 | 활성 파라미터 |
| MiMo-V2.6-Pro | 1.02T | 42B |
| MiMo-V2.6-Flash | 310B | 15B |
두 모델 모두 MoE 구조입니다. 전체 파라미터와 토큰당 활성 파라미터를 구분해야 합니다. Pro가 1.02T 모델이라는 사실과, 매 토큰의 연산에서 1.02T 전체가 활성화된다는 주장은 다릅니다.[1]
1.3 핵심 기여: RL 확장의 세 축
보고서의 중심은 다음 세 가지를 동시에 확장하는 것입니다.
- 학습 연산: 대규모 배치와 높은 처리량
- 환경·하네스: 업무와 실행 방식의 다양성
- 평가자 연산: 더 정확하고 세분화된 보상 신호[1]
여기서 harness는 모델을 감싸는 에이전트 실행 프레임워크입니다. 시스템 프롬프트, 도구 인터페이스, 실행 루프, 문맥 관리 등이 포함됩니다.
분석
이 접근은 에이전트 성능을 모델 가중치 하나의 문제로 보지 않습니다.
에이전트 능력 = 기반 모델 능력 + 환경에서의 탐색 + 평가 품질 + 실행 시스템의 안정성
이라는 시스템적 관점에 가깝습니다.
한계
RSI의 실현과 RL에 의한 성능 개선을 동일시하면 안 됩니다. 이 보고서에서는 사람이 설계한 학습 파이프라인·환경·평가자·보호 장치가 핵심 역할을 수행합니다. 모델이 스스로 학습 목표, 인프라, 평가 체계를 독립적으로 재설계하는 폐쇄형 자기개선 루프를 입증한 것은 아닙니다.
2. Architecture — 긴 문맥을 감당하기 위한 하이브리드 멀티모달 MoE
원문: pp.4–6
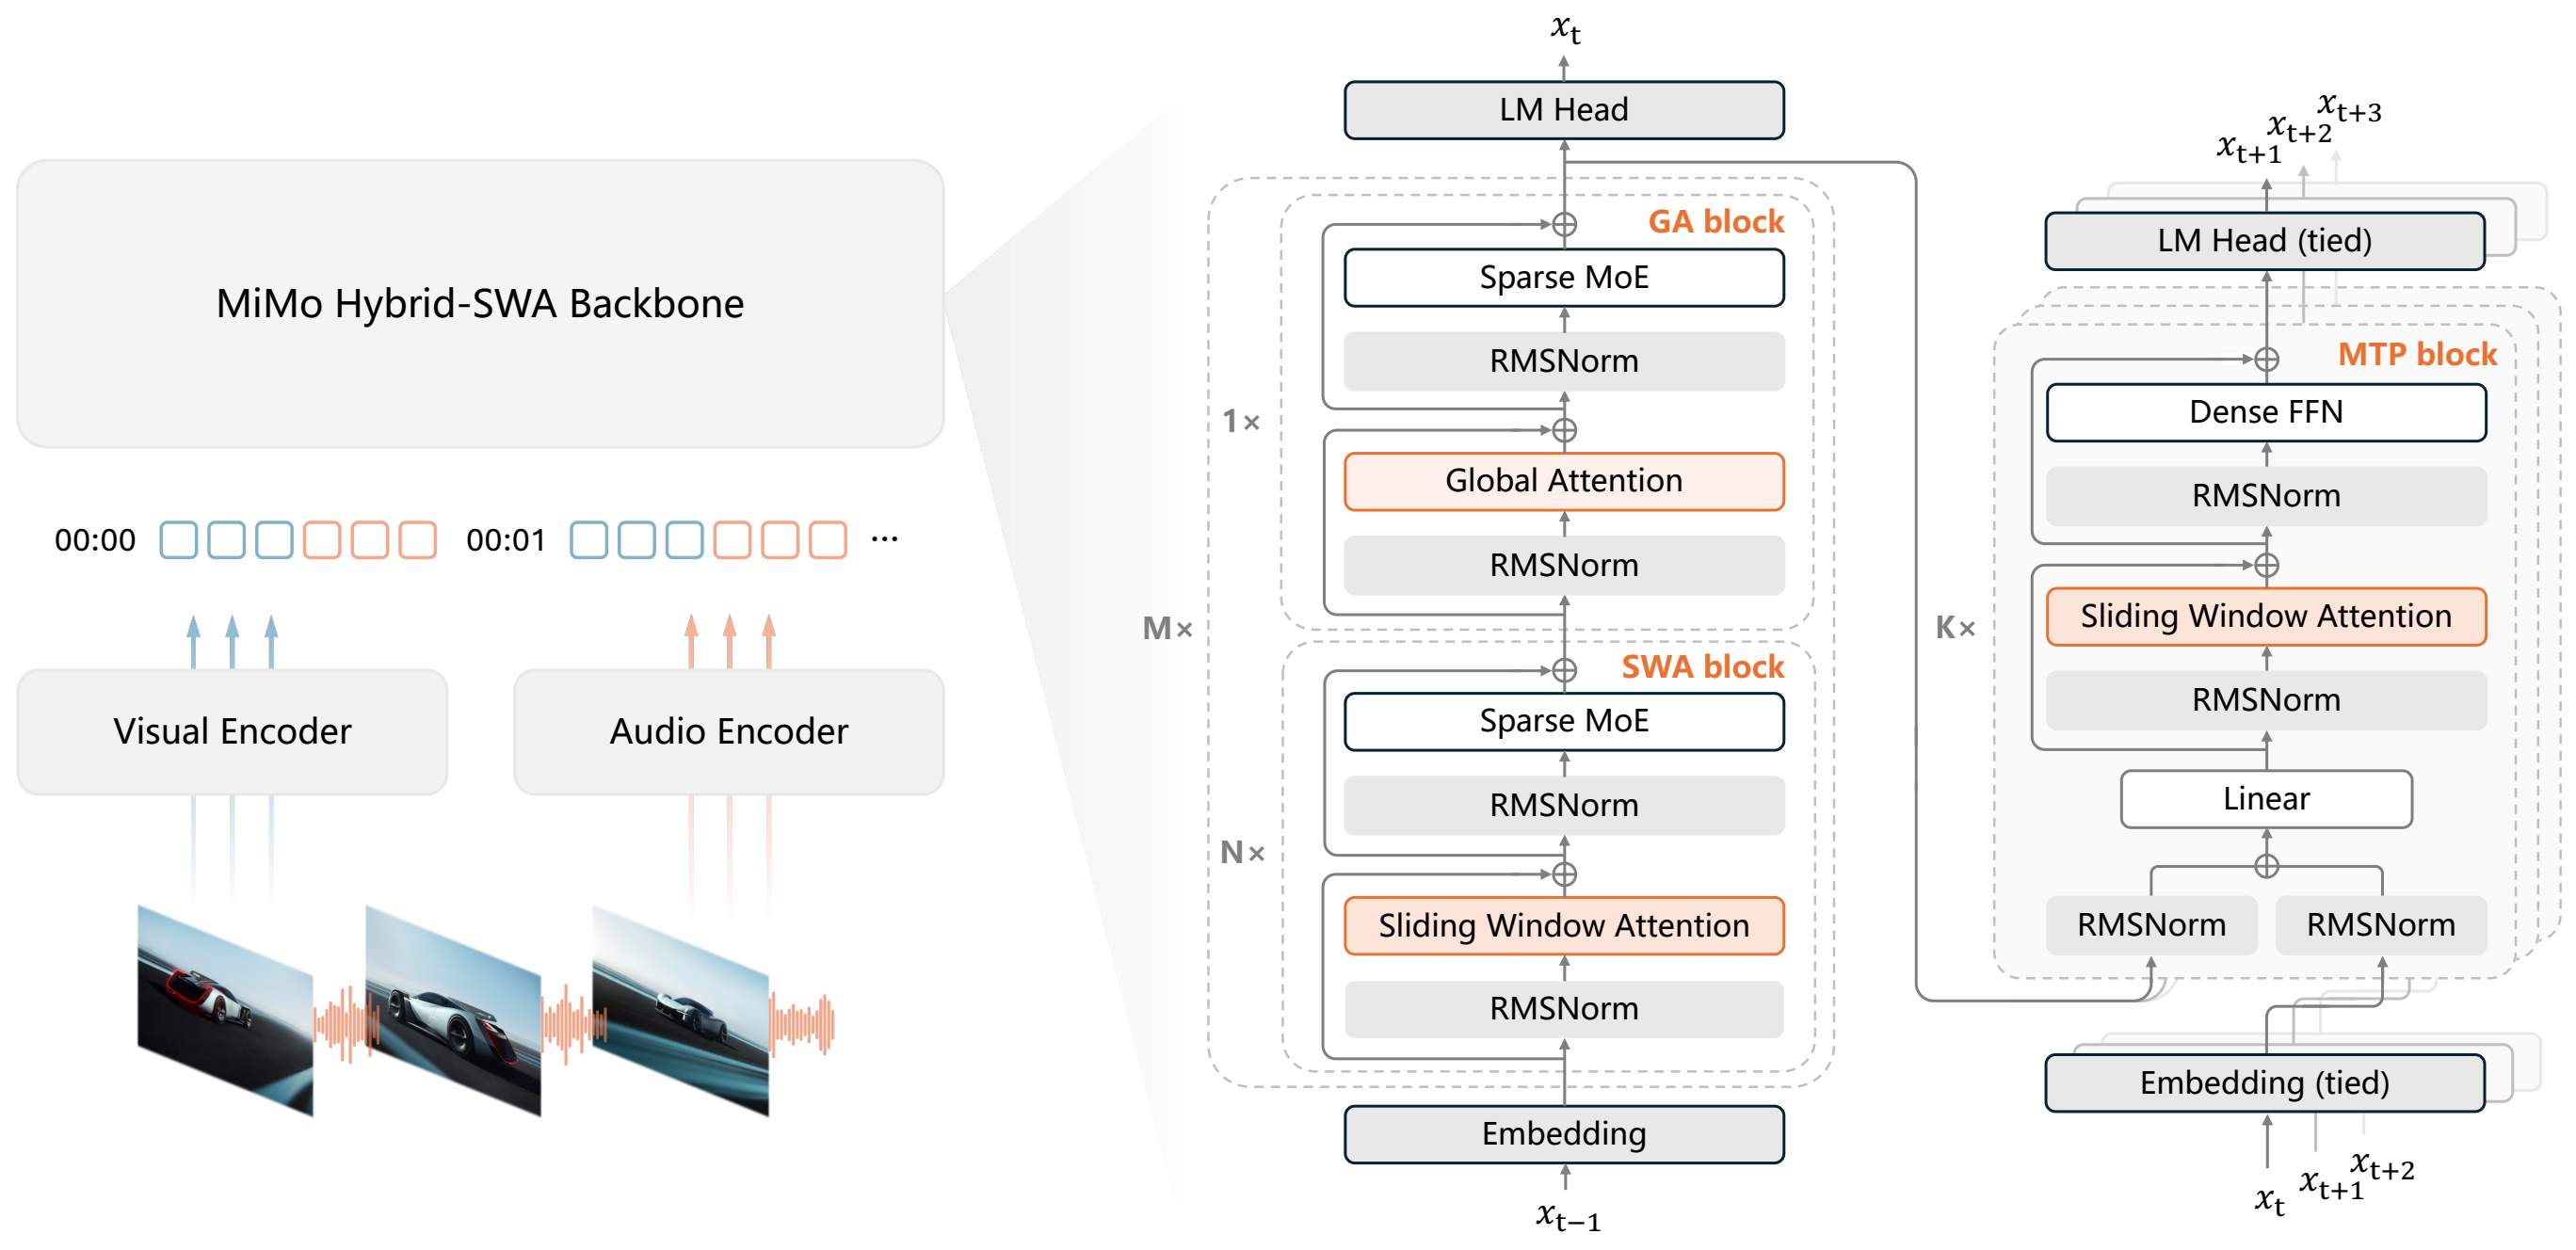
2.1 Overall Architecture: SWA와 Global Attention의 결합
언어 백본은 Sliding Window Attention, SWA와 Global Attention, GA를 교차 배치합니다.
- SWA는 제한된 주변 문맥을 처리합니다.
- GA는 전체 문맥의 정보를 연결합니다.
- 기본 SWA 윈도 크기는 128토큰입니다.
- 첫 Transformer 블록만 GA와 dense FFN을 사용합니다.
- 이후 SWA·GA 블록은 공유 전문가가 없는 sparse MoE FFN을 사용합니다.[1]
주요 구성은 다음과 같습니다.
| 항목 | Flash | Pro |
| 전체 레이어 | 48 | 70 |
| SWA / GA 레이어 | 39 / 9 | 60 / 10 |
| Hidden size | 4,096 | 6,144 |
| 전체 전문가 / 활성 전문가 | 256 / 8 | 384 / 8 |
| SWA 윈도 | 128 | 128 |
레이어 수는 MTP 모듈을 제외한 값입니다.[1]
설계 의도
1M 문맥에서 모든 레이어가 전체 문맥에 주의를 기울이면 연산·메모리·통신 부담이 큽니다. 따라서 대부분의 레이어는 지역 정보를 처리하고, 일부 레이어가 전체 문맥을 연결하는 구조를 사용합니다.
해석상 주의
128토큰 윈도라고 해서 모델의 전체 기억 범위가 128토큰이라는 뜻은 아닙니다. GA 레이어와 여러 레이어에 걸친 정보 전달이 존재합니다.
반대로 1M 입력 지원이 곧 1M 구간 전체에서 균일한 검색 정확도나 추론 품질을 보장하는 것은 아닙니다. 이 보고서의 주된 실험은 에이전트 업무 성능이며, 장문 구간별 정보 회수 품질을 종합적으로 입증하는 보고서는 아닙니다.
2.2 MiMo-ViT: 고해상도 시각 처리의 비용 절감
시각 인코더는 681M 파라미터, 총 28개 레이어로 구성되며, SWA 24개와 GA 4개를 사용합니다.[1]
주요 특징은 다음과 같습니다.
- 고정된 비중첩 윈도 대신 sink-augmented SWA 사용
- 지역 레이어마다 행 우선·열 우선 토큰 순서를 교대로 적용
- 주기적으로 GA를 삽입하여 전체 시각 맥락 통합
- 작은 사전학습 LLM과 연결하여 멀티모달 이해 데이터의 cross-entropy로 학습
- 이 과정에서 LLM도 학습 가능 상태로 유지
- 4T 이상의 이미지 토큰으로 사전학습[1]
기술적 의미
고정 윈도 방식에서는 윈도 경계에 걸친 시각 요소가 분절될 수 있습니다. MiMo-ViT는 윈도 간 정보 전달과 두 공간 축의 정보 확산을 강화하려고 합니다.
이는 다음 업무와 연결됩니다.
- 복잡한 화면과 GUI 이해
- 문서·슬라이드의 레이아웃 이해
- 웹사이트 생성 결과 평가
- 고해상도 이미지 기반 코드 생성
한계
연구팀은 GA 기반 ViT와 유사한 성능을 더 낮은 비용으로 달성한다고 설명하지만, 상세 비교는 별도 인용 논문에 위임합니다. 이 보고서만으로 모든 고해상도 시각 업무에서의 우위를 확정하기는 어렵습니다.
2.3 Audio Encoder: 오디오를 언어 백본에 투입할 수 있도록 압축
오디오 처리는 두 단계입니다.
① Audio Tokenizer
- log-mel spectrogram 입력
- 합성곱 전처리와 하이브리드 attention
- 추가 다운샘플링 후 25Hz
- 20단계 RVQ로 프레임당 20개의 이산 오디오 토큰
- 음성·음악·기타 오디오를 포함한 2,000만 시간으로 학습[1]
② Audio Patch Encoder
- RVQ 코드북별 임베딩을 합산
- 연속된 4프레임을 하나의 패치로 처리
- 패치 내부 양방향 attention
- 백본 입력 임베딩으로 투영
- 백본에 들어가는 시퀀스 빈도를 6.25Hz로 축소[1]
분석
오디오 표현을 그대로 언어 백본에 투입하면 토큰 비용이 커집니다. 이 구조는 시간적 정보를 패치로 묶어 긴 오디오의 입력 부담을 줄이는 설계입니다.
주의
이 장이 입증하는 것은 주로 오디오 입력의 인코딩 방식입니다. 이를 곧바로 완전한 실시간 음성 대화 시스템이나 고품질 음성 출력 능력의 입증으로 확대 해석하면 안 됩니다.
2.4 Speculative Decoder: 초안 생성과 검증의 분리
추론 가속에는 DFlash 계열 block diffusion 설계를 따르는 MTP 모듈을 사용합니다.
- dense FFN을 사용하는 5개 Transformer 레이어
- 백본 hidden feature와 anchor token을 조건으로 사용
- 한 번의 forward pass에서 다음 7개 토큰을 예측
- 백본이 이를 병렬 검증
- 초안 블록 내부는 양방향 attention
- anchor 이전 백본 문맥은 최대 1,024개 위치에 주의[1]
의미
추측 디코딩의 목표는 초안 모델로 주 모델을 대체하는 것이 아니라, 주 모델의 검증을 통과할 가능성이 높은 토큰을 미리 생성하여 처리량을 높이는 것입니다.
실제 RL에서는 별도의 block-6 설정을 사용하며, 이는 6장의 처리량 최적화와 연결됩니다. 아키텍처 설명의 7토큰 예측과 실제 RL 운영 설정을 하나의 고정 구성으로 혼동하지 않아야 합니다.
3. Pre-Training — 강화학습이 탐색할 기반을 먼저 만든다
원문: p.7
3.1 Pre-Training Setup: 텍스트 기반 확립 후 멀티모달 통합
사전학습은 두 단계로 진행됩니다.
- 텍스트만으로 언어 백본 학습
- 자체 시각·오디오 인코더를 연결하고 멀티모달 공동학습[1]
데이터 범위는 다음과 같습니다.
- 텍스트: 웹·책·학술논문·코드·STEM
- 시각: 캡션·grounding·OCR·GUI·대화·비디오·visual coding
- 오디오: 음성-텍스트 교차 형식·ASR·일반 오디오 캡션[1]
| 모델 | 텍스트 단계 | 멀티모달 단계 | 총 학습 토큰 |
| Flash | 26T | 22T | 48T |
| Pro | 27T | 3T | 30T |
문맥 길이는 32K에서 시작하여 256K로 확장하며, 옵티마이저는 AdamW입니다.[1]
분석
흥미로운 점은 더 작은 Flash가 더 많은 총 토큰과 멀티모달 단계 토큰으로 학습되었다는 것입니다.
따라서 Pro와 Flash의 차이를 단순히 “파라미터 수 차이”만으로 설명할 수 없습니다. 모델 규모뿐 아니라 데이터 투입량과 학습 단계 구성도 다릅니다.
다만 이 표만으로 Flash의 멀티모달 능력이 Pro보다 우수하다고 결론 내릴 수는 없습니다.
3.2 Mid-Training Setup: 지식 모델에서 에이전트 모델로 전환
중간학습은 일반적 지식과 멀티모달 이해를 실제 에이전트 행동으로 연결합니다.
데이터에는 다음이 포함됩니다.
- 코드·일반 업무·시각·연구 분야의 실제적인 에이전트 궤적
- 고품질 텍스트
- 저장소 단위 코드
- 이미지·비디오·오디오[1]
문맥은 먼저 256K로 학습하고, 마지막 단계에서 1M으로 확장합니다.[1]
옵티마이저 전환
연구팀은 큰 배치의 혼합 업무 RL에서 AdamW의 최적화 효율이 떨어지는 현상을 관찰하고, hidden weight matrix에 Muown을 적용합니다.
- Muon 계열의 행렬 구조 기반 업데이트
- 명시적인 row-norm 제어 추가
- 임베딩·LM head·MoE router는 AdamW 유지
- 중간학습에서 MXFP4 QAT 적용[1]
분석
이 단계는 단순한 추가 지식 학습이 아닙니다.
에이전트 궤적 적응 + 문맥 확장 + 대규모 배치용 최적화 적응 + 저정밀 연산 적응
을 묶은 RL 준비 단계입니다.
한계
보고서는 옵티마이저 전환 과정에서 loss spike가 없었다고 설명하지만, 이를 모든 모델과 데이터 구성에서 전환 위험이 없다는 일반 법칙으로 볼 수는 없습니다.
또한 데이터의 광범위한 범주는 공개되어 있지만, 전체 데이터의 출처·권리·중복 제거·벤치마크 오염 방지 절차를 이 장만으로 완전히 재구성하기는 어렵습니다.
4. Scaling Reinforcement Learning — 보고서의 핵심 기여
원문: pp.8–20
이 장은 세 부분으로 나뉩니다.
- 학습 연산 확대
- 환경·하네스 다양화
- 그룹 단위 평가를 통한 보상 정교화
4.1 Scaling RL Training Computation: 대규모 비동기 학습
pp.8–9
규모
| 항목 | 보고값 |
| 프롬프트 배치 | 1,568 |
| 프롬프트당 rollout | 16 |
| 단계당 rollout 수 | 약 25K, 정확히 25,088 |
| 단계당 학습 토큰 | 2.7B–3.7B |
| 시퀀스당 토큰 | 대략 110K–150K |
| 최대 문맥 | 1M |
| Pro RL 비용 | 260만 달러 |
| Flash RL 비용 | 90만 달러 |
이는 RL post-training 비용입니다. 사전학습부터 전체 개발까지의 총비용으로 읽으면 안 됩니다.[1]
성능과 비용
Figure 3에서 DeepSWE average@3는 다음과 같이 상승합니다.
- Pro: 58.4 → 72.6, 14.2%p 상승
- Flash: 48.7 → 65.7, 17.0%p 상승[1]
Pro의 RL 비용 구성은 다음과 같습니다.
- rollout: 43.8%
- 학습: 43.5%
- 평가자: 12.7%[1]
중요한 해석
평가자는 주변 기능이 아닙니다. 전체 RL 비용의 상당 부분을 차지하는 학습 신호 생산 시스템입니다.
이 보고서에서 성능 향상은 “더 많이 생성”한 결과만이 아니라, “더 잘 평가”한 결과이기도 합니다.
Partial rollout
장기 궤적이 끝날 때까지 모두 기다리지 않습니다.
- 학습 배치가 모이면 진행 중인 궤적을 중단
- 다음 rollout 단계에서 이어서 수행
- 정책 업데이트 뒤에는 KV cache 재구축을 위한 re-prefill 필요[1]
따라서 비동기 처리는 기다림을 줄이지만, 정책 지연과 재처리 비용을 가져옵니다.
Dynamic sampling
모든 후보가 통과하거나 모두 실패하는 그룹은 상대적인 학습 신호가 약하므로 필터링합니다.[1]
다만 뒤에서 설명하는 GRS는 모든 후보가 테스트를 통과하더라도 품질 점수 차이로 학습 신호를 만들 수 있습니다. 따라서 “all-pass 그룹은 어떤 경우에도 학습에 쓰지 않는다”로 단순화하면 부정확합니다.
4.2 Scaling RL Environments and Harnesses: 다양성과 검증 신뢰성
pp.9–16
4.2.1 Code Agent Tasks — 테스트가 있다고 정답 보상이 보장되지는 않는다
코딩 과제는 다섯 경로로 구축합니다.
- GitHub PR·이슈 기반
- 조직 내부의 실제 개발 요청
- 상세 명세 기반
- 기존 소스코드 기능에서 역으로 과제 생성
- 요구 범위와 의존성을 확장한 장기 소프트웨어 엔지니어링 과제[1]
외부 공개 데이터와 라이선스 데이터도 함께 활용합니다.
감독 신호의 정확성
명세와 테스트의 범위를 맞춥니다.
- 요구사항을 위반한 구현이 통과하면 false positive
- 요구사항을 만족한 구현이 실패하면 false negative
각 과제를 코딩 에이전트가 4회 시도하고, 감사 에이전트가 다음을 함께 확인합니다.
- 문제 명세
- 테스트
- 참조 패치
- 제출 패치
- 테스트 결과
- 전체 대화 궤적[1]
감독 신호의 안정성
참조 패치가 있는 과제에서는:
- 패치 전: F2P는 실패, P2P는 통과
- 패치 후: 둘 다 통과
- 이 결과가 8회 재실행에서 안정적인지 확인[1]
분석: 단순히 테스트를 많이 만드는 것이 아니라, 명세 적합성·정답 판별력·실행 안정성을 각각 관리합니다. 공공 AI 품질관리에서도 그대로 참고할 수 있는 구조입니다.
4.2.2 General Agent Tasks — 전문 업무 환경을 로컬에서 재현
일반 업무 과제는 파일, 소프트웨어, 데이터베이스, MCP·API·CLI·GUI 인터페이스를 조합합니다.
대규모 RL을 위해 외부 서비스는 로컬 mock으로 재현하고, 각 rollout은 초기 상태로 복원할 수 있는 격리된 sandbox에서 수행합니다.[1]
환경 생성 과정은 다음과 같습니다.
계획 수립 → 파일·DB 병렬 생성 → 개별·전체 정합성 검토 → 반복 보정 → 업무 과제와 rubric 생성
검토 대상에는 엔터티 명칭, 수치 대사, 일정, 파일 간 참조 등이 포함됩니다.[1]
평가는 원자적 이진 rubric으로 구성합니다.
- 결정적 속성: 코드 기반 검증
- 개방형 콘텐츠: LLM 기반 평가
- 같은 평가자의 반복 일치와 서로 다른 평가자 간 일치 확인
- 여러 수준의 모델 궤적을 검토하여 과도하거나 느슨한 rubric 수정
- 무관한 파일·DB 변경에 대한 negative check
- 겉으로만 정답처럼 보이는 adversarial solution 검사[1]
분석과 한계
보고서는 평가 일관성만으로 rubric의 타당성을 보장할 수 없다고 명시합니다. 중요한 구분입니다.
또한 mock 기반 학습은 재현성을 높이지만, 실제 SaaS의 인증·권한·네트워크 지연·비정형 오류까지 동일하게 재현한다고 볼 수는 없습니다.
4.2.3 Visual Agent Tasks — 창작과 복제를 분리
시각 과제는 두 종류입니다.
| 유형 | 목적 | 평가 |
| Open-ended design | 사용자 의도에 맞는 창의적 결과물 | 개별 rubric + 그룹 비교 |
| High-fidelity replication | 참조 화면·이미지의 충실한 재현 | 픽셀 유사도 등 규칙 + LLM 평가 |
대상은 웹사이트·앱·게임·3D 장면·슬라이드·SVG·비디오·Figma 디자인 등입니다.[1]
개방형 디자인에서는 실행 정확성, 지시 준수, 레이아웃, 기본 미적 품질을 먼저 평가한 뒤, 같은 요청의 여러 결과물을 비교하여 더 나은 후보를 구분합니다.[1]
분석: 정답이 하나가 아닌 업무에서는 절대 기준만으로 미세한 품질 차이를 포착하기 어렵습니다. 그룹 비교는 유용하지만, 평가자의 미적 취향과 선호 편향이 학습될 위험도 남습니다.
4.2.4 Cybersecurity Agent Tasks — ‘아무 크래시’가 아니라 ‘지정 취약점’을 재현
학습 목표는 프로젝트와 버그 설명을 받아 해당 취약점을 유발하는 입력을 만드는 것입니다.
연구팀은 단순히 프로그램이 크래시했다고 성공으로 인정하지 않습니다. sanitizer 보고서에서:
- 취약점 유형
- 최상위 프로젝트 수준 stack frame의 crash location
을 추출하고, 생성된 PoC가 두 조건을 모두 충족할 때 통과시킵니다.[1]
장점
- 판정의 결정성
- 반복 실행 가능성
- 저렴한 검증 비용
- 과제 설명과 판정 기준이 같은 원천에 기반
한계
취약점 유형과 위치의 일치는 강한 실용적 기준이지만, 근본 원인의 완전한 동일성을 형식적으로 증명하는 것은 아닙니다.
또한 취약점 재현 능력과 실제 exploit 개발 능력은 다른 단계입니다. 이 차이는 5장의 평가 결과에서 뚜렷하게 나타납니다.
4.2.5 Multi-Harness Training — 특정 실행 프레임워크에 과적합하지 않도록 학습
연구팀은 실제 운영용 하네스를 그대로 학습에 쓰기보다, 최소한의 모듈식 mini-harness를 구성합니다.
이유는 다음과 같습니다.
- 운영용 하네스의 복잡한 지시·보호 장치 중 일부는 과제 보상에 반영되지 않음
- 모듈 결합도가 높아 한 요소만 바꾸기 어려움
- 실행 방식의 다양성을 통제된 조합으로 만들기 어려움[1]
mini-harness는 시스템 프롬프트, 도구, 문맥 관리 등을 분리하여 조합합니다.
분석
목표는 특정 도구 이름이나 프롬프트 형식에 익숙한 모델이 아니라, 다른 실행 방식에서도 문제 해결 전략을 유지하는 모델입니다.
단, 학습 중 여러 하네스를 사용했다는 사실만으로 일반화가 입증되지는 않습니다. 미사용 하네스 평가가 필요하며, 보고서는 이를 5장과 7장에서 제시합니다.
4.2.6 Reward Hacking Mitigation — 정답처럼 보이는 우회 경로를 차단
대표적인 해킹은 solution leakage입니다.
- 최신 패키지 소스에서 이미 수정된 코드 확인
- upstream 파일·패치 다운로드
- 최신 저장소 clone
- 원래 이슈·PR에서 해결책 검색
- 이후 버전을 비교하여 수정 사항 복제[1]
보고서가 문제 삼는 이유는 “검색 자체가 나쁘기 때문”이 아닙니다. 주어진 과거 checkout과 문제 설명에서 수리를 도출해야 하는 과제의 평가 목적을 우회하기 때문입니다.
대응은 네 층입니다.
- 중간학습에 행동 교정 사례 포함
- 환경의 로그·패치·캐시·이후 Git 이력 정리와 네트워크 격리
- hack agent를 통한 반복 공격·보완
- 학습 중 궤적 감사와 확인된 해킹 보상 0 처리[1]
보고된 확인된 해킹 궤적 비중은 전체 학습 동안 2% 미만입니다.[1]
해석상 주의
이는 탐지되어 확인된 해킹의 비중입니다. 미탐지 해킹까지 포함한 실제 발생률이나 완전한 안전성을 입증하는 수치는 아닙니다.
4.3 Groupwise Agentic Grading — 통과 여부에서 해결 품질로
pp.16–20
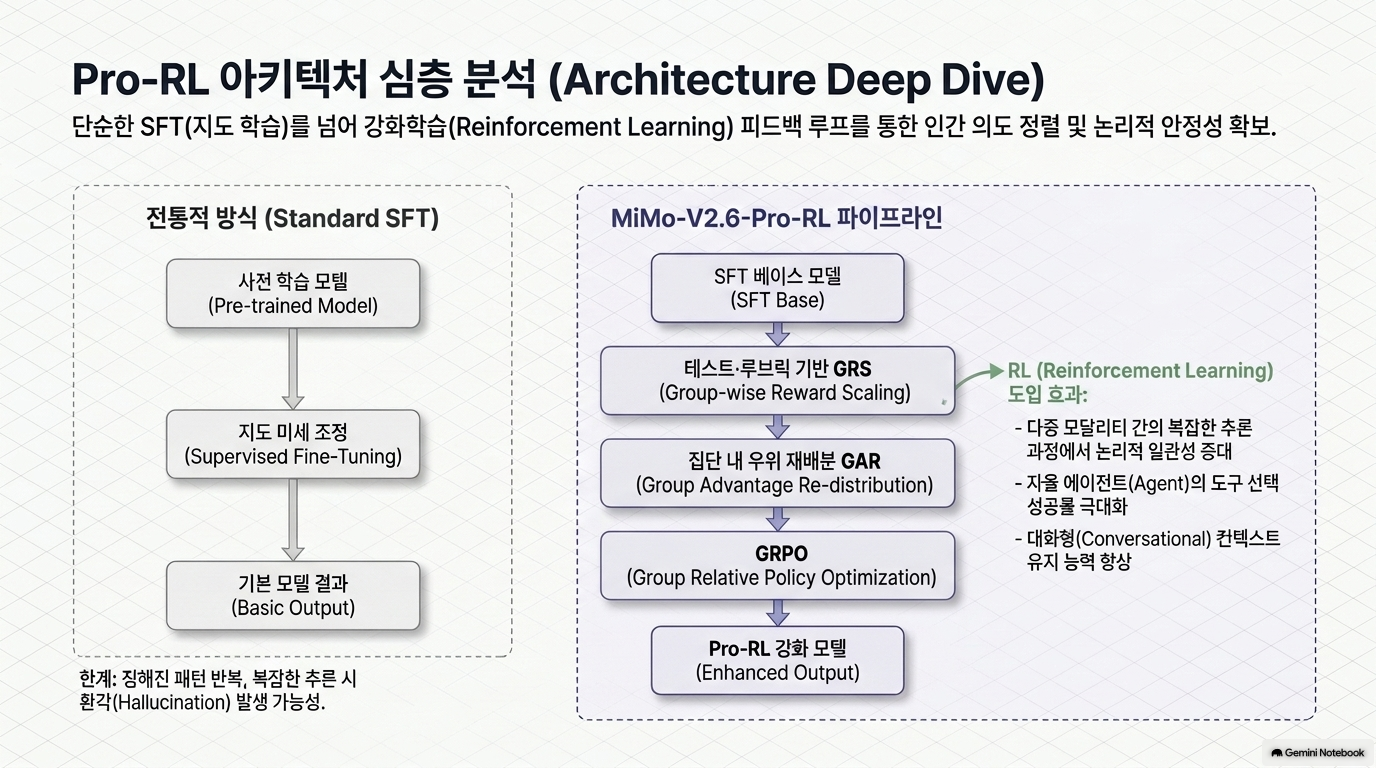
이 보고서의 가장 중요한 알고리즘적 기여입니다.
4.3.1 GRS: Groupwise Reward Synthesis
일부 성공률이 높은 과제에서 여러 offline rollout을 비교하여 두 종류의 rubric을 만듭니다.
- Solution rubric: 요구 충족, 경계 조건, 코드베이스와의 일관성
- Behavior rubric: 근거 수집, 변경 검증 등 문제 해결 행동[1]
최종 보상은 다음과 같습니다.
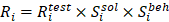
테스트 실패 궤적은 보상이 0이고, 통과 궤적은 구현 품질과 행동 품질로 차등화됩니다.[1]
의미
모든 후보가 테스트를 통과해도:
- 하나는 정확하고 작은 수정
- 다른 하나는 예외를 무시하는 임시 수정
- 또 다른 하나는 필요 없는 호환 분기를 추가
했다면 서로 다른 학습 신호를 줄 수 있습니다.
한계: rubric 자체가 잘못되면 그 오류가 보상에 전파됩니다. 관찰된 성공 사례의 스타일을 모든 정답의 필수 조건으로 오인하지 않도록 관리해야 합니다.
4.3.2 GAR: Groupwise Advantage Redistribution
나머지 코딩 과제에서는 online grader가 같은 그룹의 성공·실패 궤적을 함께 검토합니다.
성공 패치는 다음 기준으로 비교합니다.
- 해결 접근의 적절성
- 구현의 정밀성
- 필요한 변경 대비 최소성
- 과제 외부의 부작용 회피
- 코드베이스 관례에 맞는 완성도[1]
해킹이 확인되면 먼저 실패로 재분류합니다. 이후 성공 궤적 간에 양의 advantage를 재분배합니다.

여기서 품질이 낮은 통과 궤적의 가중치를 낮추고, 제거된 양의 학습 신호를 더 좋은 통과 궤적에 돌립니다. 실무 구현에서는 확대 계수를 제한하고 그룹 평균을 다시 빼며, 평가 결과가 쓸 수 없으면 원래 advantage로 돌아갑니다.[1]
실험 결과와 해석
Flash의 코드 전용 RL 비교에서 GAR이 없으면:
- turn 수와 토큰 길이가 빠르게 증가
- 길이 제한에 도달하는 궤적 증가
- 성능 개선 지속이 어려워짐
GAR을 쓰면 turn 수가 대체로 안정적으로 유지되고, 통과율 개선이 더 오래 지속됩니다.[1]
다만 이 비교는 배치 128, 코드 전용, token-mean loss 실험입니다. 본 대규모 혼합 RL의 모든 효과를 동일한 인과적 결과로 확대하면 안 됩니다.
4.3.3 Behavioral Regularization
두 가지 추가 장치가 있습니다.
① 그룹 상대 길이 페널티
- 같은 문제를 성공한 궤적들의 길이로 기준 설정
- 기준보다 과도하게 긴 성공 궤적에 감점
- 그룹 성공률이 일정 수준 이상일 때 적용
- 어려운 문제에서는 탐색을 과도하게 줄이지 않도록 gate 사용[1]
② 구간 수준 행동 페널티
잘못된 도구명, 인자 형식, markup 등의 오류 토큰을 구분합니다.
- 성공 궤적에서도 오류 토큰은 긍정 강화에서 제외
- 실패 궤적의 오류 토큰은 더 강하게 벌점
- 정상 토큰의 가중치를 조정하여 과도한 음의 최적화 압력을 완화[1]
종합 분석
목표는 무조건 짧은 답변이 아닙니다.
문제를 제대로 해결하면서 불필요한 행동·토큰·우회 구현을 줄이는 것
입니다. 에이전트 품질을 정확성 × 유지보수성 × 행동 효율로 확장한 접근이라고 볼 수 있습니다.
5. Experiments — 성능 향상과 운영 실패를 함께 공개
원문: pp.20–26
5.1 Training Setup
학습 과제 구성은 다음과 같습니다.
| 분야 | 비중 |
| 에이전트·경쟁형 코딩 | 68% |
| 일반 도구 사용 | 12% |
| 미적 디자인 | 13% |
| 문맥 지시 준수 | 3% |
| 사이버보안 | 4% |
GRPO, 비동기 partial rollout, staleness 4를 사용합니다.[1]
주요 안정화 설정은:
- Muown 학습률

- weight decay와 warmup 없음
- gradient clipping 1.0
- SFT의 FP32 master weight와 Muown row state 승계
- RL 동안 MoE router 동결
- prompt-mean loss 집계
- 정책 entropy에 따라 중요도 비율 clipping 범위 조정[1]
분석
범용 에이전트 모델이지만 학습 분포는 코딩 중심입니다. 전문 업무와 시각 과제의 개선을 설명할 때 이 비중을 함께 고려해야 합니다.
또한 entropy에 따라 학습 설정을 조정한다는 점에서, 완전히 고정된 단순 레시피라기보다 관측과 제어가 들어간 운영형 학습입니다.
5.2 Evaluation Settings
공개 벤치마크와 내부 벤치마크를 함께 사용합니다.
- 코딩: DeepSWE, ProgramBench, MiMo Code Bench
- 일반 업무: AutomationBench, Toolathlon, GDPval-AA, JobBench 등
- 컴퓨터 사용: OSWorld-Verified
- 보안: CyberGym, ExploitGym, ExploitBench, SEC Bench Pro
- 시각: MiMo Visual Coding[1]
비교 모델의 reasoning effort가 조정 가능하면 최고 설정인 max를 사용합니다.[1]
주의할 사항
- 내부 벤치마크는 제3자 검증이 필요합니다.
- 최고 reasoning 설정을 맞추어도 비용·지연·도구 구성까지 같다는 뜻은 아닙니다.
- CyberGym 평가 환경은 연구팀이 §4.2.4 방법으로 수정했습니다. 따라서 원래 환경의 결과와 직접 비교할 때 설정 확인이 필요합니다.[1]
5.3 RL Performance와 최종 결과
핵심 수치
아래는 최종 Table 3의 일부입니다. 행마다 지표와 난도가 다르므로 점수를 서로 평균하거나 같은 성공률로 읽으면 안 됩니다. 특히 GDPval-AA 점수는 백분율이 아닙니다.[1]
| 벤치마크 | V2.6 Pro | V2.6 Flash | V2.5 Pro |
| DeepSWE v1.1 | 71.9 | 67.9 | 19.0 |
| ProgramBench | 26.5 | 26.0 | 12.5 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 16.0 |
| Toolathlon-Verified | 76.9 | 73.6 | 49.1 |
| GDPval-AA 2.1 | 1,673 | — | 1,107 |
| Agents’ Last Exam | 31.6 | 27.6 | 13.2 |
| Terminal Bench 4.0 | 34.9 | 28.8 | 1.5 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 |
| OSWorld-Verified | 82.0 | 80.8 | — |
| JobBench | 62.0 | 61.2 | 25.0 |
| CyberGym | 94.0 | 95.1 | 40.0 |
| ExploitGym | 17.8 | 6.0 | 0.2 |
| ExploitBench | 47.9 | 25.3 | 16.6 |
| MiMo Visual Coding | 72.3 | 71.5 | — |
무엇이 좋아졌는가?
① 업무 자동화
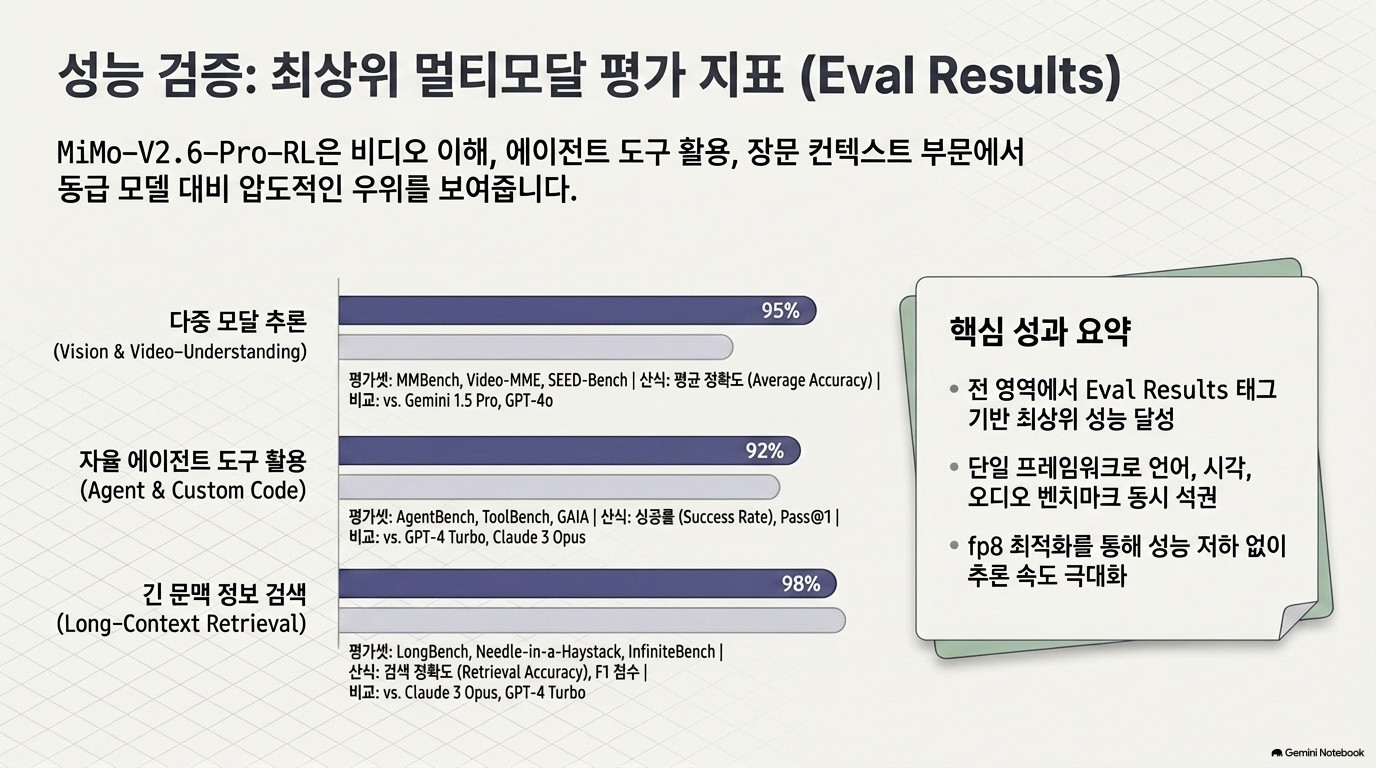
AutomationBench에서는 Pro 53.1, Flash 52.3으로, 표에 제시된 Claude Opus 5의 50.3과 GPT-5.6 Sol의 45.8보다 높습니다. 이는 해당 평가 설정에서의 강점입니다.[1]
② 장기 코딩
DeepSWE에서 큰 개선을 보이지만, 최종 Pro 71.9는 표의 Claude Opus 5 74.0, GPT-5.6 Sol 73.0보다 낮습니다. “경쟁력 있음”과 “전 분야 최고”를 구분해야 합니다.[1]
③ 보안 재현과 exploit 개발의 격차
CyberGym은 94.0이지만 ExploitGym은 17.8입니다. 크래시를 재현하는 능력과 실제 exploit을 구성하는 능력 사이에 큰 격차가 남아 있습니다.[1]
④ 평가 버전의 차이
Terminal Bench 2.1의 89.9와 4.0의 34.9를 보면, 특정 버전의 높은 점수를 일반적인 터미널 업무 성공률로 간주하기 어렵습니다.[1]
RL 단계 결과와 최종 모델 결과를 구분해야 함
Figure 3의 DeepSWE는 Pro 72.6, Flash 65.7인 반면, 최종 Table 3은 71.9, 67.9입니다.[1]
서로 다른 단계의 결과이며, 최종 결과는 MOPD2 설명 뒤에 제시됩니다. 보고서에 차이의 원인이 상세히 분해되어 있지 않으므로 어느 하나를 오기라고 단정하거나 섞어 사용하면 안 됩니다.
5.4 Router Freezing for Stable RL
router를 학습 가능한 상태로 두면 특정 전문가에 토큰이 몰리는 load collapse가 발생했습니다.
20단계 동안 관찰된 변화는:
- load CV: 0.78 → 2.0
- 최대/평균 부하: 6배 → 16배
- cold expert 비중: 0.5% → 22%[1]
20단계 checkpoint에서 router만 초기값으로 되돌리자 부하 균형이 회복되었고, 벤치마크 성능은 유지되었습니다. 연구팀은 원인을 expert weight의 손상보다 router drift로 판단합니다.[1]
router를 동결하면 CV 약 0.7, peak load 약 5.5배 수준에서 안정적으로 유지되며 성능은 개선됩니다.[1]
분석
이는 “모든 파라미터를 학습해야 최대 성능이 나온다”는 직관에 대한 반례입니다.
그러나 주요 정량 관측은 Pro decoder layer 9를 중심으로 제시됩니다. 모든 MoE 구조와 모든 RL 조건에 동결이 최적이라고 일반화할 수는 없습니다.
5.5 RL Failure Analysis
30단계 실행의 경과 시간은:
- Pro: 123.1시간
- Flash: 81.8시간[1]
실패 유형은 네 가지입니다.
| 유형 | 공개된 사례 | 의미 |
| 인프라 | GPU 메모리 DBE, Kubernetes 장애, grader 통신 단절 | 계산 장치 외의 서비스 안정성이 중요 |
| rollout | 초기 길이 추정 편향, KV 메모리 소진 | 완료된 짧은 궤적만으로 미래 부하를 추정하면 위험 |
| 학습 | micro-batch에서 EP rank에 평균 30배 이상 토큰 집중 | 전체 배치 평균이 국소 peak를 숨길 수 있음 |
| driver | packing 중 host memory 초과 | 데이터 plane을 분산해도 지역 메모리 병목은 남음 |
분석
이 장의 실무적 가치가 큽니다.
분산 학습에서 평균 사용률·평균 부하만 보고 안정성을 판단하면 안 된다는 사례입니다. 최대 부하, 긴 꼬리, 복구 직후 분포, host memory를 별도로 관리해야 합니다.
또한 You Only RL Once라는 제목은 실제로 장애 없이 한 번에 끝났다는 뜻이 아닙니다. 보고서는 재시작과 복구를 명확히 공개합니다.
5.6 MOPD2: 검증이 어려운 영역은 증류로 확장
혼합 RL 이후 Multi-Prefix Multi-Teacher On-Policy Distillation, MOPD2를 적용합니다.
- 검증 가능한 업무: mixRL teacher 활용
- 개방형 업무: 합성 시연으로 학습한 SFT teacher 활용
- 전체 student rollout을 평가하는 Standard MOPD
- teacher rollout 또는 SFT 데이터의 history prefix에서 student가 한 turn을 새로 생성하는 prefix-conditioned OPD[1]
핵심 차이
SFT 데이터는 고정된 정답 continuation이 아니라 시작 문맥을 제공합니다. 이후 행동은 student가 생성하고 teacher가 token 수준으로 감독합니다.[1]
분석
이 장은 보고서가 사실상 RL 만능론을 취하지 않는다는 증거입니다.
검증하기 어려운 과학 연구·장기 게임 개발·embodied intelligence 등은 별도의 교사 모델과 증류로 보완합니다.
따라서 최종 성능을 모두 혼합 RL 하나의 순수 효과로 귀속해서는 안 됩니다.
6. RL and OPD Infrastructure — 알고리즘을 실제 규모로 작동시키는 기반
원문: pp.26–33
6.1 Agentic RL with Fine-grained Learning Signals
궤적을 네 수준으로 구성합니다.
textCopy
Sample
└─ Sequence
└─ Context
└─ Segment
- Sample: 프롬프트와 rollout 그룹
- Sequence: 한 번의 Agent Loop 실행
- Context: 하나의 대화 분기
- Segment: 메시지·모델 생성·도구 결과 등의 단위[1]
subagent와 문맥 압축으로 한 실행 안에 여러 대화 분기가 생기므로, 단순한 한 줄짜리 대화 기록으로는 부족합니다.
학습 loss에는 모델이 생성한 turn만 기여합니다.[1]
Penalty Module
탐지와 조치를 분리합니다.
- Rule: 무엇을 오류로 판단할 것인가?
- Strategy: mask, advantage shaping, monitor, early stop 중 무엇을 적용할 것인가?[1]
실무적 의미
모델 오류와 인프라 오류를 구분합니다.
서버 장애나 환경 오류를 모델의 잘못으로 벌점 처리하면 잘못된 학습 신호가 생깁니다. 이 원칙은 학습뿐 아니라 에이전트 품질평가·운영 모니터링에도 적용할 수 있습니다.
6.2 Harness Pool과 Payload Porter
Harness Pool
한 rollout마다 Ray actor를 생성하면 GCS의 file descriptor가 소진될 수 있어, 고정된 persistent actor pool 안에 여러 tenant를 수용합니다.[1]
tenant별 궤적 상태는 분리하면서:
- event loop
- request endpoint
- inference proxy
- tokenizer
- harness codebase
등을 공유합니다. blocking 작업은 background thread에서 수행합니다.[1]
Payload Porter
대규모 궤적에는 토큰뿐 아니라 다음 데이터가 붙습니다.
- log probability
- MoE routing 정보
- top-p 후보 집합
- 멀티모달 입력[1]
이를 모두 driver에 모으면 driver 메모리가 배치 규모를 제한합니다.
따라서:
- control plane: 보상·길이·데이터 key 등 가벼운 metadata
- data plane: 실제 대형 payload의 분산 저장과 소비
로 분리합니다.[1]
시각 에이전트는 반복 screenshot으로 한 궤적에 GB급 데이터가 누적될 수 있어, 새 이미지의 delta 전송과 분산 인코딩도 사용합니다.[1]
분석
이 구조의 핵심은 “모든 데이터를 중앙에서 수집한 뒤 분배”하지 않는 것입니다.
제어는 중앙에서 가볍게, 대형 데이터는 저장 위치와 소비 위치 중심으로 분산 처리하는 패턴입니다.
다만 actor의 multi-tenancy 자체를 보안 격리와 동일시해서는 안 됩니다. 실행 성능과 tenant 보안 경계는 별도의 검증 대상입니다.
6.3 Sample Mixer — 빨리 끝나는 업무가 학습 분포를 지배하지 않도록
25개 데이터 소스에서:
- 평균 생성 토큰은 90배
- 활성 rollout 시간은 66배
차이가 났습니다.[1]
완료된 순서대로 학습 배치를 만들면 짧고 쉬운 과제가 과대표집될 수 있습니다.
Sample Mixer는 네 장치를 사용합니다.
- Adaptive Rollout Concurrency
- Adaptive Rollout Scheduling
- Predictive Rollout Dispatch
- Sample Replay
분석
이 장은 스케줄러가 단순한 GPU 최적화 장치가 아니라 학습 데이터 분포를 지키는 장치임을 보여줍니다.
한계
Figure 16은 trace-driven simulation이며 학습 시간, credit-assignment latency, staleness expiry, replay 등을 제외합니다.[1]
따라서 해당 시뮬레이션의 개선을 전체 시스템의 end-to-end 속도 향상과 그대로 동일시할 수 없습니다.
6.4 Training/Inference Consistency and Optimization
엔진
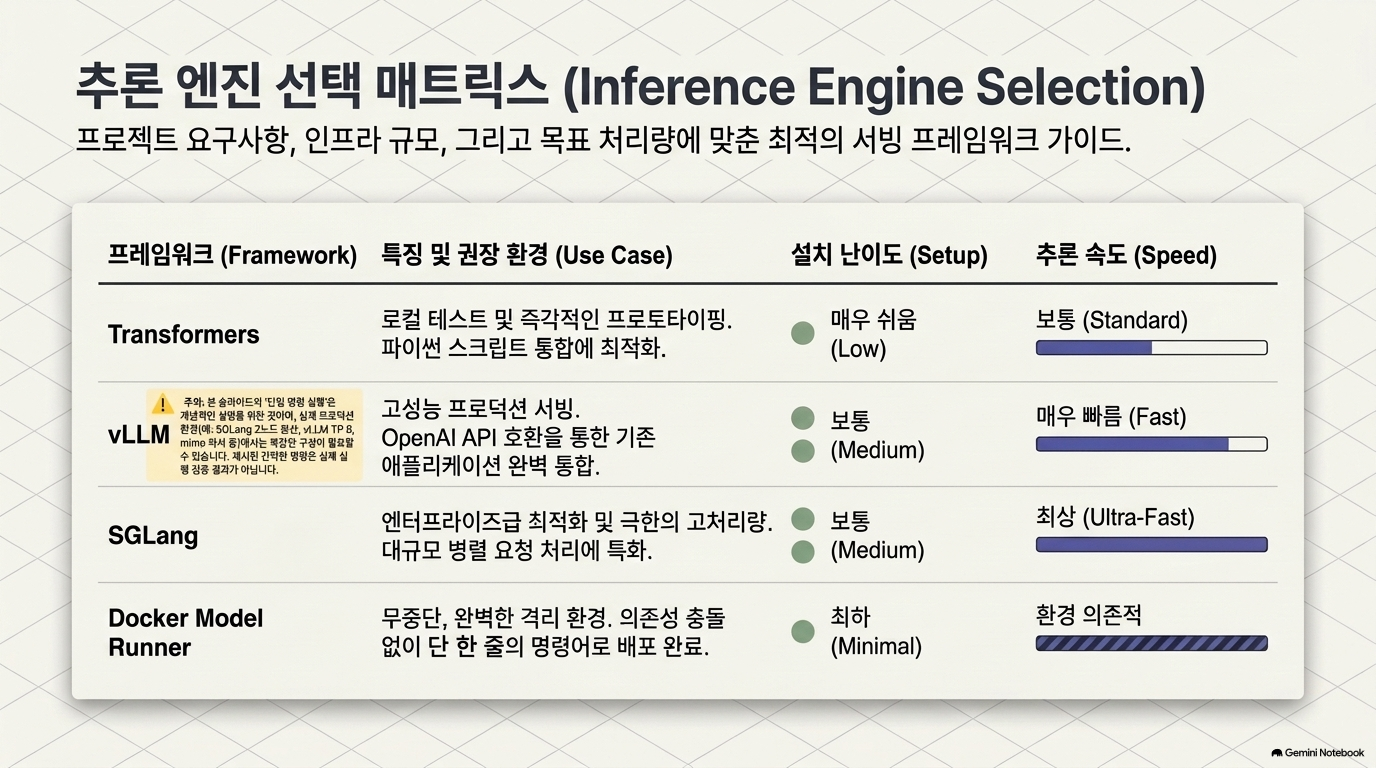
- 추론: SGLang
- 학습: Megatron-LM
- rollout expert 데이터 타입: MXFP4[1]
일관성 확보
| 장치 | 해결 대상 |
| QDQ | 학습·추론의 expert weight 정밀도 일치 |
| R3 | 수치 차이로 달라질 수 있는 expert routing 재현 |
| top-p/top-k candidate replay | 제한된 후보 집합의 확률 정규화 일치 |
같은 가중치라도 연산 엔진의 수치 차이로 expert 선택이 달라질 수 있습니다. 따라서 rollout 당시 선택한 expert를 학습에서 재사용합니다.[1]
top-p 샘플링도 전체 어휘가 아니라 실제 후보 집합 위에서 정규화되므로 그 집합을 기록·재현합니다. 전형적인 top-p 0.97에서 평균 후보 수는 5개 미만이라고 보고합니다.[1]
추론 최적화
- 대화 문맥별 지속 KV cache
- 새로운 suffix만 prefill
- 새 이미지 delta만 전송
- 도구 대기 중 KV를 pinned host memory로 이동
- RL 궤적으로 draft model 재학습[1]
가속 수치의 구분
- 기본 DFlash 설정의 평균 accepted length: 기존 MTP 대비 31.3% 증가
- block-6 처리량: block-8 대비 약 6% 증가
- RL 적응 FP8 DFlash의 노드당 처리량: baseline 대비 약 10.3% 증가[1]
세 수치는 비교 대상과 측정 항목이 다릅니다. 합산하거나 동일한 속도 향상으로 읽으면 안 됩니다.
종합 분석
대규모 RL에서 구현상의 차이는 단순한 성능 문제가 아닙니다. 중요도 비율과 학습 신호를 왜곡하여 최적화의 통계적 정합성에 영향을 줄 수 있습니다.
7. Open Foundations for Agentic RL — 소형 모델에서도 개선 가능한가?
원문: pp.33–36
7.1 Distillation from MiMo-V2.6
공개 기반 모델은 MiMo-V2.6-Distill-Qwen-9B입니다.
Qwen3.5-9B를 MiMo 생성 데이터로 SFT합니다.
- 전체 토큰: 77.4B
- loss에 기여하는 토큰: 27.2B[1]
| 분야 | 전체 토큰 | Loss 토큰 |
| Code | 23.2B | 7.3B |
| Cyber | 11.0B | 4.8B |
| General | 22.0B | 5.7B |
| Visual | 21.2B | 9.4B |
분석
전체 문맥에는 도구 결과와 입력 정보가 포함되지만, 그 전부를 모델 출력 정답처럼 학습하지는 않습니다.
이는 에이전트 데이터셋 평가에서 총 토큰과 실제 학습 대상 토큰을 구분해야 한다는 좋은 사례입니다.
또한 이 9B 모델은 Pro의 구조를 단순 축소한 모델이 아니라, 다른 기반 모델에 행동 경험을 전달한 증류 모델입니다.
7.2 RL with Open Environments
공개 환경의 과제 수는 근사치입니다.
| 분야 | 과제 수 | 검증 |
| Code | 약 3K | 실행 테스트 |
| Cyber | 약 1K | 규칙 검사 |
| General | 약 1K | rubric 평가 |
| Visual | 약 2K | 시각 평가 |
네 분야 합계는 약 7K이며, 별도로 약 1K 음악 생성 과제도 언급합니다.[1]
증류와 RL의 효과
| 벤치마크 | 원래 Qwen3.5-9B | 증류 SFT | 추가 RL |
| SWE-bench Verified | 60.0 | 61.1 | 66.2 |
| SWE-bench Pro | 32.0 | 44.6 | 47.6 |
| AutomationBench | 5.0 | 30.3 | 33.1 |
| Terminal Bench 2.1 | 27.0 | 37.1 | 52.8 |
| Toolathlon-Verified | 25.9 | 35.2 | 38.0 |
| OfficeQA Pro | 9.0 | 19.5 | 24.8 |
| JobBench | 2.6 | 18.3 | 25.2 |
| MiMo Cyber Bench mini | 5.7 | 31.3 | 47.0 |
| MiMo Visual Coding mini | 61.7 | 64.0 | 72.4 |
코딩·보안 행은 avg@3, 위 일반·시각 행은 avg@1입니다.[1]
무엇이 드러나는가?
- AutomationBench처럼 증류 단계의 향상이 큰 분야가 있습니다.
- Terminal Bench와 보안처럼 추가 RL의 향상이 큰 분야도 있습니다.
- 따라서 “성능 향상은 전부 RL 덕분”이라고 설명하면 부정확합니다.
매우 중요한 제한
Table 6의 RL 결과는 같은 SFT 초기 모델에서 출발해 분야별로 따로 학습한 checkpoint의 결과입니다.[1]
한 개의 9B RL 모델이 표의 모든 최고 성능을 동시에 달성한 것으로 읽으면 안 됩니다.
7.3 Multi-Harness 결과
별도 코딩 실험에서는 네 mini-harness로 학습하고, 세 미사용 하네스를 포함한 총 일곱 하네스로 평가합니다.
표에 나온 평균 점수는:
| 평가 | 원래 Qwen | 증류 SFT | Multi-Harness RL |
| SWE-bench Verified | 53.1 | 62.3 | 65.7 |
| SWE-bench Pro | 27.5 | 44.4 | 46.5 |
| MiMo Code Bench mini | 15.3 | 53.1 | 59.0 |
3개 평가 × 7개 하네스의 21개 조합에서 추가 RL이 모두 개선되었다고 보고합니다.[1]
분석
초대형 모델 실험의 핵심 아이디어가 9B에서도 관찰된다는 점이 중요합니다. 이는 실제 연구·조직 도입에서 더 접근 가능한 출발점입니다.
다만 내부 mini 평가셋은 해당 학습셋과 같은 업무 분포를 따릅니다. 이를 완전히 새로운 기관·산업·규제 업무로의 전이 성능으로 확대할 수는 없습니다.
8. Conclusion — 입증한 것은 ‘통제된 에이전트 자기개선의 경로’
원문: p.36
보고서가 강조하는 성공 조건은 다음입니다.
- 넓은 탐색 공간
- 신뢰할 수 있는 과제 환경
- 정보량이 높은 피드백
- 대규모 비동기 학습
- 학습·추론 일관성
- router drift와 reward hacking 방어
- 접근 가능한 공개 모델·환경·프레임워크[1]
최종 해석
입증한 것
- RL 연산을 확대하면서 여러 에이전트 평가에서 성능 개선이 지속됨
- 그룹 평가로 통과 궤적의 품질을 구분할 수 있음
- 여러 하네스에서 학습한 능력이 일부 미사용 하네스로 전이됨
- 소형 증류 모델도 고품질 환경에서 추가 RL로 개선됨
아직 입증하지 않은 것
- 사람의 환경·평가 설계 없이 작동하는 완전한 RSI
- 보상 해킹의 완전한 제거
- 실제 외부 서비스 환경에서 동일한 업무 성공률
- 모든 분야에서의 최상위 성능
- 전체 초대형 학습 실행을 제3자가 동일 조건으로 재현했다는 사실
9. 보고서 전체에 대한 비판적 평가
9.1 가장 강한 기여
① 보상을 ‘테스트 통과’에서 ‘실무적으로 좋은 해결’로 확장
GRS·GAR는 테스트만 통과하는 우회 구현을 줄이고, 작은 패치·정확한 변경·검증 행동을 강화하려는 접근입니다.
이 보고서의 가장 중요한 방향 전환은 성능 점수의 상승 자체보다, 무엇을 좋은 에이전트 행동으로 보상할 것인가를 정교화한 데 있습니다.
② 환경 품질을 학습 품질의 핵심으로 취급
명세–테스트 정합성, 반복 실행, 공격적 감사, 궤적 검토를 결합합니다. 데이터 양만 늘리는 접근과 구별됩니다.
③ 실패를 공개하여 설계 근거를 제공
router collapse, micro-batch 부하 집중, KV 추정 편향, driver OOM 등은 설계 선택의 이유를 구체적으로 보여줍니다.
9.2 추가 확인이 필요한 사항
| 구분 | 검토 항목 | 이유 |
| [확인 필요] | 최종 평가별 하네스·도구·추론 예산의 상세 동일성 | reasoning effort만 맞추어서는 공정 비교가 완성되지 않음 |
| [확인 필요] | 벤치마크 오염·중복 방지의 상세 증빙 | 웹·GitHub·합성 과제와 평가셋 사이의 독립성 확인 필요 |
| [확인 필요] | 그룹 평가자의 인간 전문가 일치도 | 일관된 평가가 반드시 타당한 평가는 아님 |
| [확인 필요] | 보상 해킹 탐지기의 recall과 미탐지율 | 확인된 해킹 2% 미만을 실제 발생률로 해석할 수 없음 |
| [보완 필요] | 반복 seed·오차 범위·통계적 불확실성 | 가까운 점수 차이의 유의성을 판단하기 어려움 |
| [보완 필요] | 정확성·토큰·지연·비용의 통합 비교 | 토큰 효율과 실제 업무 경제성은 다른 지표 |
| [확인 필요] | 공개 자원의 범위·버전·라이선스·재현 설정 | 보고서의 공개 선언과 실제 배포 상태는 별도 확인 대상 |
| [보완 필요] | 개인정보·권한·외부 전송·고위험 행동 평가 | 업무 성공과 안전한 업무 수행을 분리해 검증해야 함 |
위 항목은 보고서가 잘못되었다는 판정이 아니라, 연구 성과를 조직 도입·감리 판단으로 전환할 때 필요한 추가 증거입니다.
종합 결론
MiMo-V2.6 보고서의 본질은 “강화학습을 많이 하면 좋아진다”가 아니라, “올바른 성공을 측정할 수 있는 환경과 평가자를 만들고, 그 신호를 안정적으로 학습시키면 장기 에이전트 능력을 개선할 수 있다”는 데 있습니다.
특히 중요한 메시지는 세 가지입니다.
- 테스트 통과는 실제 문제 해결 품질과 같지 않습니다.
- 평가자와 환경의 품질이 모델의 학습 방향을 결정합니다.
- 최종 성능은 RL 하나가 아니라 사전학습·중간학습·평가 설계·증류·인프라의 공동 결과입니다.
공공 AI 컨설팅과 감리 관점에서는 모델 규모나 벤치마크 순위보다, 요구사항–실행 궤적–검증 기준–보상 신호의 추적성을 확보하는 접근이 가장 재사용 가치가 높습니다.
Sources
[1]https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL/resolve/main/MiMo_V2_6_technical_report.pdf — MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement