에이전트 AI - Microsoft Research, Agensh: 1,024개 에이전트 확장 시스템
https://arxiv.org/pdf/2609.26781
Project Page: https://aka.ms/Agensh
Code: https://github.com/microsoft/Agensh
2026.9.22
[Agensh: Scaling Organizational Intelligence to 1,024 Agents]
이 문헌은 중앙 통제 장치 없이 수천 개의 인공지능 에이전트가 협업하여 복잡한 소프트웨어를 개발할 수 있도록 설계된 분산형 프레임워크인 Agensh를 소개하고 있습니다. 핵심 아이디어는 자율적인 상호 조직화 협업 루프를 통해 각 에이전트가 비동기적으로 작업을 분담하고, 공유 작업 공간, 메시지 인터페이스, 그리고 공유 컨텍스트로 구성된 경량화된 조직 인프라를 활용해 정보를 투명하게 교환하는 것입니다. 1개에서 최대 1,024개까지 에이전트 규모를 확장함에 따라 단순한 동료 간 조정을 넘어 다중 작업자 통합, 표준화된 작업 흐름, 그리고 전문화된 역할 분담이 자연스럽게 출현함을 입증하고 있습니다. 결과적으로 본 연구는 에이전트 수의 확장이 일반 인공지능의 한계를 돌파하는 새로운 확장 차원이 될 수 있음을 증명하며, 엄격한 시간 제약 속에서도 복잡한 장기 작업을 완수할 수 있는 실질적인 해결책을 제시합니다.
이는 모델 자체의 추론 능력을 개선한 연구라기보다, 기존 모델의 조직화·상태 공유·비동기 실행 계층을 개선한 시스템 연구입니다. 저자의 “일반지능의 경계 확장”이라는 표현보다, 실험이 직접 입증한 범위는 특정 소프트웨어 재구현 과제에서의 성능 및 시간상 이점으로 읽는 편이 정확합니다.
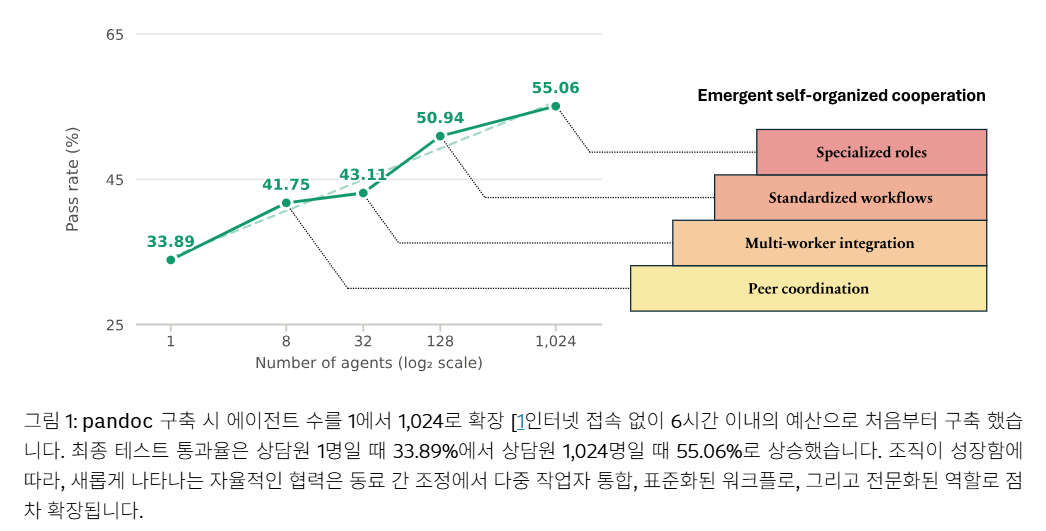
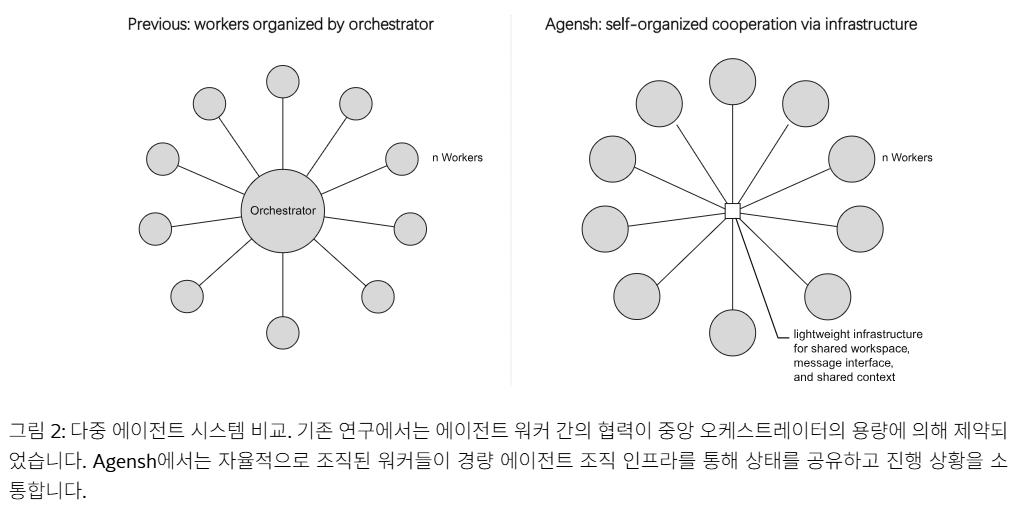
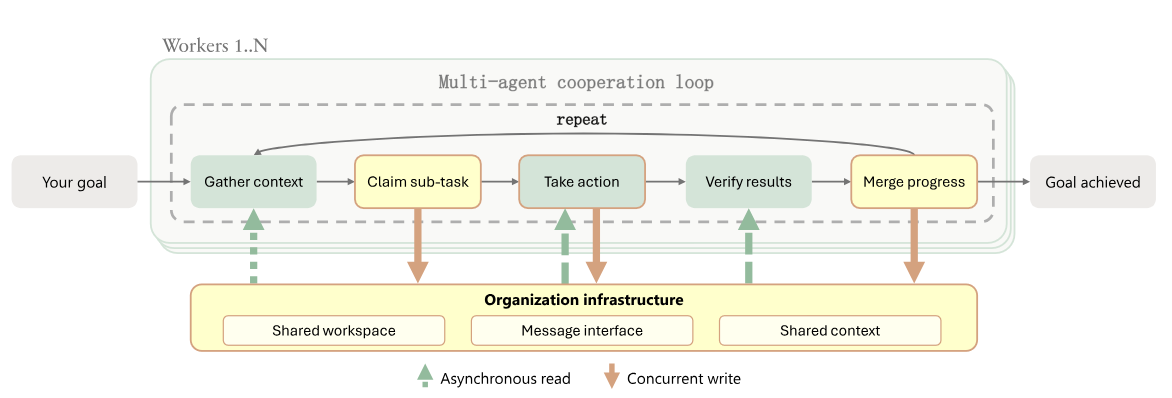
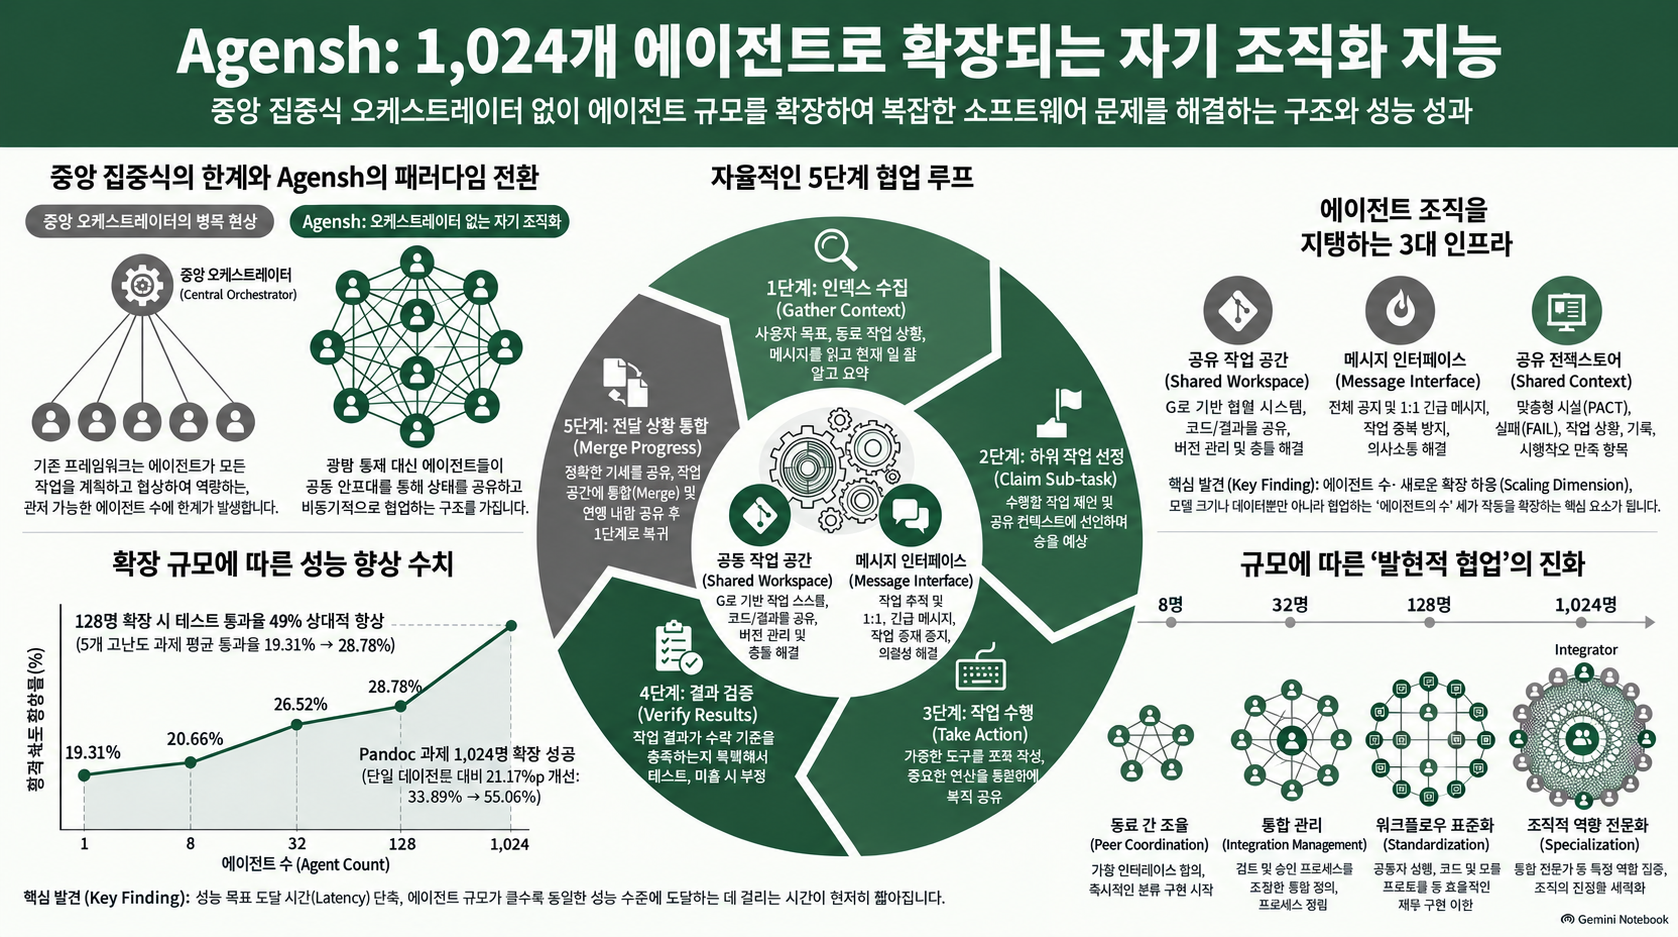
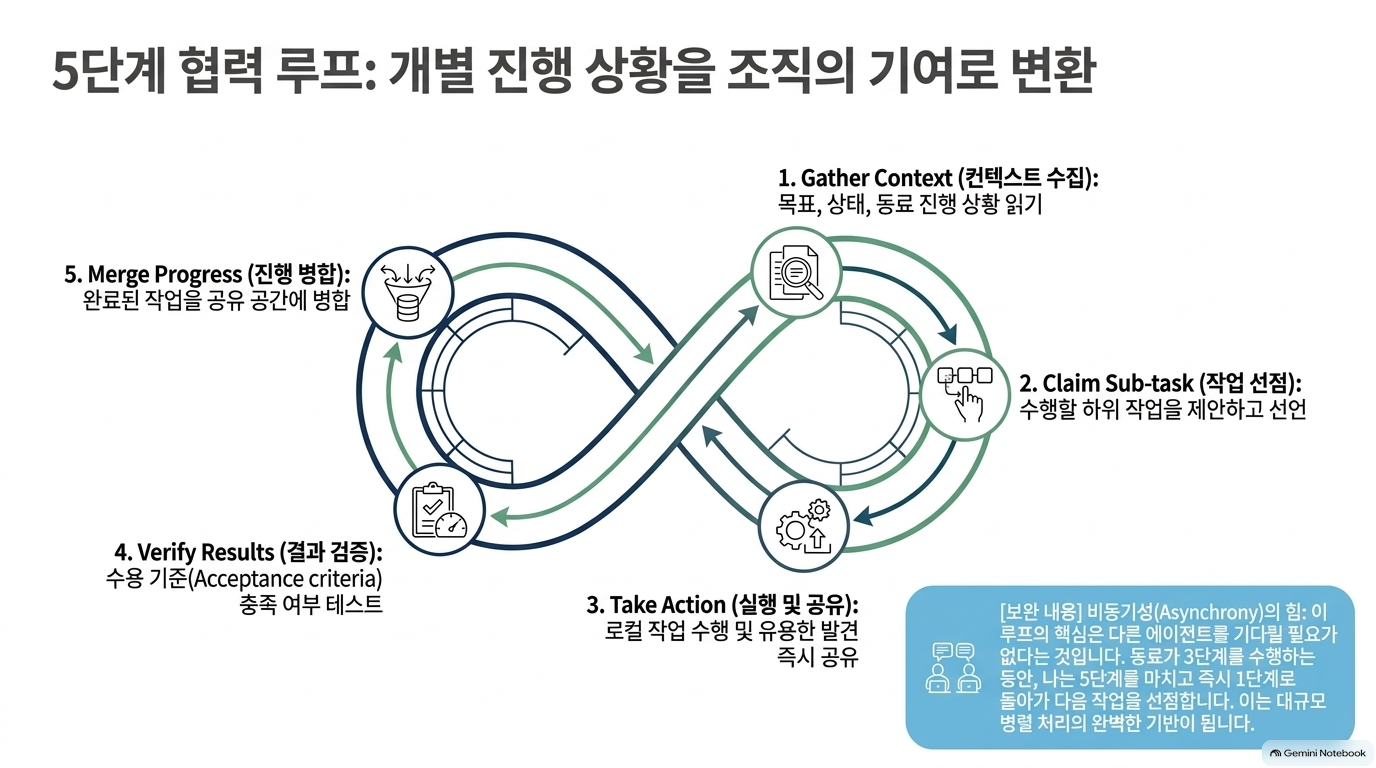
그림 3:Agensh 다중 에이전트 협력 루프. 워커들은 자체 조직화된 방식으로 컨텍스트를 동시에 수집하고, 하위 작업을 할당받고, 조치를 취하고, 결과를 검증하고, 진행 상황을 병합하고, 사용자의 목표가 달성될 때까지 이 과정을 반복합니다. 모든 워커는 비동기적으로 진행하며 인프라를 통해 진행 상황을 공유합니다.
「Agensh: Scaling Organizational Intelligence to 1,024 Agents」 장별 분석
논문의 핵심 주장은 “에이전트를 많이 띄우는 것” 자체가 아니라, 중앙 지휘자 없이도 각 에이전트의 작업을 발견·조정·검증·통합할 수 있는 조직 운영 방식을 만들면 병렬 작업의 효과를 확장할 수 있다는 것입니다. Microsoft Research의 2026년 9월 22일 공개 기술보고서(v1)이며, 13쪽 본문·부록으로 구성됩니다.[1][2]
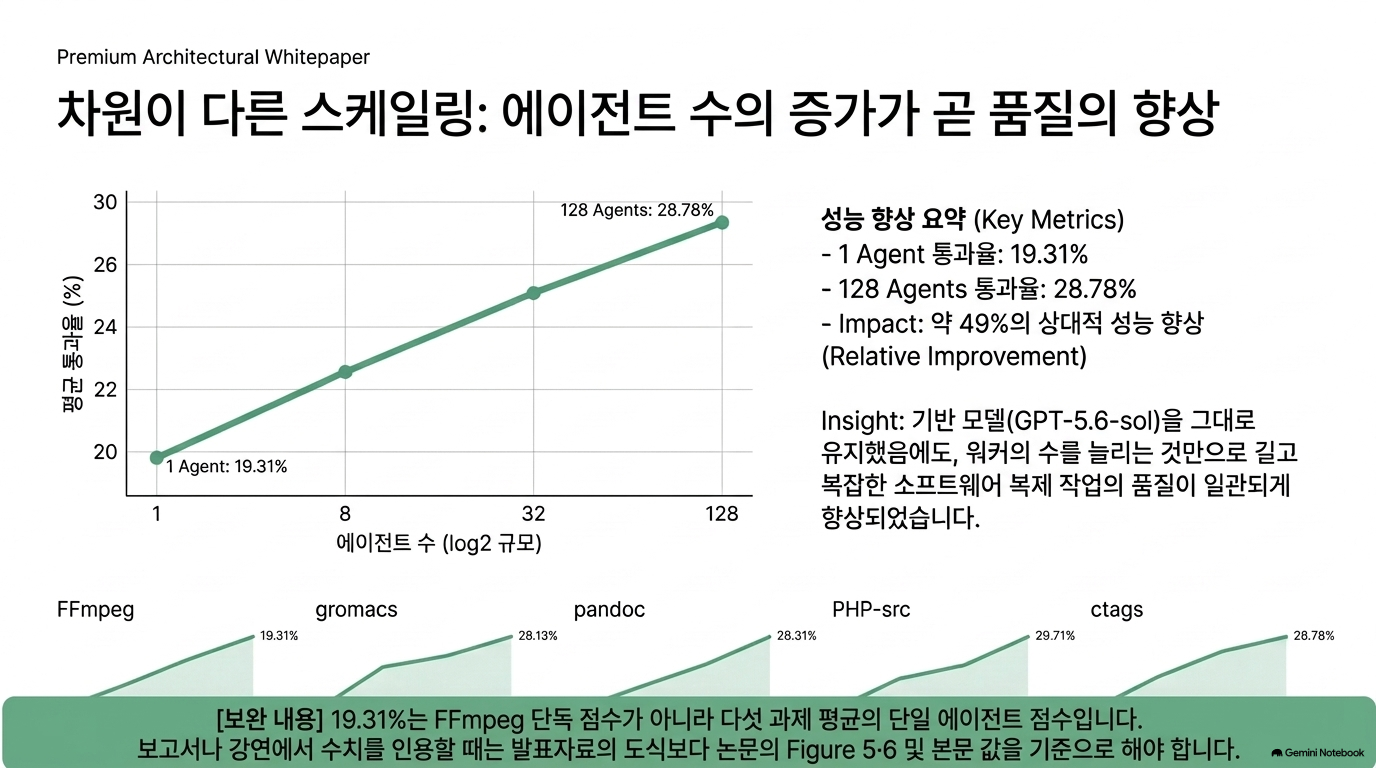
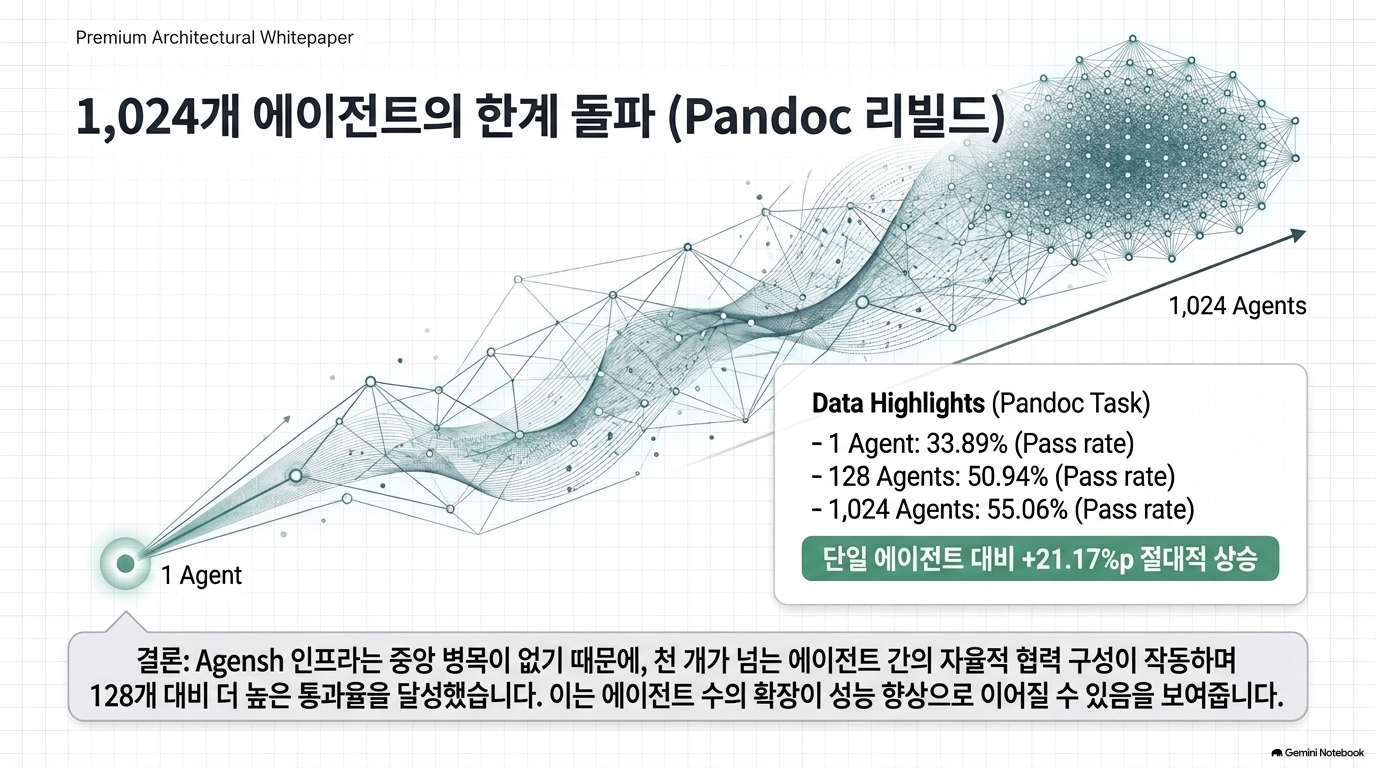
실험상 같은 모델과 6시간 제한에서, 난도가 높은 ProgramBench 5개 과제의 평균 최종 테스트 통과율은 1개 에이전트 19.31% → 128개 28.78%로 상승했습니다. 1,024개 에이전트 실험은 5개 과제 전체가 아니라 pandoc 한 과제에 대한 결과이며, 이때 33.89% → 55.06%였습니다. 이 구분이 논문을 읽는 데 가장 중요합니다.[1]
1장. Introduction — 왜 ‘중앙 오케스트레이터 없는 조직’인가
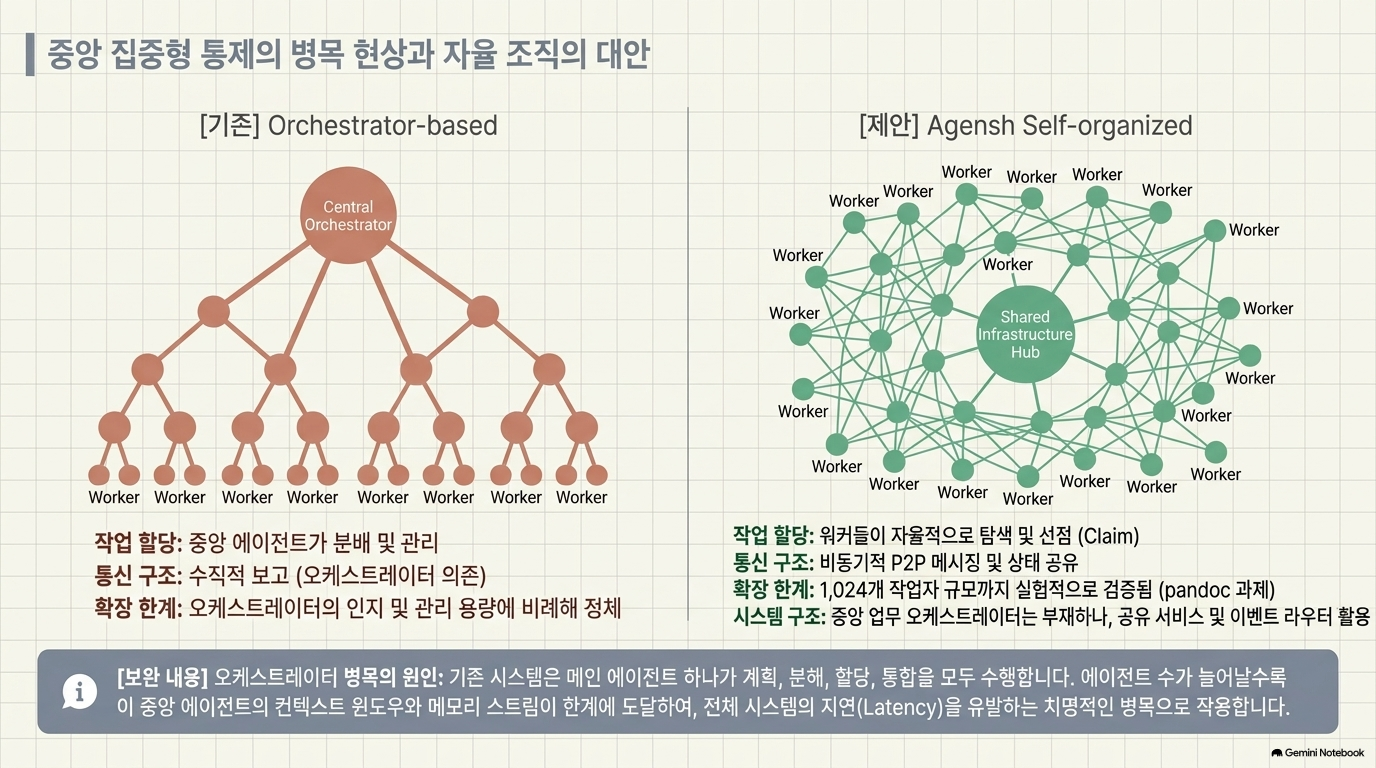
기존 단일 에이전트는 하나의 문맥·행동 흐름·기억 흐름에 의존하므로 긴 소프트웨어 개발 과제에서 순차 실행 시간이 병목이 됩니다. 기존 멀티에이전트 방식은 이를 병렬화하지만, 대개 메인 에이전트가 과제를 분해하고 작업자를 배정하며 결과를 취합합니다. 저자들은 작업자가 늘수록 이 계획·배정·통합 책임이 중앙 오케스트레이터의 병목이 될 수 있다고 봅니다.[1, pp. 2–3]
Agensh의 대안은 모든 작업자에게 같은 협업 규칙을 주고, 작업자가 스스로 할 일을 찾고 선언하게 하는 것입니다. 작업 상태와 결과는 공유 인프라에 남기므로, 협력이 한 에이전트의 문맥창이나 관리 능력에 종속되지 않습니다. 논문의 연구 질문은 실질적으로 “동일한 모델을 쓰면서 조직의 크기를 키우면 제한 시간 내 품질과 도달 속도가 개선되는가?”입니다.[1, pp. 2–3]
해석: 이는 모델 자체의 추론 능력을 개선한 연구라기보다, 기존 모델의 조직화·상태 공유·비동기 실행 계층을 개선한 시스템 연구입니다. 저자의 “일반지능의 경계 확장”이라는 표현보다, 실험이 직접 입증한 범위는 특정 소프트웨어 재구현 과제에서의 성능 및 시간상 이점으로 읽는 편이 정확합니다.
2장. Multi-Agent Organization Harness — 작동 원리
2.1 다섯 단계 협업 루프
각 작업자는 중앙의 순차 지시를 기다리지 않고 다음 루프를 독립적으로 반복합니다.[1, pp. 3–4]
| 단계 | 작업자의 행동 | 조직 차원의 기능 |
| ① Gather context | 공동 목표, 현재 코드, 동료 진행 상황·메시지·발견을 읽음 | 이미 한 일을 반복하지 않고 남은 일을 찾음 |
| ② Claim sub-task | 맡을 범위를 CLAIM으로 공개 | 작업 중복을 드러내고, 충돌 시 당사자끼리 협의 |
| ③ Take action | 로컬 환경에서 구현·실험하고 유용한 중간 발견을 공유 | 발견을 다른 작업자가 재사용 |
| ④ Verify results | 자신이 설정한 하위 과제의 수용 기준과 결과를 대조 | 미검증 결과의 통합을 억제 |
| ⑤ Merge progress | 변경을 공유 작업공간에 병합하고 변경 내용·아이디어·검증 근거를 게시 | 개인의 작업을 조직의 누적 성과로 전환 |
여기서 CLAIM은 중앙 스케줄러의 배정 명령이 아니라 작업자의 공개 선언입니다. 충돌이 나면 직접 메시지로 범위를 조정하고, 병합 충돌이 나면 최신 결과를 반영해 재검증·재병합합니다. 따라서 “탈중앙화”는 조정이 없음이 아니라 조정 책임이 작업자와 공유 프로토콜에 분산됨을 뜻합니다.[1, pp. 3–4]
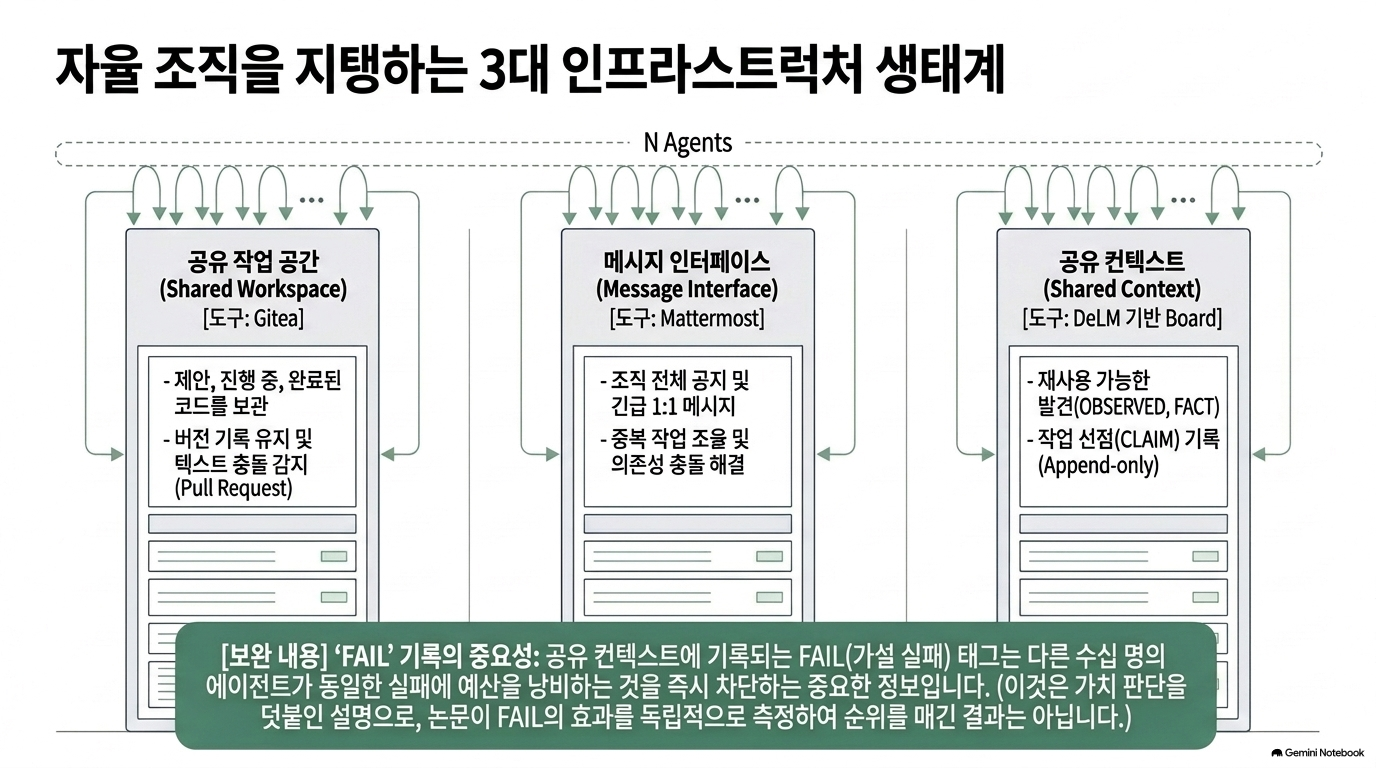
2.2 세 가지 조직 인프라
- 공유 작업공간: Git 기반의 개인 체크아웃·브랜치, 공용 main, 이슈와 PR을 사용합니다. 변경 이력을 보존하고 텍스트 충돌을 드러내며, 진행 중인 작업과 완료 결과를 함께 관리합니다.
- 메시지 인터페이스: 공용 채널은 일반 공지·진행 공유에, 직접 메시지는 급한 작업 범위 충돌이나 의존성 해결에 사용합니다. 전달 우선순위도 다릅니다.
- 공유 문맥: OBSERVED(관찰), FACT(확인 사실), FAIL(실패한 접근), CLAIM(진행 중인 일), PATCH_SUMMARY(완료 변경) 같은 유형화된 짧은 기록을 추가 전용으로 축적합니다. 최근 기록을 넘어서는 이력은 검색 도구로 찾습니다.[1, pp. 4–5]
이 설계에서 특히 가치 있는 항목은 FAIL입니다. 성공 사례만 공유하는 것이 아니라 틀린 가설과 실패한 시도를 조직의 재사용 가능한 지식으로 만들어, 다른 작업자의 중복 소모를 줄이려는 장치입니다.[1, pp. 4–5; Appendix A]
2.3 구현 경계
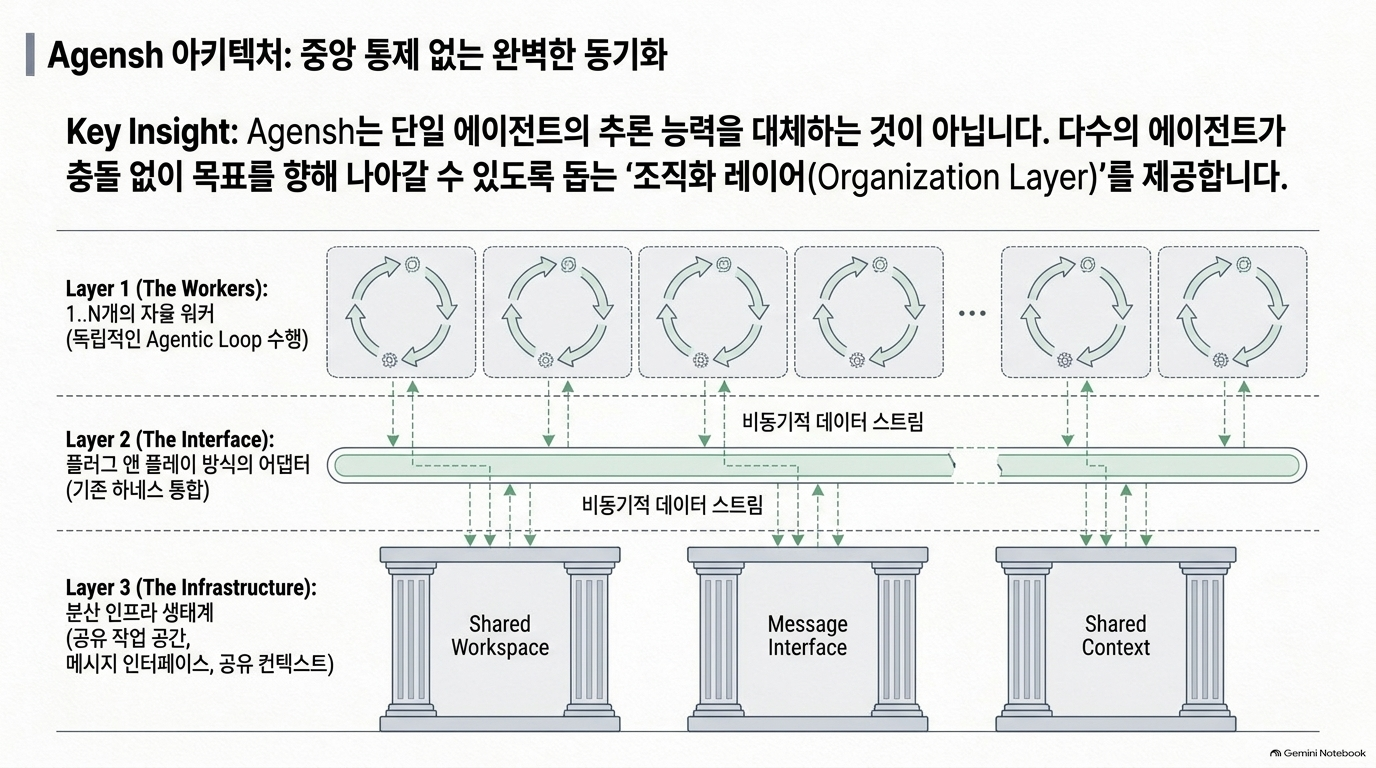
Agensh는 개별 에이전트의 추론·도구 실행 루프를 대체하지 않습니다. 그 위에서 작업자 식별, 이벤트 전달, 공유 상태, 통신, 복구 등을 제공하는 조직 수준의 하네스입니다. 보고된 실험에서는 개별 에이전트 하네스로 Copilot을, 공유 작업공간으로 Gitea를, 메시지로 Mattermost를 사용했습니다. 다섯 단계 협업 루프는 런타임에 강제 코딩하기보다 작업자 프롬프트의 작업 절차로 제공하며, 작업자 간 프롬프트 차이는 ID뿐입니다.[1, p. 5]
설계상 의미: 새로운 모델을 학습시키지 않고도 기존 단일 에이전트 실행기를 조직에 연결할 수 있습니다. 반면 효과의 일부는 모델·도구 자체뿐 아니라 프롬프트 준수, 공유 기록의 질, Git 병합과 이벤트 전달의 신뢰성에 의존합니다.
3장. Scaling Multi-Agent Organization to 1,024 Agents — 실험과 결과
실험 과제와 조건
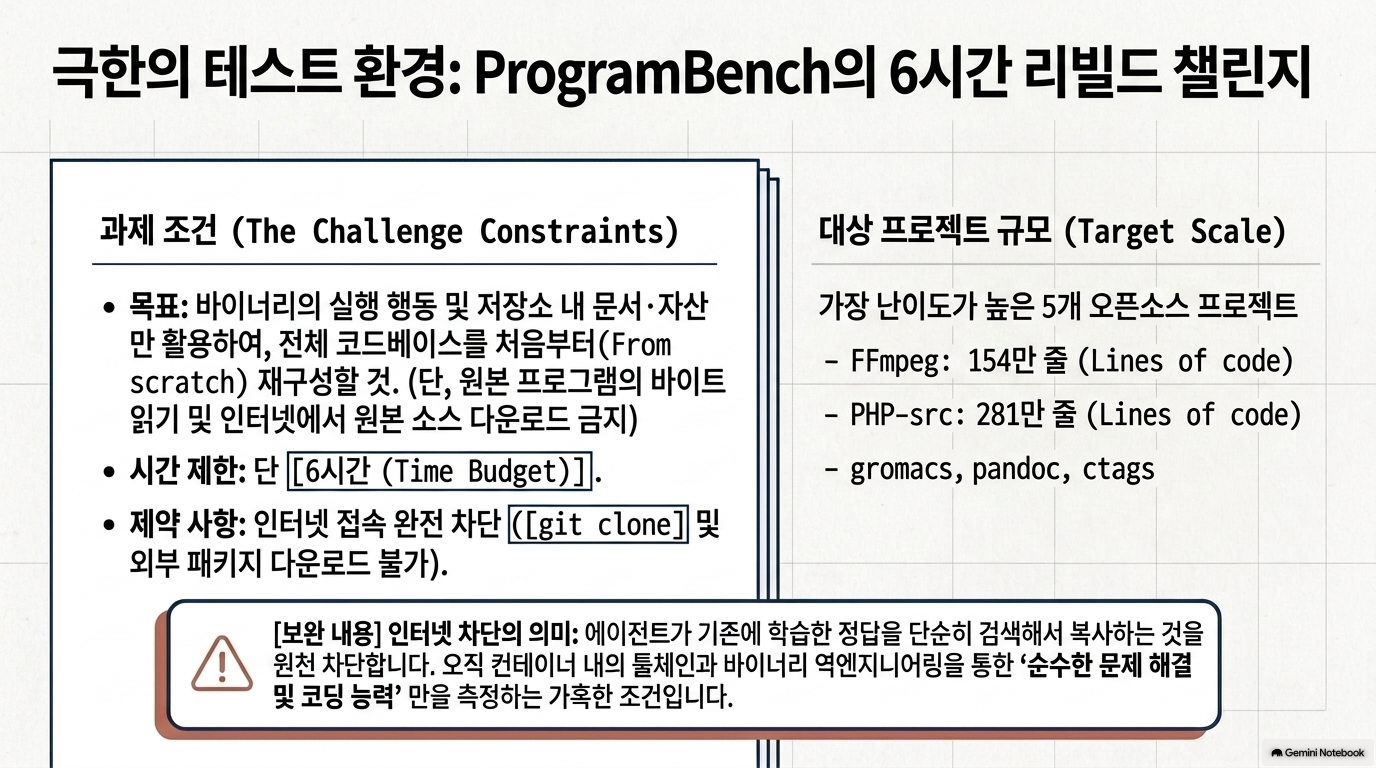
ProgramBench는 인터넷 없이 실행 가능한 참조 프로그램의 외부 행동을 관찰한 뒤, 이를 재현하는 코드를 처음부터 작성하게 합니다. 연구는 전체 200개 인스턴스 중 기존 모델 평균 통과율 기준으로 가장 어려운 다섯 과제인 FFmpeg, gromacs, pandoc, PHP-src, ctags를 선택했습니다. 과제의 기준 저장소 크기는 서로 크게 다릅니다. 예컨대 pandoc은 104,336줄, PHP-src는 2,812,757줄로 제시됩니다.[1, p. 6, Table 1; Appendix A–C]
모든 보고 구성에서 GPT-5.6-sol(high), Copilot 기반 하네스, 협업 프로토콜, 공식 평가 방식, 최초 작업자 활성화부터 6시간이라는 조건을 유지했다고 기술합니다. 평가지표는 최종 제출물의 canonical-kept 테스트 통과율입니다.[1, §3; Appendix C]
3.1 성능과 시간에 따른 결과
| 범위 | 에이전트 수 | 최종 테스트 통과율 |
| 5개 과제 평균 | 1 | 19.31% |
| 8 | 20.68% | |
| 32 | 26.52% | |
| 128 | 28.78% | |
| pandoc 단일 과제 | 1 | 33.89% |
| 128 | 50.94% | |
| 1,024 | 55.06% |
5개 과제 평균에서 1→128개 증가는 9.47%p, 초기값 대비 약 49% 상대 향상입니다. pandoc에서 128→1,024개 증가는 4.12%p이므로, 규모를 크게 늘려도 이 구간의 추가 이득은 앞선 증가만큼 크지 않습니다. 서로 다른 두 행의 기준인 5개 평균 19.31%와 pandoc 단독 33.89%를 직접 이어 붙여 해석하면 안 됩니다.[1, §3.1]
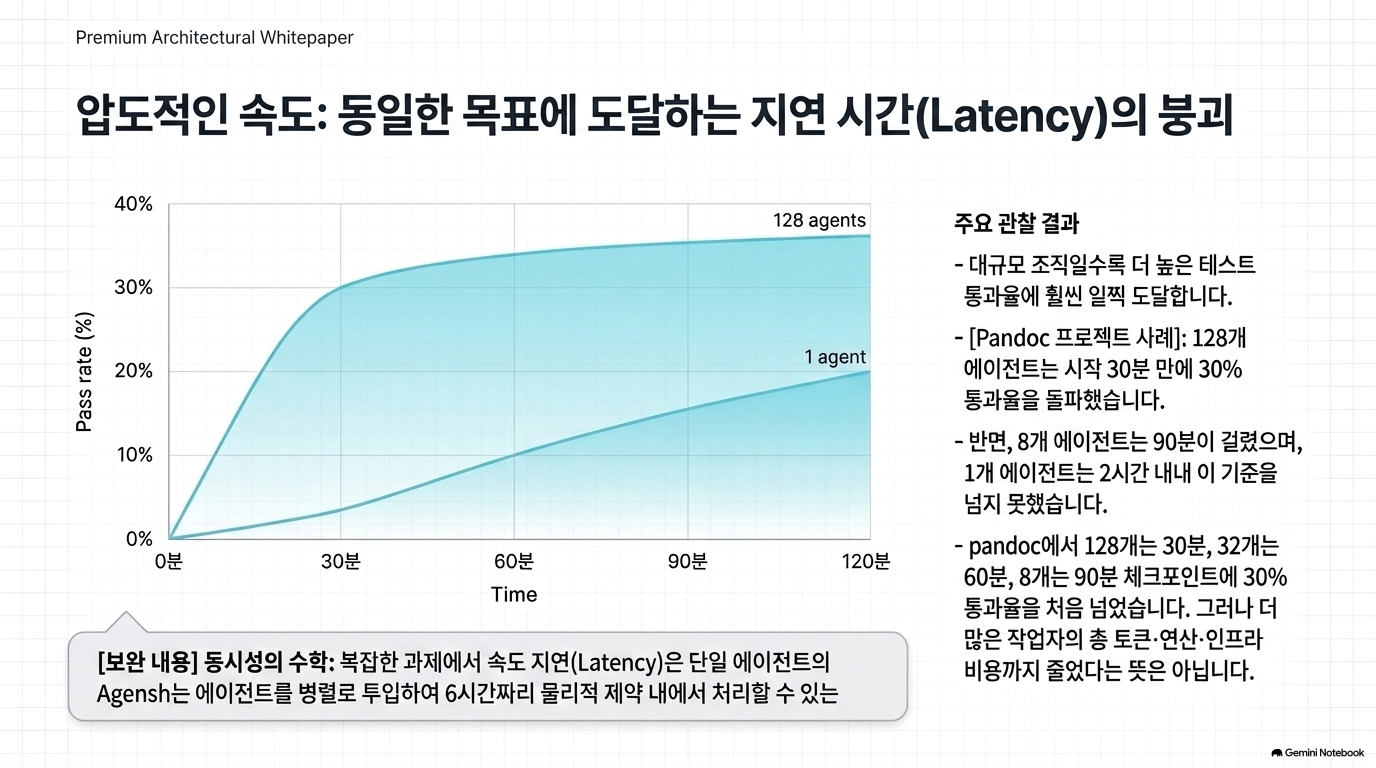
속도 측면에서 저자들은 pandoc의 30% 통과율 도달 시점을 예로 듭니다. 128개 구성은 30분 체크포인트, 32개는 60분, 8개는 90분에 처음 그 수준을 넘었으며, 단일 에이전트는 첫 2시간 동안 넘지 못했습니다. 다만 이것은 특정 점수 임계값까지의 경과시간에 관한 결과이지, 총 컴퓨팅 비용이나 토큰 효율이 좋아졌다는 증거는 아닙니다.[1, §3.1, Figs. 5–6]
3.2 규모에 따라 관찰된 협업 형태
이 절은 정량적 조직 지표보다는 작업자 궤적에서 발췌한 사례 분석입니다.[1, §3.2]
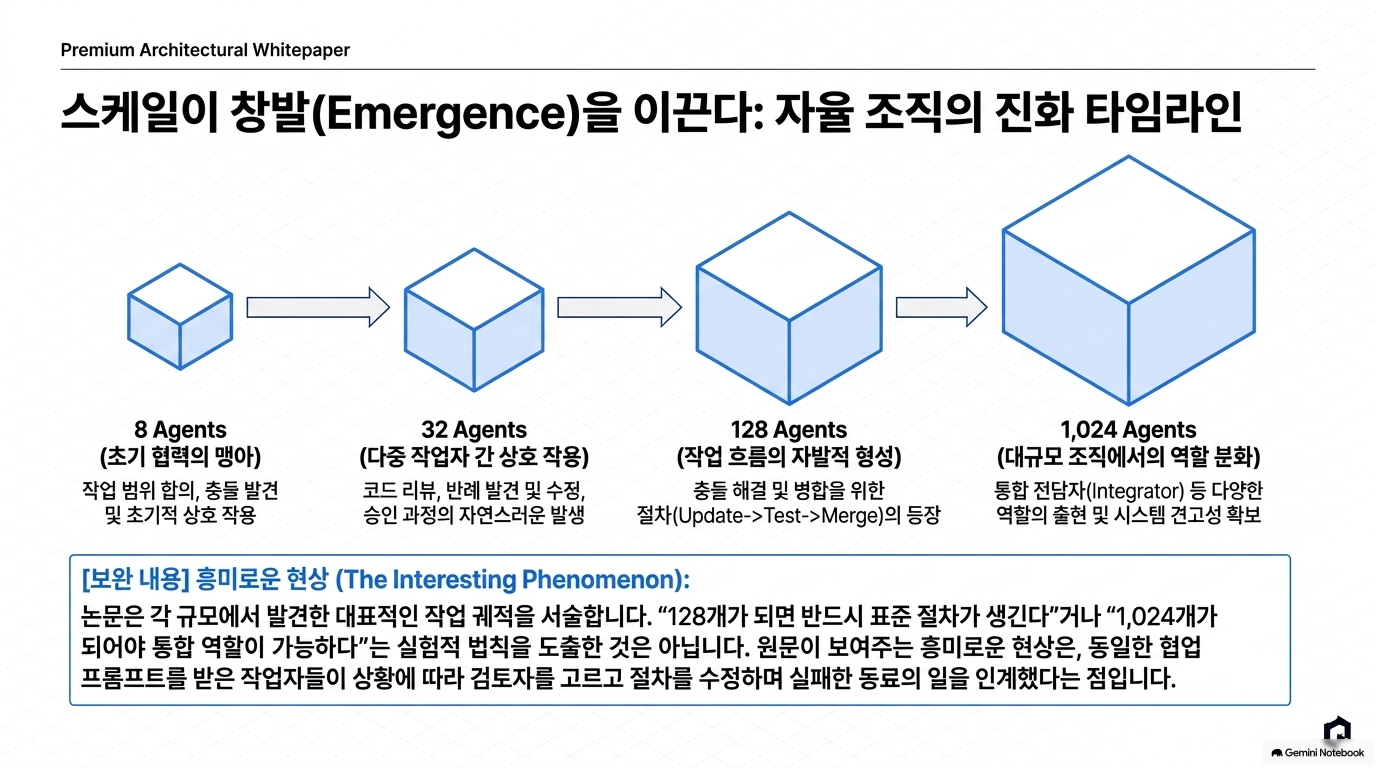
- 8개 — 동료 간 구현 조정: gromacs에서 인터페이스를 합의한 뒤 모듈을 분담했고, FFmpeg에서는 겹치는 작업을 대화 후 보완적인 범위로 바꿨습니다.
- 32개 — 다자간 통합·검토: PHP-src에서 처음 승인된 기여에 다른 작업자가 반례를 제시하자 승인을 철회하고 수정·재검토·병합했습니다.
- 128개 — 검토 전문화·절차 표준화: 관련 경험을 가진 검토자를 선택하고, pandoc에서는 브랜치 갱신→테스트→커밋 해시 전달→동료 검증·병합이라는 절차가 재사용·수정됐습니다.
- 1,024개 — 조직 규모의 역할 중복: pandoc에서 복수의 통합 담당자가 생겼고, 응답 가능한 담당자를 선택해 작업을 넘기거나 실패한 동료의 작업을 인계했습니다.
중요한 구별: 이 사례들은 “역할과 절차가 자발적으로 형성될 수 있다”는 존재 증거입니다. 논문이 모든 실행에서 같은 역할 분화가 재현된다거나, 그것이 성능 향상의 몇 %를 설명한다는 인과적 분석까지 제시한 것은 아닙니다.
4장. Related Work — 선행 접근과의 차이
저자들은 기존 연구를 크게 두 축과 비교합니다.[1, p. 8]
- 중앙 조정형 하네스: Claude Code의 리드 세션·에이전트 팀, Codex의 부모–하위 에이전트 위임, 학습된 오케스트레이터를 활용하는 Kimi Agent Swarm 등. 저자들이 강조하는 차이는 작업 발견, 의존성 조정, 결과 통합을 리드 에이전트에게 집중시키지 않는다는 점입니다.
- 공유 문맥·분산 조정: DeLM의 비동기 작업자 및 공유 문맥, Slack 기반 협업 시스템, Git과 작업 잠금으로 여러 에이전트를 조정한 사례, 공유 상태의 충돌 탐지에 집중한 STORM 등을 연결합니다.
따라서 Agensh가 “분산 협업 자체를 최초로 제안했다”는 뜻은 아닙니다. 기존의 공유 상태·통신·작업 통합 아이디어를 하나의 하네스와 반복 협업 루프로 묶어, 최대 1,024개 작업자까지 시험한 것이 이 보고서의 차별점입니다.[1, §4]
5장. Conclusion — 저자의 결론과 해석 범위
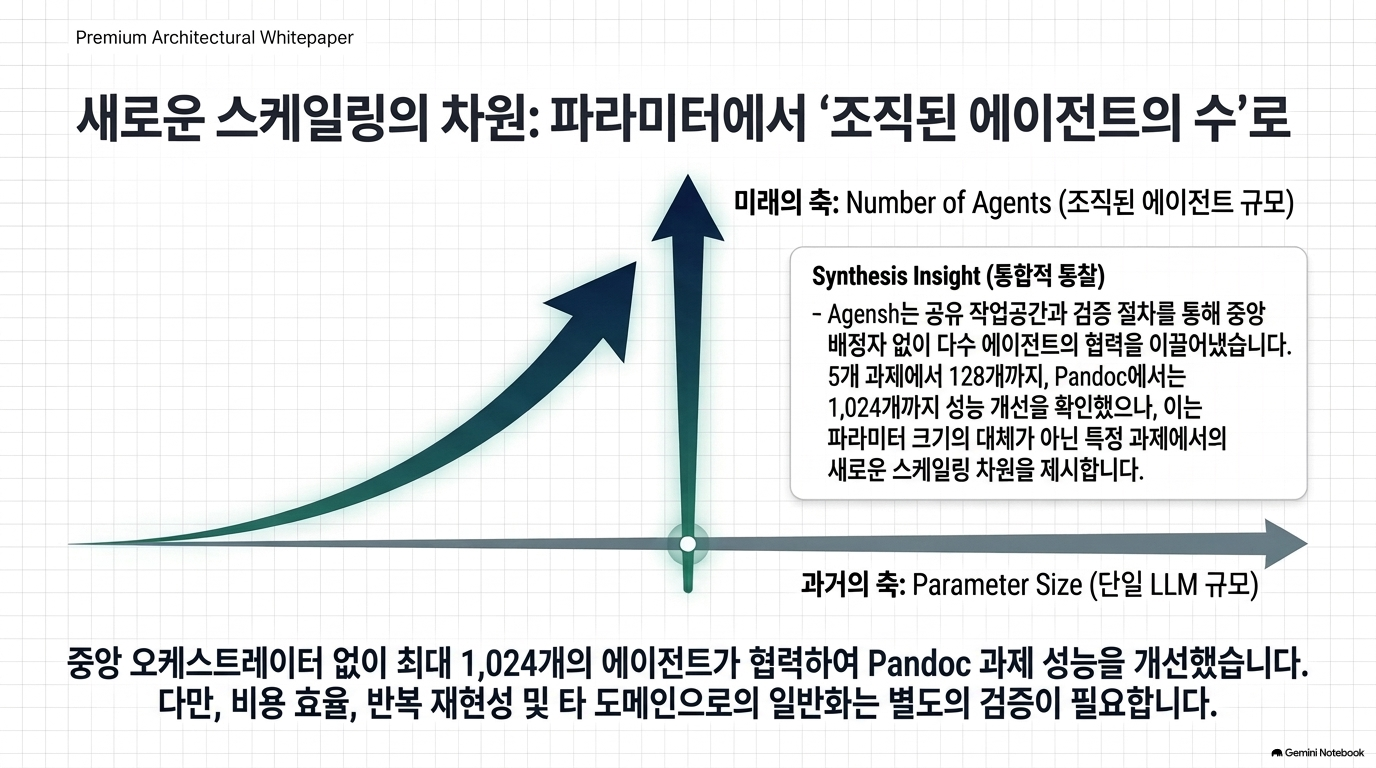
저자는 공유 작업공간·메시지·공유 문맥을 매개로, 중앙 오케스트레이터 없이도 작업자가 하위 과제를 찾고 성과를 누적할 수 있으며 에이전트 수가 새로운 확장 축이라고 결론짓습니다. 실험은 제한 시간 내 더 높은 테스트 통과율과 특정 점수에 더 빨리 도달하는 현상을 뒷받침합니다.[1, p. 8]
다만 “많이 투입할수록 언제나 효율적”이라는 결론은 아닙니다. 논문의 주된 최적화 목표는 고정된 6시간 안의 결과이며, 동일한 총 비용에서의 우위나 다른 업무 도메인으로의 일반화는 별도의 검증이 필요합니다.
부록 A–C — 재현·운영 관점에서 중요한 세부사항
- A. Worker Prompt: 1,024개 작업자에게 동일한 작업 규칙을 부여합니다. 참조 바이너리를 실행해 행동을 관찰하되 원본 바이트를 읽거나 역공학하지 못하게 하고, 루트의 compile.sh가 ./executable을 생성해야 한다는 제출 조건을 명시합니다. 공유 기록은 짧게 작성하고, CLAIM 충돌은 직접 해결하며, 구현 후 PR·병합·PATCH_SUMMARY 게시까지 작업자가 책임집니다.[1, Appendix A]
- B. Event-Driven Runtime: Gitea·Mattermost 이벤트를 작업자별 지속 큐에 넣고, 중복 제거·전달 재시도·세션 복원을 처리합니다. 일반 이벤트는 다음 턴에 전달하고, 직접 메시지와 새 공유 기록은 인프라 도구 반환 시 현재 턴에도 붙입니다. 임의로 실행 중인 프로세스 자체를 선점·중단하는 방식은 아닙니다.[1, Appendix B]
- C. Experiment Details: 대규모 실행에서는 작업자 활성화를 순차적으로 분산해 초기 충돌을 줄였고, 종료 45분 전에는 신규 기능보다 빌드·병합을, 5분 전에는 최종 통합을 독려했습니다. 1,024개 구성은 16개 노드에 노드당 64개 작업자로 배치했습니다. 단일 에이전트가 6시간을 지속하기 어렵다는 점에 대응해 별도의 계속 작업 프롬프트를 적용했고, 다중 에이전트에는 유휴 감지 후 계속 작업 프롬프트를 적용했습니다.[1, Appendix C]
비판적 평가 및 실무 시사점
강점: (1) 모델을 고정해 조직 규모의 효과를 관찰하려 했고, (2) 최종 점수뿐 아니라 시간별 성능과 협업 궤적을 함께 제시하며, (3) Git 이력·검증·병합을 개인 작업과 조직 성과 사이의 명시적인 경계로 둡니다.[1, §§2–3]
해석상 제약:
- 비용 대비 효율 미입증: 1,024개 구성이 128개보다 pandoc 점수는 높지만, 추가 토큰·컴퓨팅·운영비를 고려한 비용-효과 비교는 제시되지 않습니다.
- 대규모 일반화 범위: 1,024개 결과는 pandoc 한 과제입니다. 5개 과제 모두에서 1,024개로 확장된 것은 아닙니다.
- 효과의 원인 분리 부족: 작업자 수 증가와 비교해 공유 문맥, 메시지, 작업 선언, Git 통합 중 어느 요소가 얼마나 기여했는지 분리하는 제거 실험은 본문에 제시되지 않습니다.
- 반복 실행의 불확실성: 보고서의 수치만으로 실행 간 분산·신뢰구간이나 조직 행동의 재현성을 판단하기 어렵습니다.
- ‘완전 무중앙’으로 오해하면 안 됨: 업무 배정의 중앙 오케스트레이터는 없지만 Gitea·Mattermost·공유 문맥 서비스·이벤트 라우터라는 공통 인프라는 존재하며, 종료 전 전체 작업자에게 운영상 알림도 보냅니다.[1, §§2–3; Appendix B–C]
실무 적용의 핵심은 대규모 에이전트를 곧바로 투입하는 데 있지 않습니다. 먼저 작업 범위 선언 → 검증 가능한 인수 기준 → 실패 지식 공유 → 변경 이력과 병합 책임을 구현해야 합니다. 과제가 독립적으로 나뉘고 결과를 자동 시험할 수 있으며 제한 시간이 중요한 경우에는 이 구조가 유망합니다. 반대로 판단의 정당성·대외 책임 소재가 중요한 업무라면, 저자의 자율적 병합 절차에 인간 승인과 감사 가능한 결정 기록을 추가해야 합니다. 이는 논문의 직접 실험 결과가 아니라 그 설계를 실무에 옮길 때의 적용 판단입니다.
Sources
[1] 논문 원문 PDF — Agensh: Scaling Organizational Intelligence to 1,024 Agents, v1
[2] arXiv 서지·버전 정보