AI 반도체 - HBM을 넘어선 3D-DRAM: AI 추론 가속기의 메모리 병목을 풀 수 있을까?
https://www.chiplog.io/p/why-stacked-3d-dram-is-the-right
2026.9.23
[Why stacked 3D-DRAM is the right future for AI inference accelerators]
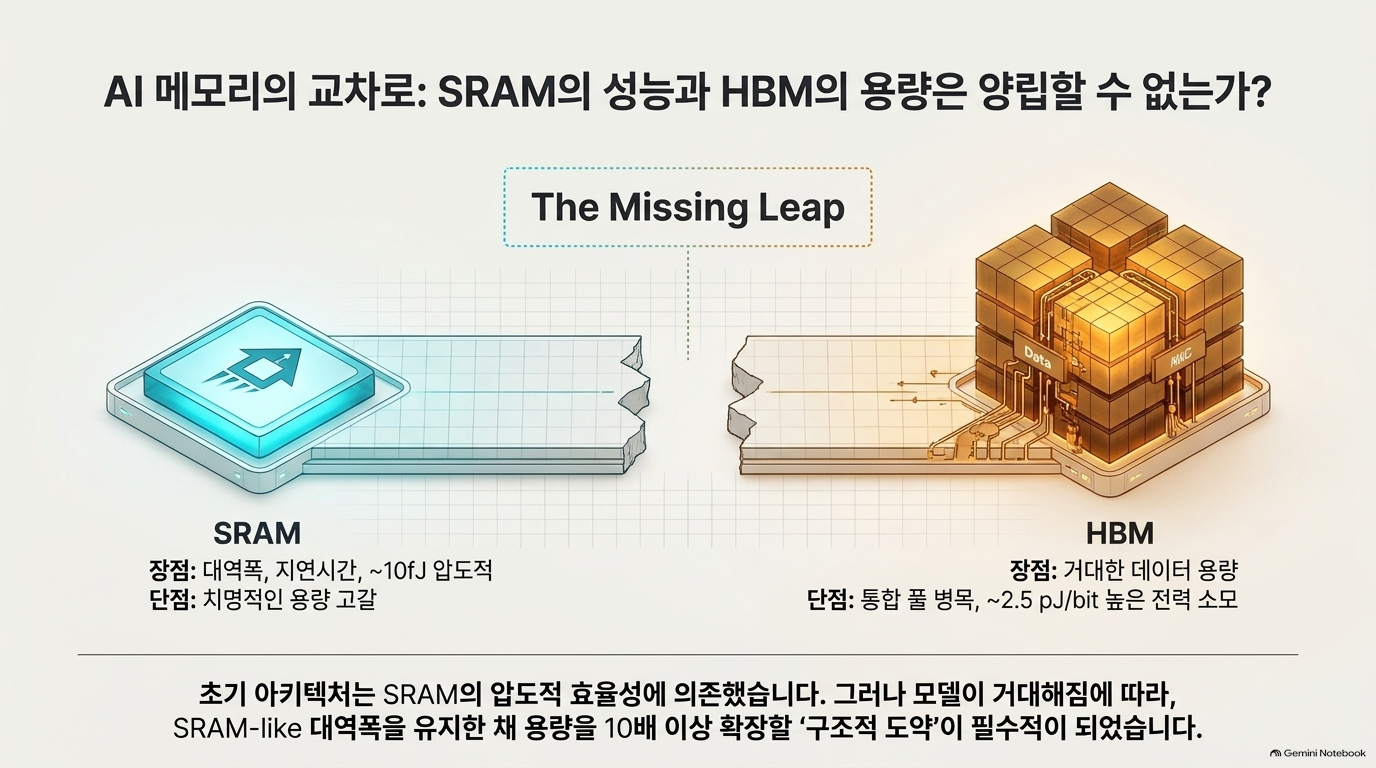
이 글은 차세대 AI 추론 가속기의 핵심 기술로 부상한 3D 적층형 DRAM의 기술적 우위와 필연성을 상세히 분석합니다. 저자는 메모리를 연산 장치 바로 위에 수직으로 쌓는 방식이 기존 HBM보다 뛰어난 압도적인 대역폭과 에너지 효율성을 제공하며, 특히 데이터 이동 거리를 최소화하여 전력 소모를 획기적으로 절감할 수 있음을 강조합니다. 또한, 3D DRAM은 복잡한 보정 과정 없이도 SRAM과 유사한 결정론적 성능을 구현할 수 있어 고성능 컴퓨팅 설계에 최적이라는 점을 설명합니다. 결론적으로 이 텍스트는 d-Matrix의 Raptor와 같은 구체적인 사례를 통해, 용량 한계와 전력 병목 현상을 동시에 해결하려는 반도체 업계의 미래 전략을 명확히 제시하고 있습니다.
핵심 판단
이 글의 주장은 “추론 가속기의 병목은 연산 자체보다 메모리에서 연산기로 데이터를 옮기는 비용이며, DRAM을 연산 다이 위에 쌓으면 SRAM 중심 설계의 빠른 데이터 공급을 더 큰 용량으로 확장할 수 있다”는 것입니다. 방향성은 설득력 있습니다. 다만 글의 수치를 상용 제품에서 검증된 추론 성능으로 읽어서는 안 됩니다. 저자는 d-Matrix의 3D-DRAM 구현에 참여했다고 명시합니다.[1]
논지와 근거
| 논점 | 원문의 주장 | 분석 |
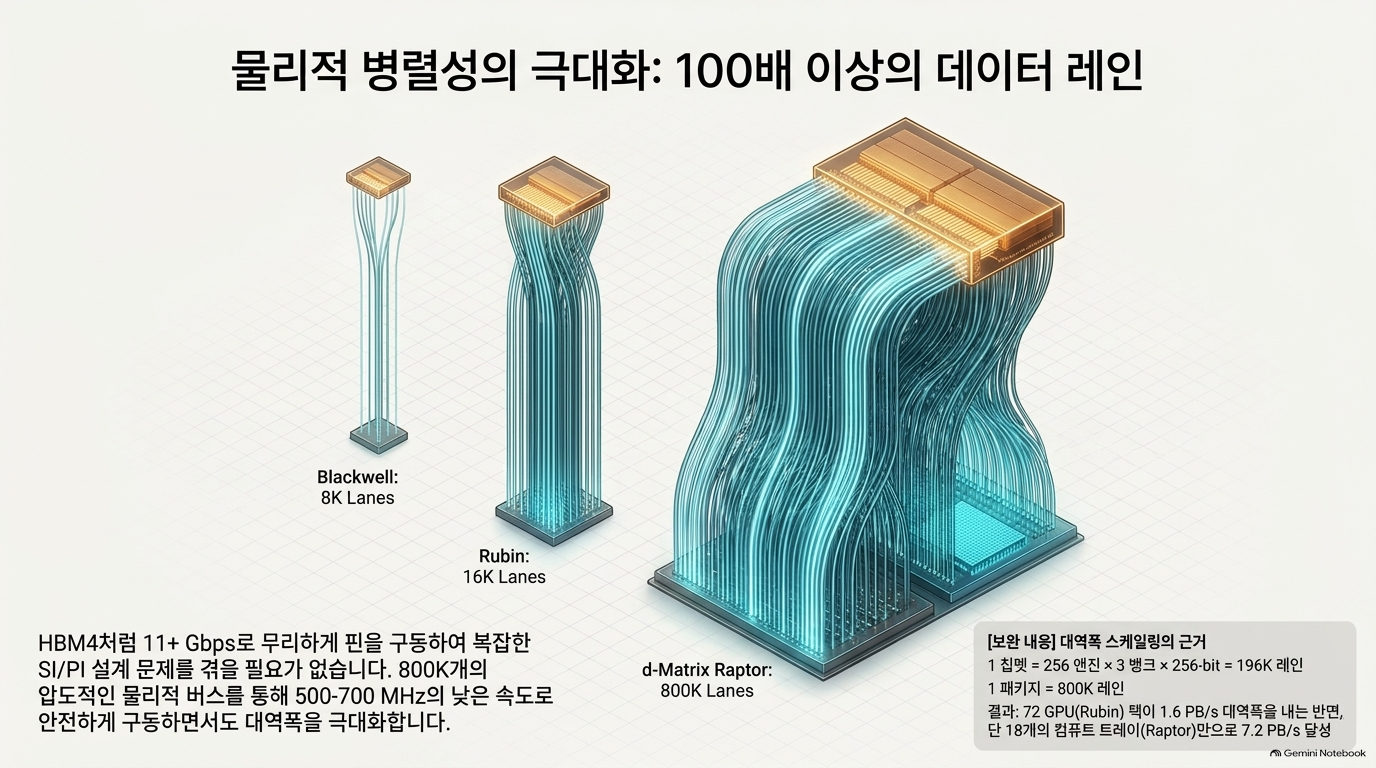
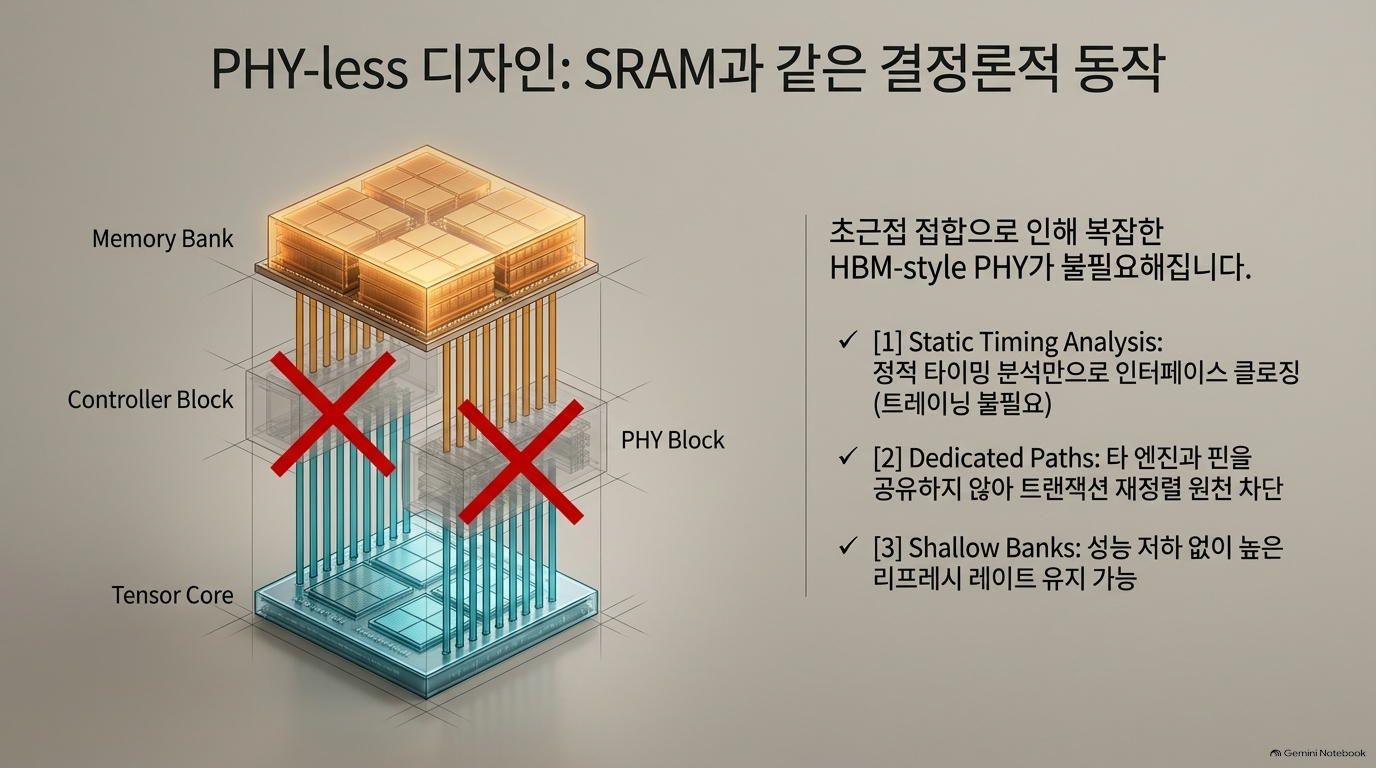
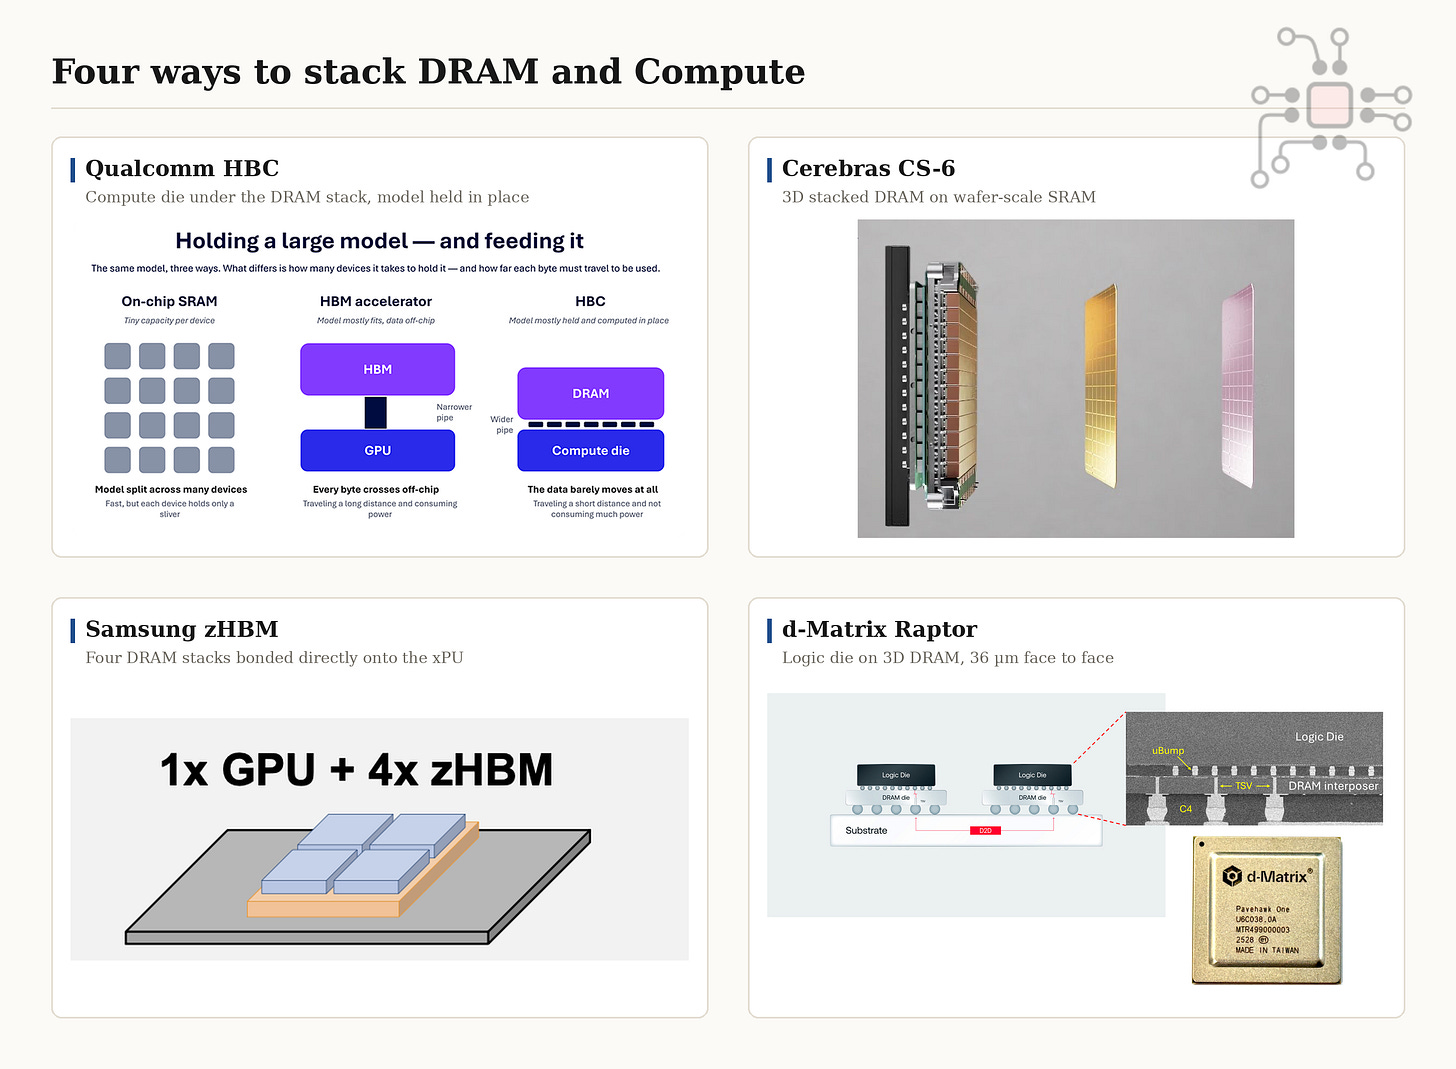
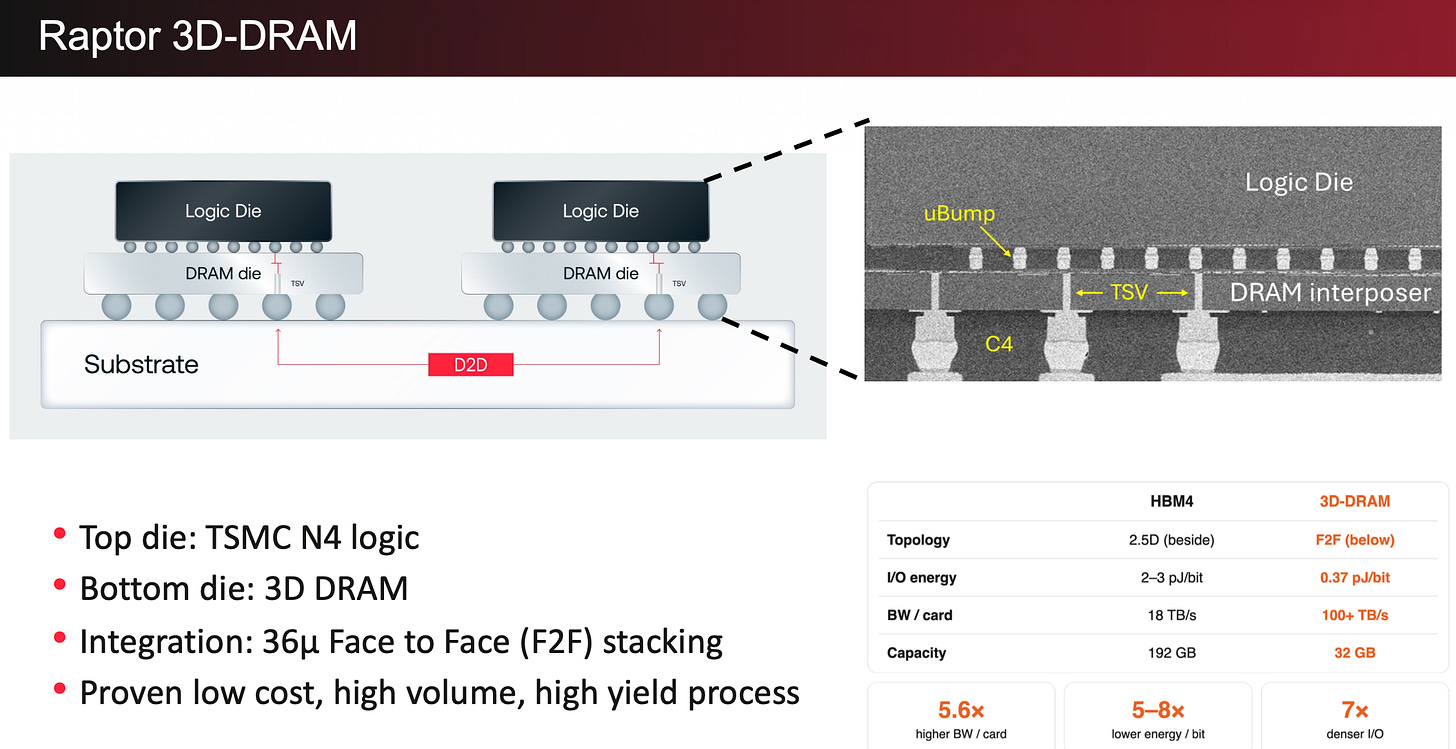
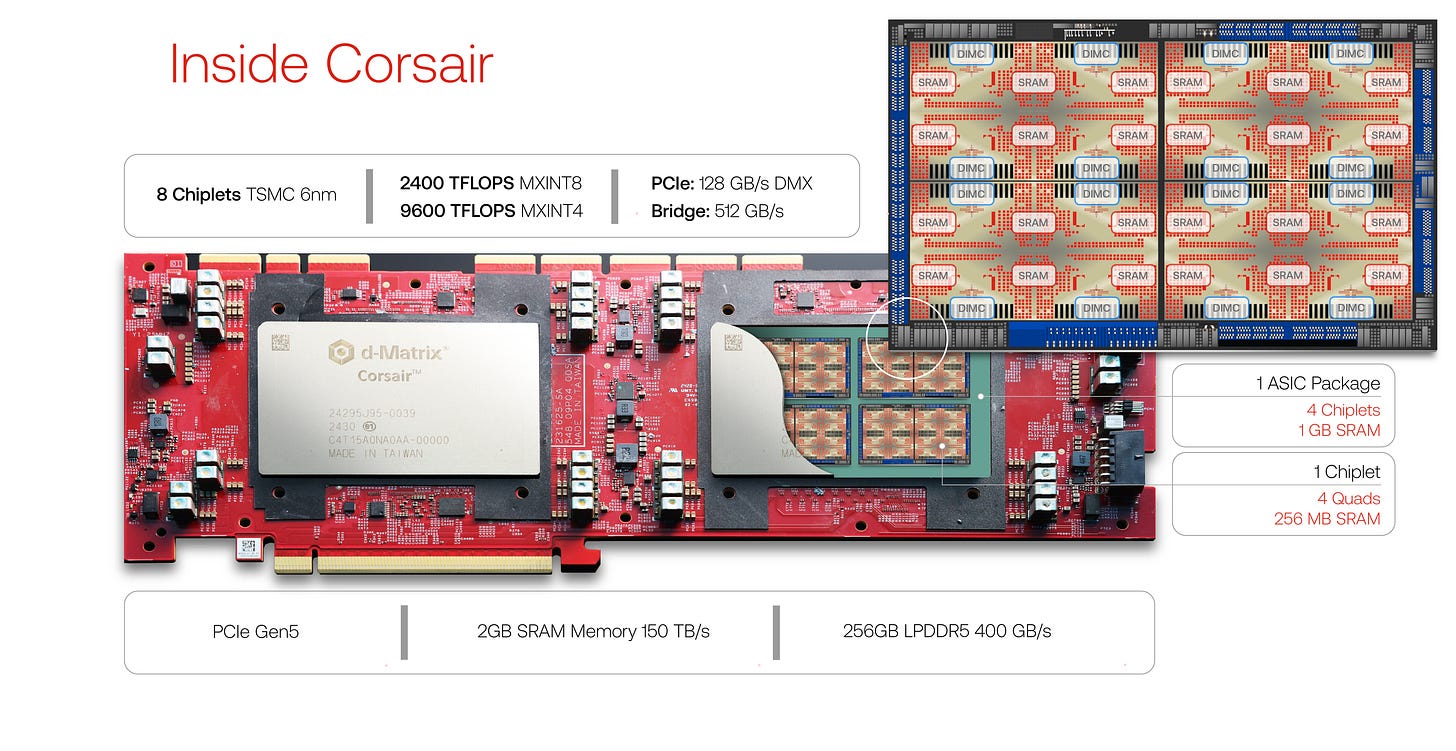
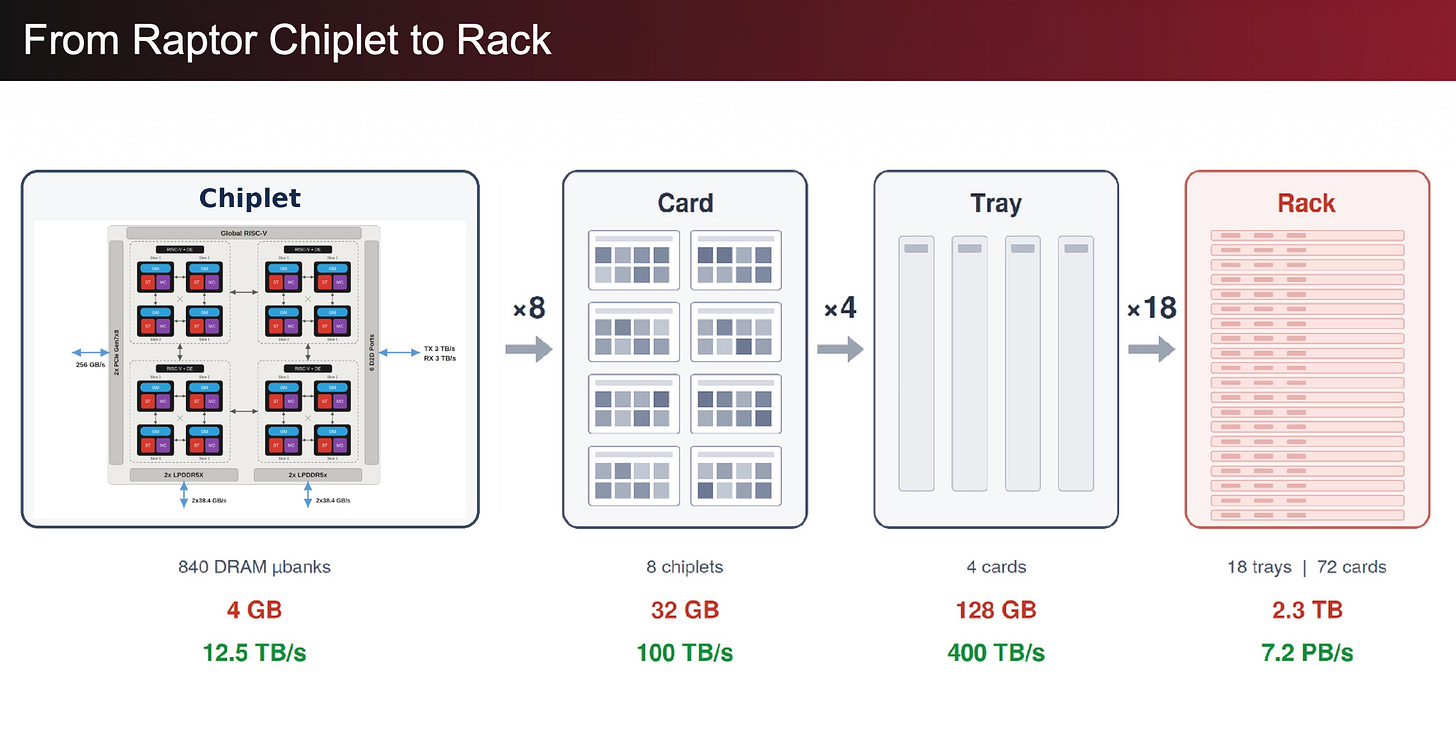
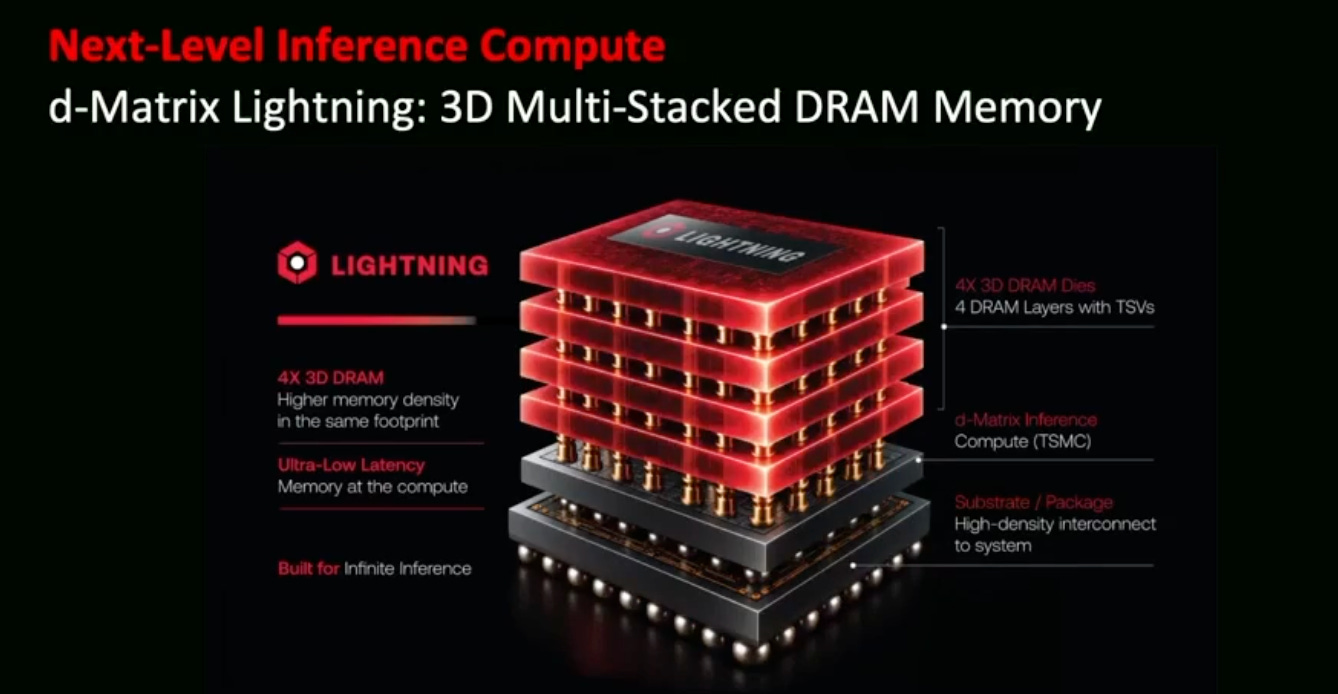
| 구조·대역폭 | Raptor의 각 텐서 엔진에 전용 DRAM 뱅크와 배선을 배정한다. 칩렛당 데이터 선로는 256 엔진 × 3 뱅크 × 256비트 = 196,608개다.[1] | 공유 메모리 경합을 줄이는 설계상의 이점은 명확하다. 다만 선로 수나 피크 대역폭이 실제 모델의 처리량·토큰 지연시간을 보장하지는 않는다. |
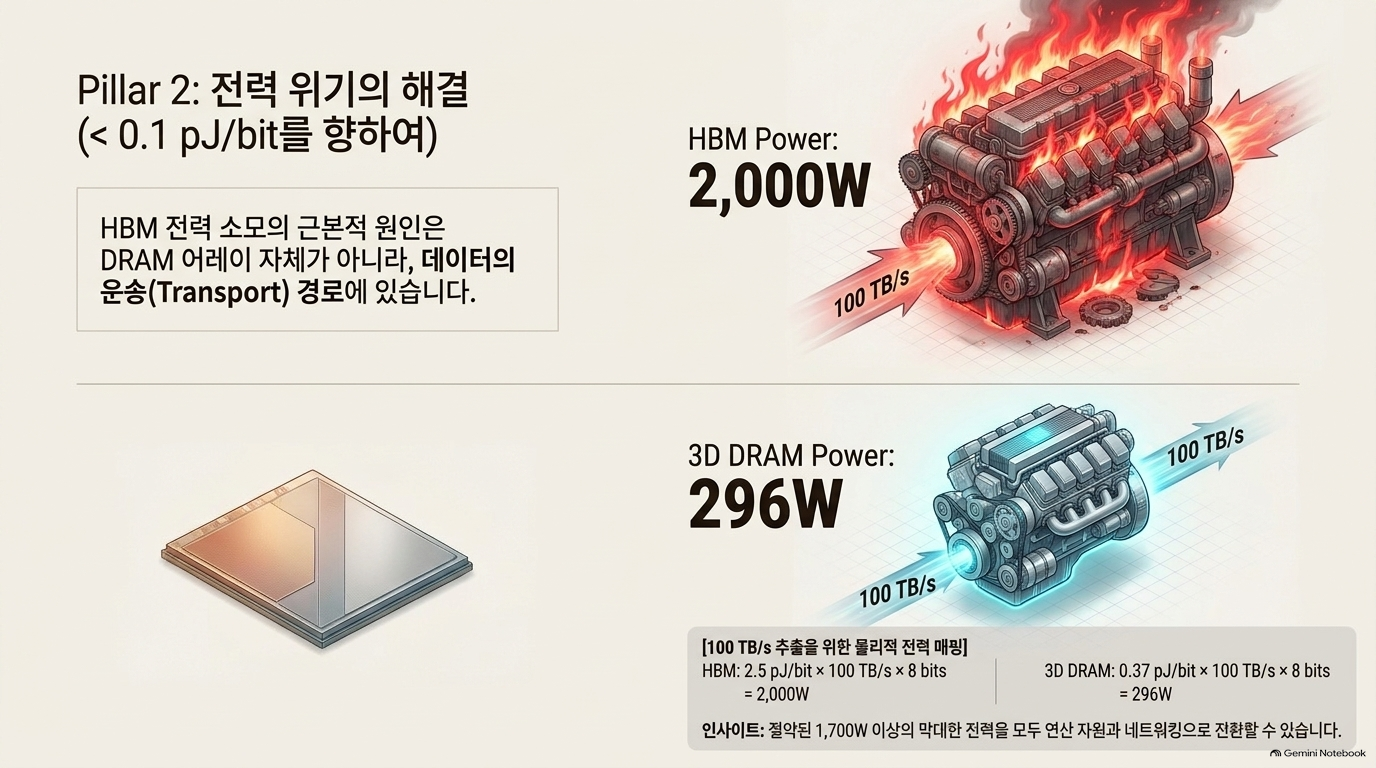
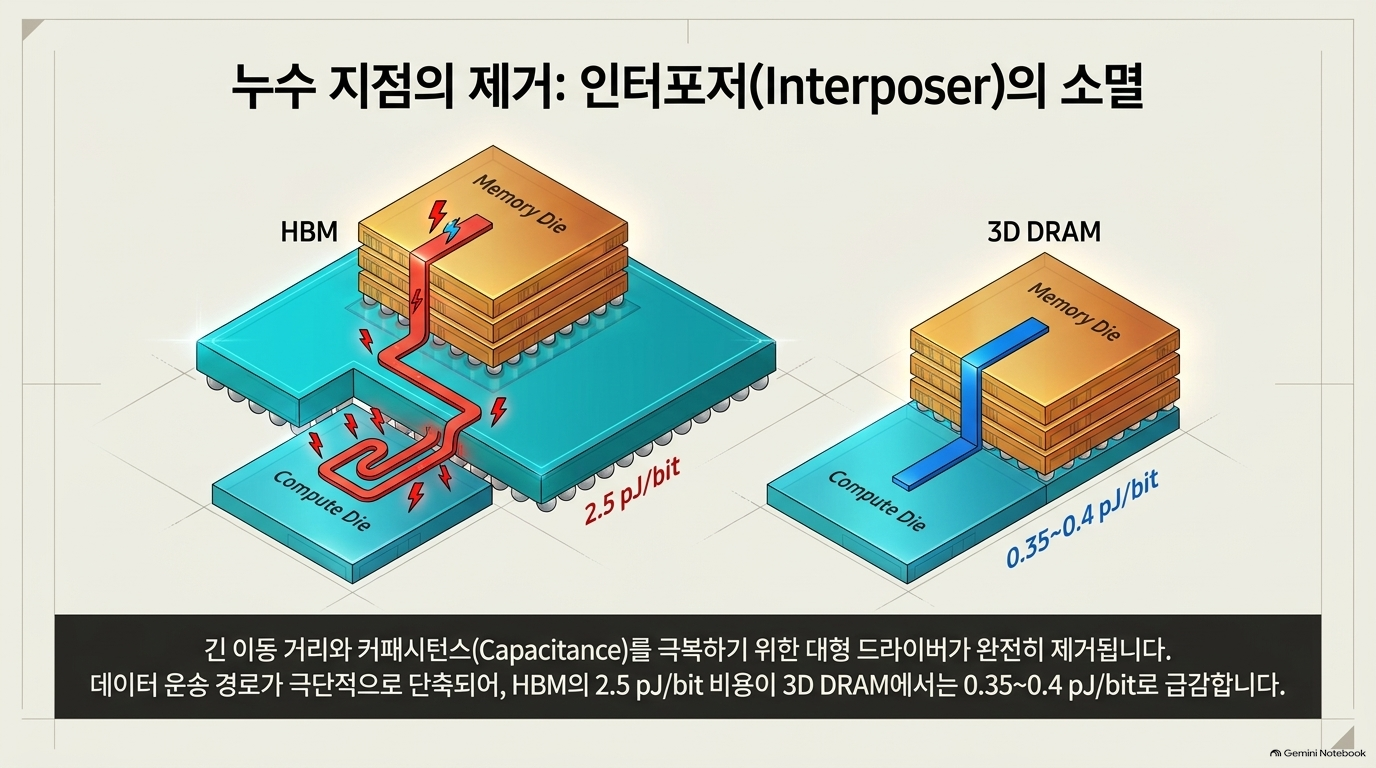
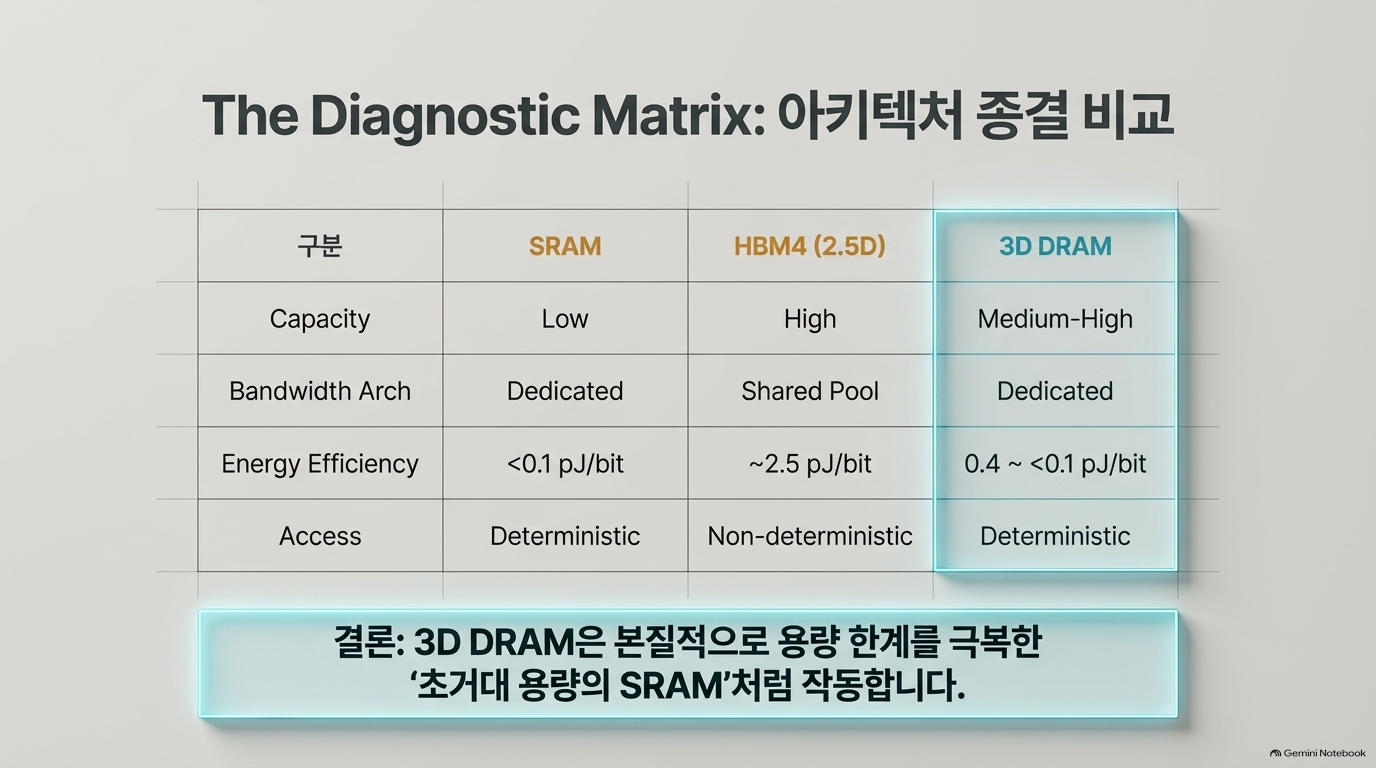
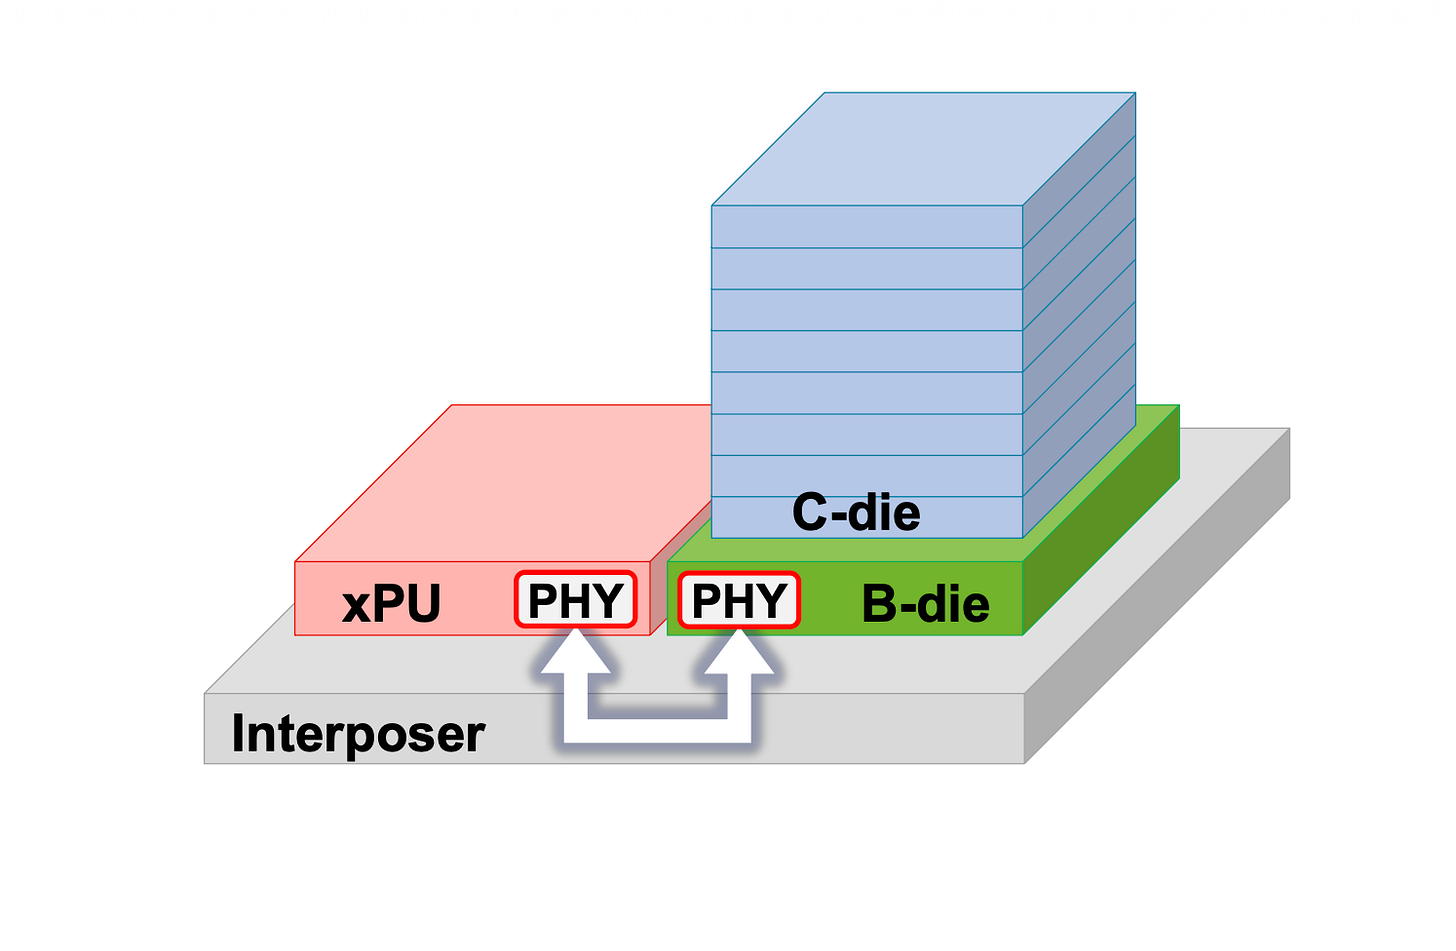
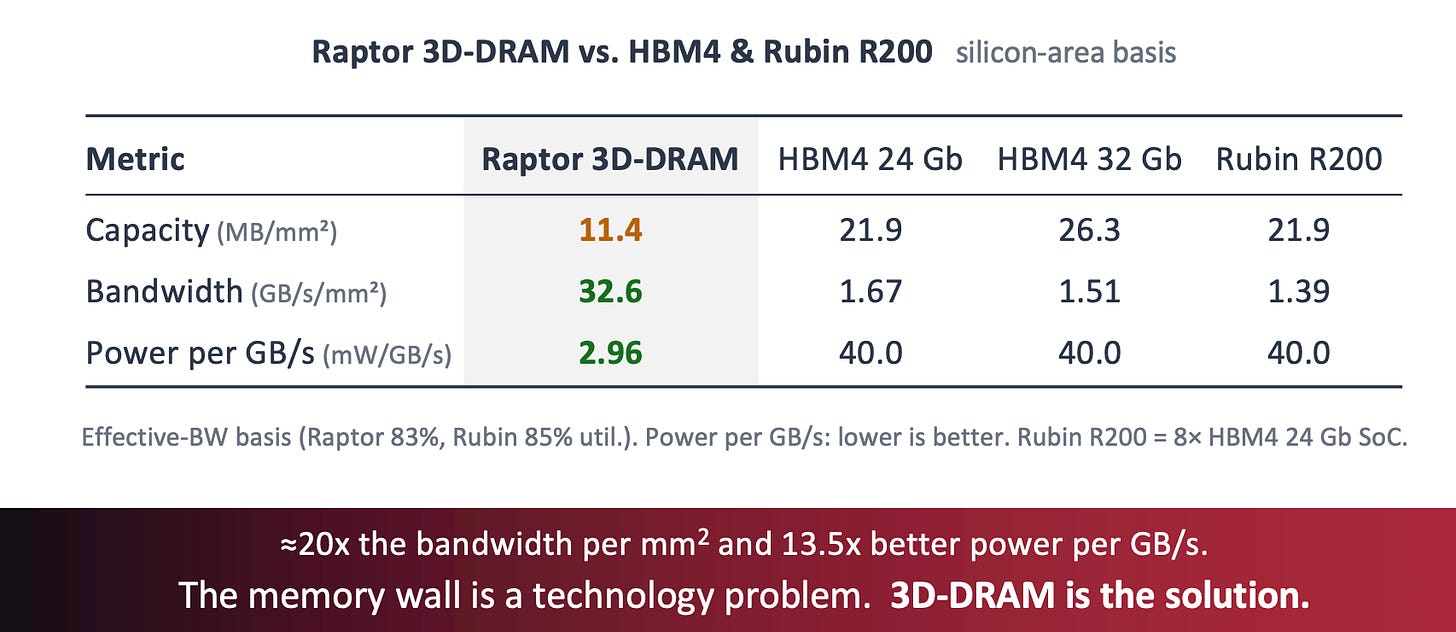
| 전력 | 데이터 전송 에너지를 HBM 약 2.5 pJ/bit, 직접 적층 DRAM 약 0.37 pJ/bit로 놓는다. 같은 100 TB/s를 전송하면 각각 2,000 W와 296 W라는 계산이다.[1] | 제시한 가정에 따른 산술은 맞고, 차이는 약 6.76배다. 이는 해당 메모리 데이터 전송 에너지의 비교이지, 시스템 전체 소비전력이나 총 추론비용이 6.76배 개선된다는 뜻은 아니다. |
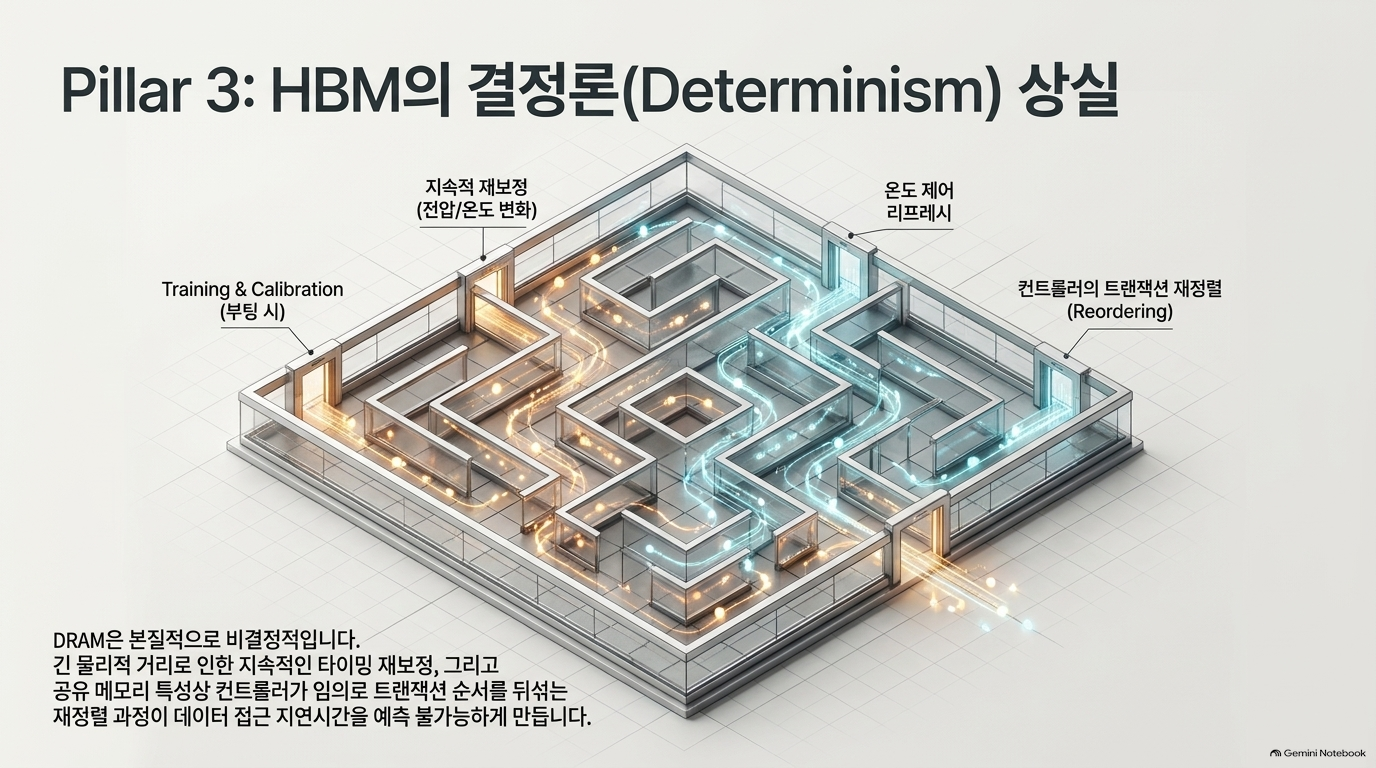
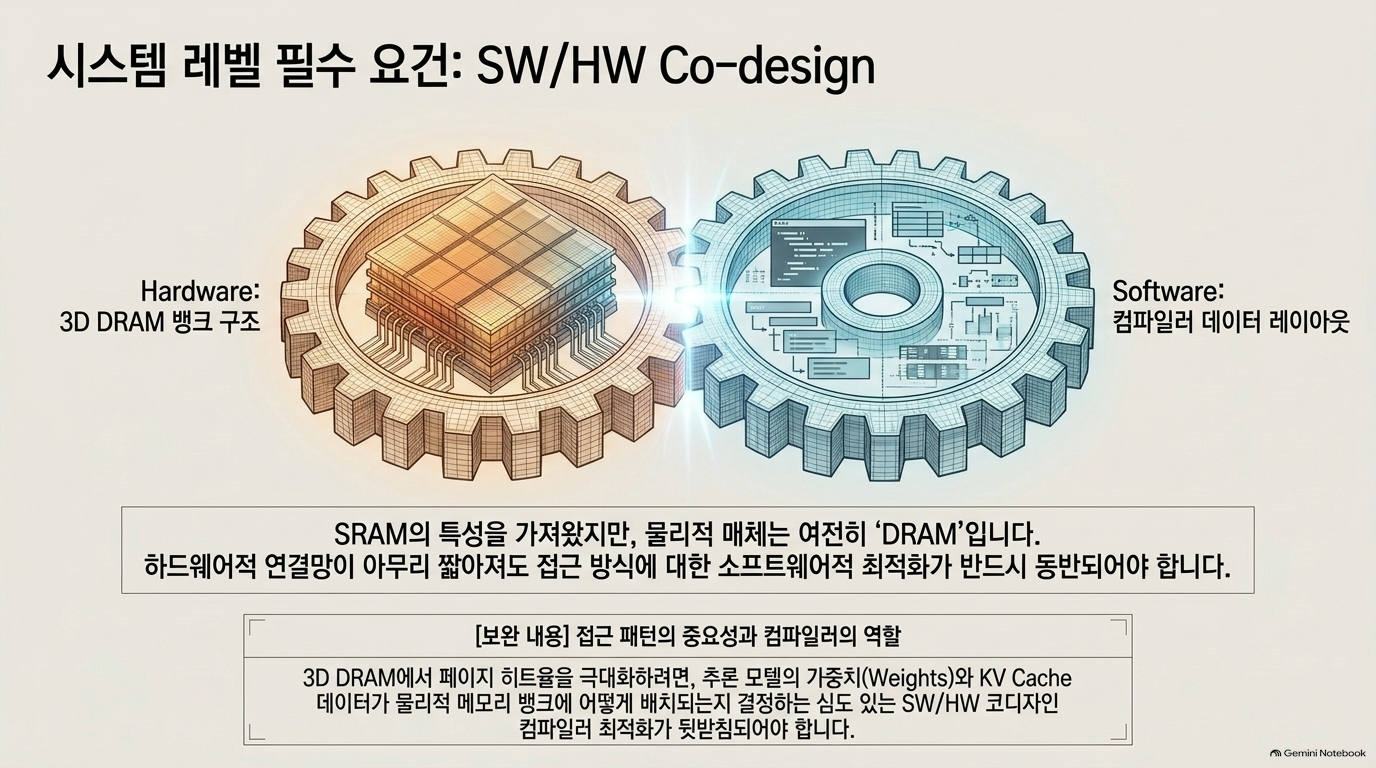
| 지연시간 예측성 | 엔진별 전용 경로와 단순한 컨트롤러를 사용하면 HBM의 공유·재정렬에 따른 변동을 줄일 수 있다.[1] | ‘예측 가능하게 설계할 수 있다’는 해석이 적절하다. DRAM 리프레시와 페이지 적중률은 여전히 관리해야 하며, 원문도 가중치·KV 캐시 배치를 위한 SW/HW 공동설계를 인정한다.[1] |
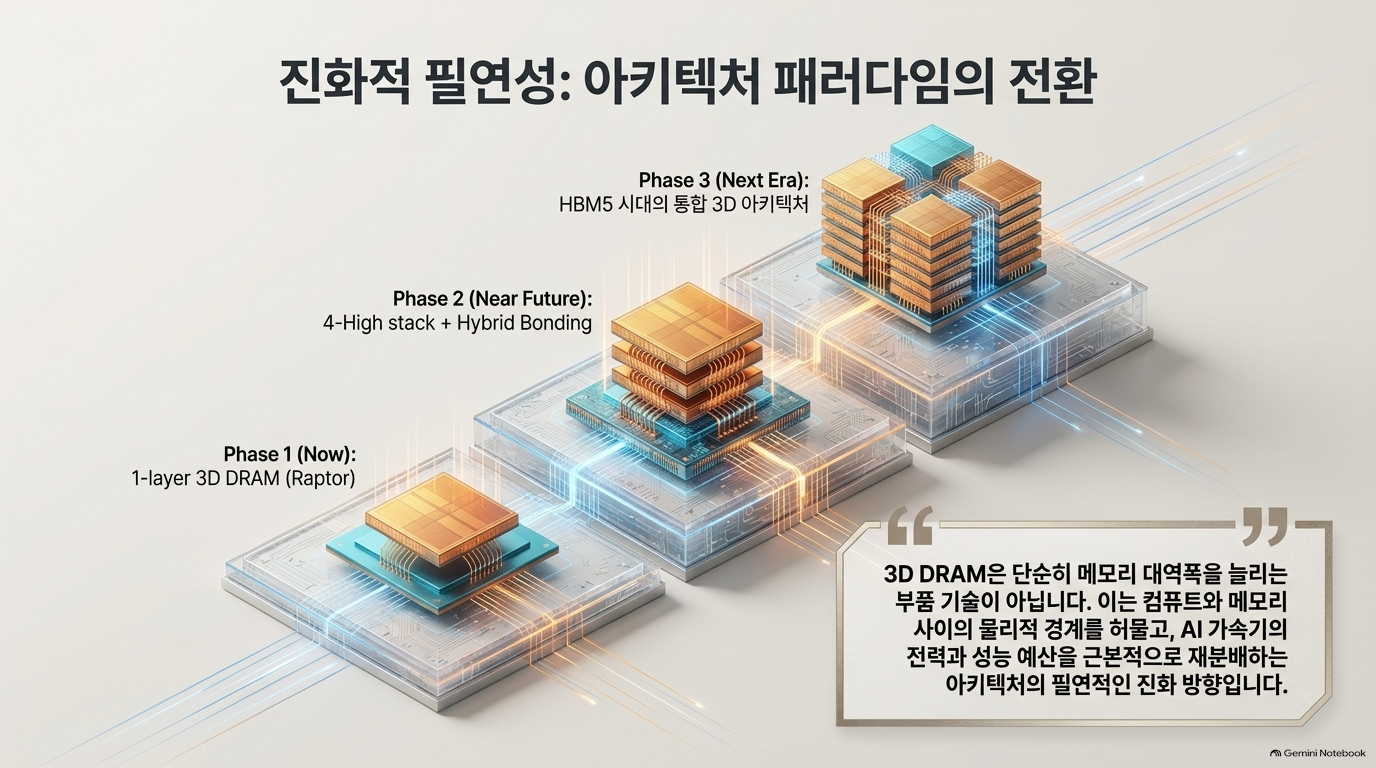
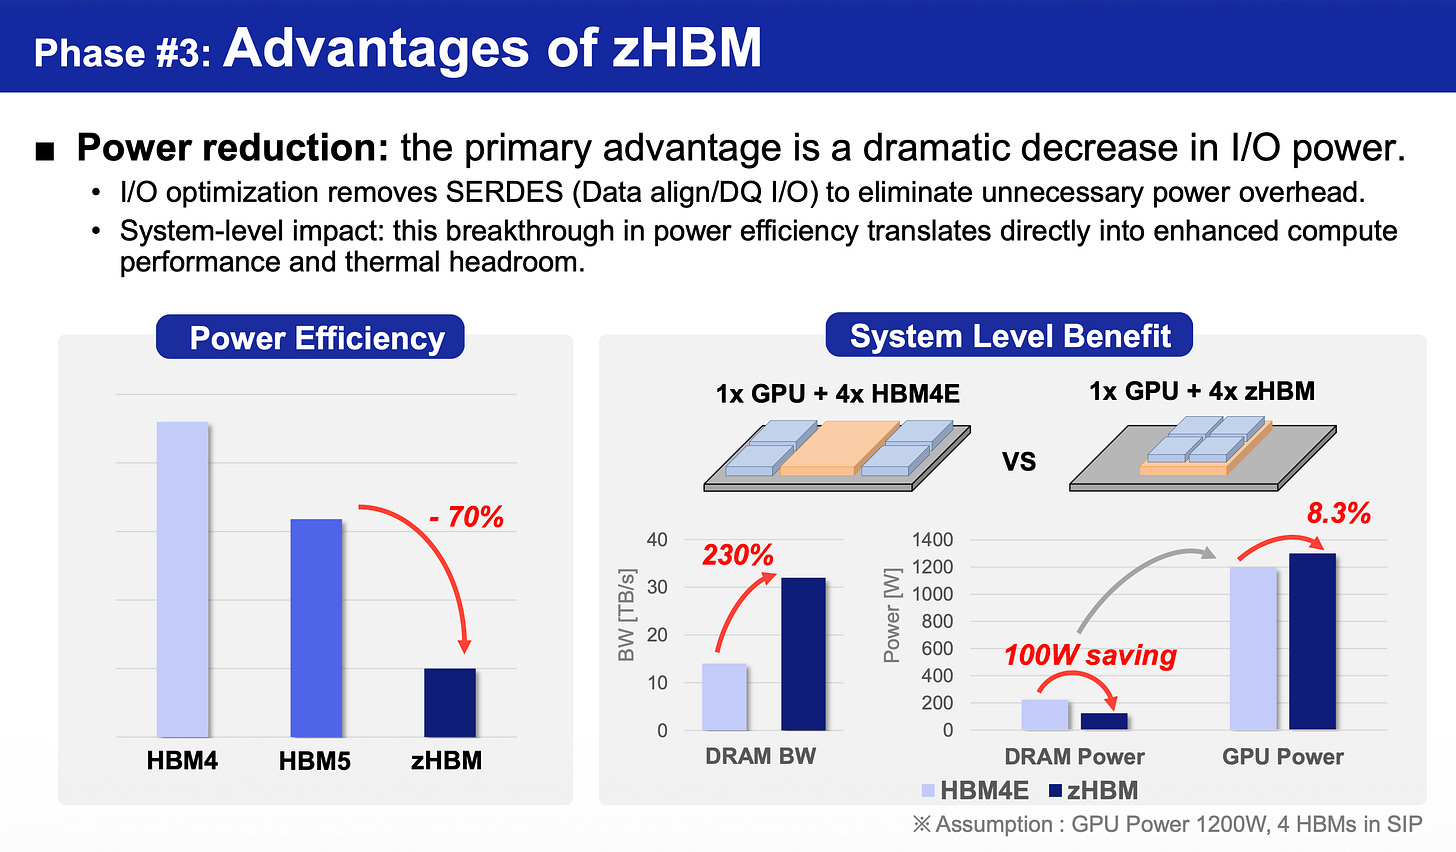
특히 제목의 “0.1 pJ/bit 미만”은 Raptor의 현재 제시값이 아닙니다. 원문은 Raptor의 마이크로범프 연결에 대해 약 0.37 pJ/bit를 제시하고, 더 미세한 하이브리드 본딩을 적용하면 약 0.1 pJ/bit로 내려갈 수 있다고 전망합니다. 삼성 역시 zHBM을 공개했지만 이를 차세대 콘셉트 및 기대 성능으로 설명합니다.[1][2]
비판적으로 볼 지점
- 비교 대상의 범위가 다릅니다. 원문은 Raptor 랙의 메모리 대역폭 7.2 PB/s와 Rubin NVL 랙의 HBM 대역폭 1.6 PB/s를 비교합니다. 이는 명목상 4.5배이지만, 서로 다른 연산기·용량·네트워크·소프트웨어를 가진 시스템의 메모리 대역폭 비교입니다. 이를 추론 처리량 4.5배로 해석할 수는 없습니다.[1]
- 전용 메모리는 장점이자 제약입니다. 엔진별 데이터 공급은 유리하지만, 모델 가중치나 KV 캐시가 엔진별 할당을 넘어서거나 워크로드가 불균형하면 데이터 재배치·엔진 간 통신이 중요해집니다. 따라서 성능 평가는 ‘총 대역폭’보다 실제 모델에서의 유효 대역폭, 첫 토큰 시간, 토큰당 지연시간, 와트당 토큰으로 해야 합니다.
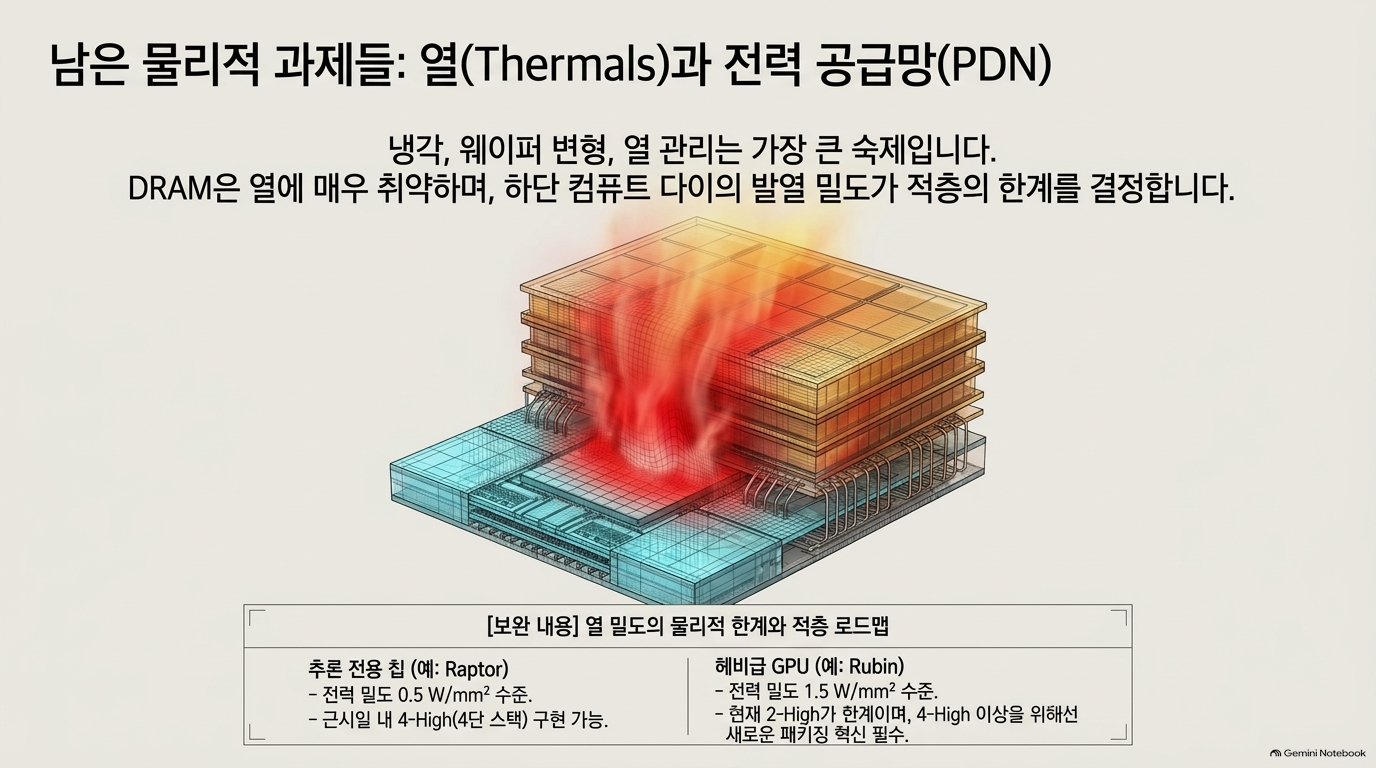
- 열·수율·제조 비용은 아직 핵심 검증 항목입니다. 저자도 냉각, 휨, 전력망, 수율을 과제로 들고, 4단 적층 가능성에 관한 판단은 자신의 경험과 직관에 근거한다고 밝힙니다.[1] NVIDIA와 d-Matrix의 NVLink Fusion 협력 발표는 랙 규모 통합 계획을 뒷받침하지만, 이 기사에 나온 메모리 효율이나 추론 성능 수치의 독립 검증은 아닙니다.[3]
결론: 이 글은 3D-DRAM이 왜 저지연 AI 추론에 매력적인 아키텍처인지 설명하는 기술적 주장으로 가치가 큽니다. 투자·도입 판단에서는 현재 구현값(약 0.37 pJ/bit), 차세대 목표(약 0.1 pJ/bit), 피크 대역폭, 실제 추론 벤치마크를 분리해서 보시는 것이 핵심입니다.[1]
Sources
[1] Chip Log — Why stacked 3D-DRAM is the right future for AI inference accelerators
[2] Samsung — Next-Gen 3D-Memory Vision at FMS 2026
[3] NVIDIA — d-Matrix Adopts NVLink Fusion