AI 해석력 - IPW : 로컬 AI의 지능 효율성 측정
https://arxiv.org/pdf/2511.07885
2026.8.7
[Intelligence per Watt: Measuring Intelligence Efficiency of Local AI]
이 연구는 중앙 집중식 클라우드 서버의 부하를 줄이기 위해 개인용 기기에서 실행되는 로컬 AI의 효율성을 분석하고, 이를 측정하기 위한 새로운 표준으로 와트당 지능(IPW)이라는 지표를 제안합니다. 저자들은 2023년부터 2025년 사이의 기술 발전을 추적하며, 소규모 언어 모델이 이제는 실제 사용자 질의의 약 89%를 성공적으로 처리할 만큼 정교해졌으며 에너지 효율 또한 5배 이상 개선되었음을 입증합니다. 특히 노트북과 같은 로컬 가속기가 클라우드 인프라보다 전력 대비 성능 면에서 우수할 수 있음을 밝혀, 향후 AI 서비스가 클라우드에서 개인용 하드웨어로 분산될 가능성과 그에 따른 최적화 방향을 제시하는 것이 이 논문의 핵심 목적입니다.
1. Overview (개요)
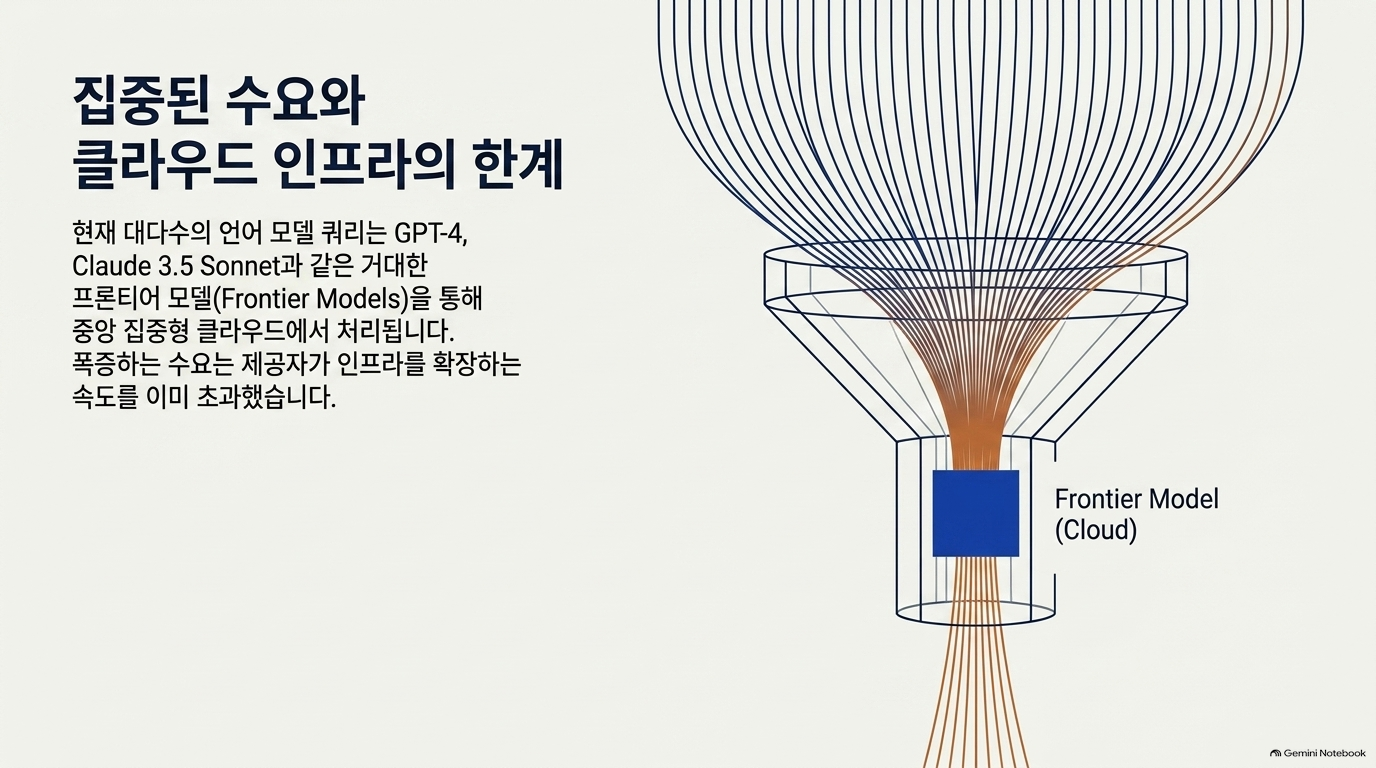
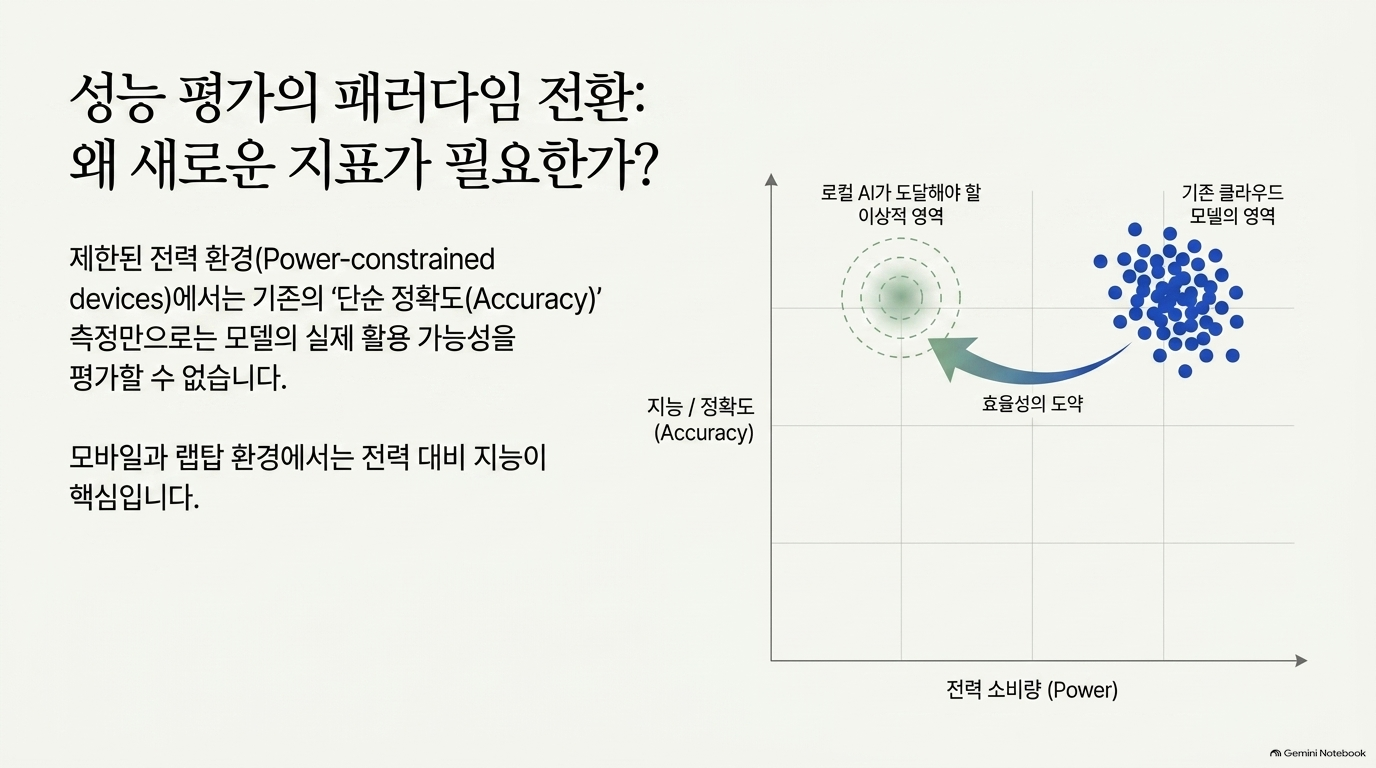
지금까지 LLM 질의는 대부분 중앙집중식 클라우드의 프론티어 모델이 처리해왔지만, 수요가 폭증하며 이 방식이 한계에 부딪히고 있습니다. 저자들은 역사적 유비를 제시합니다 — 1946~2009년 컴퓨팅 효율(성능/와트)이 1.5년마다 2배씩 개선되며 워크로드가 메인프레임에서 개인용 컴퓨터로 이동했는데, 이는 PC가 메인프레임보다 "더 강력해서"가 아니라 개인 기기의 전력 제약 안에서 "충분히 쓸 만해져서" 일어난 전환이었다는 것입니다. 저자들은 LLM 추론에서도 비슷한 전환점이 다가오고 있다고 주장합니다.
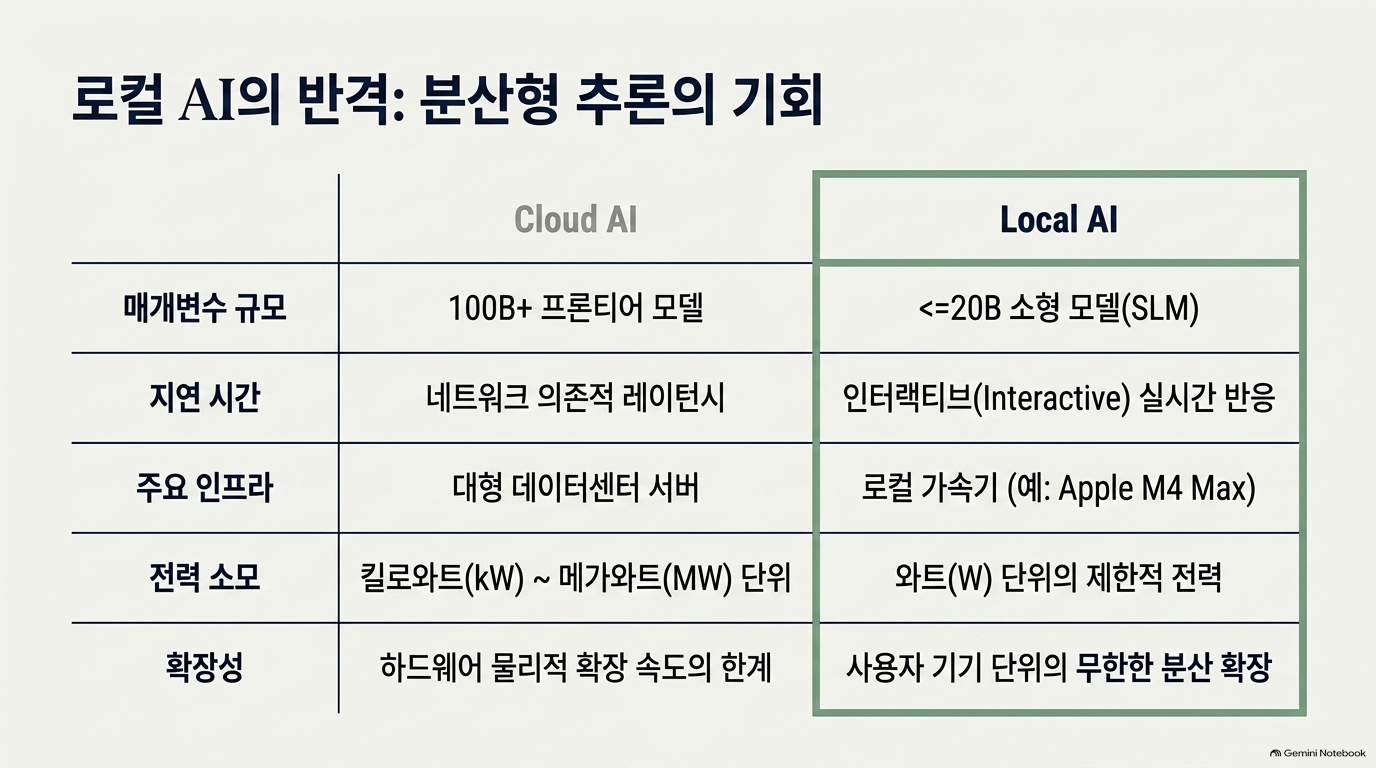
세 가지 수렴하는 흐름: (1) 20B 이하 활성 파라미터의 로컬 소형 모델(Qwen3, Llama3.1, GPT-OSS 등)이 프론티어 모델에 필적하는 성능을 더 적은 에너지·연산으로 달성, (2) Apple M4 Max 같은 로컬 가속기가 이런 모델을 대화형 지연시간으로 구동할 만큼 메모리·연산력을 갖춤, (3) 온디바이스 실행을 지향하는 오픈소스 개인용 AI 에이전트 생태계(OpenClaw, Hermes Agent, OpenJarvis 등)가 확산.
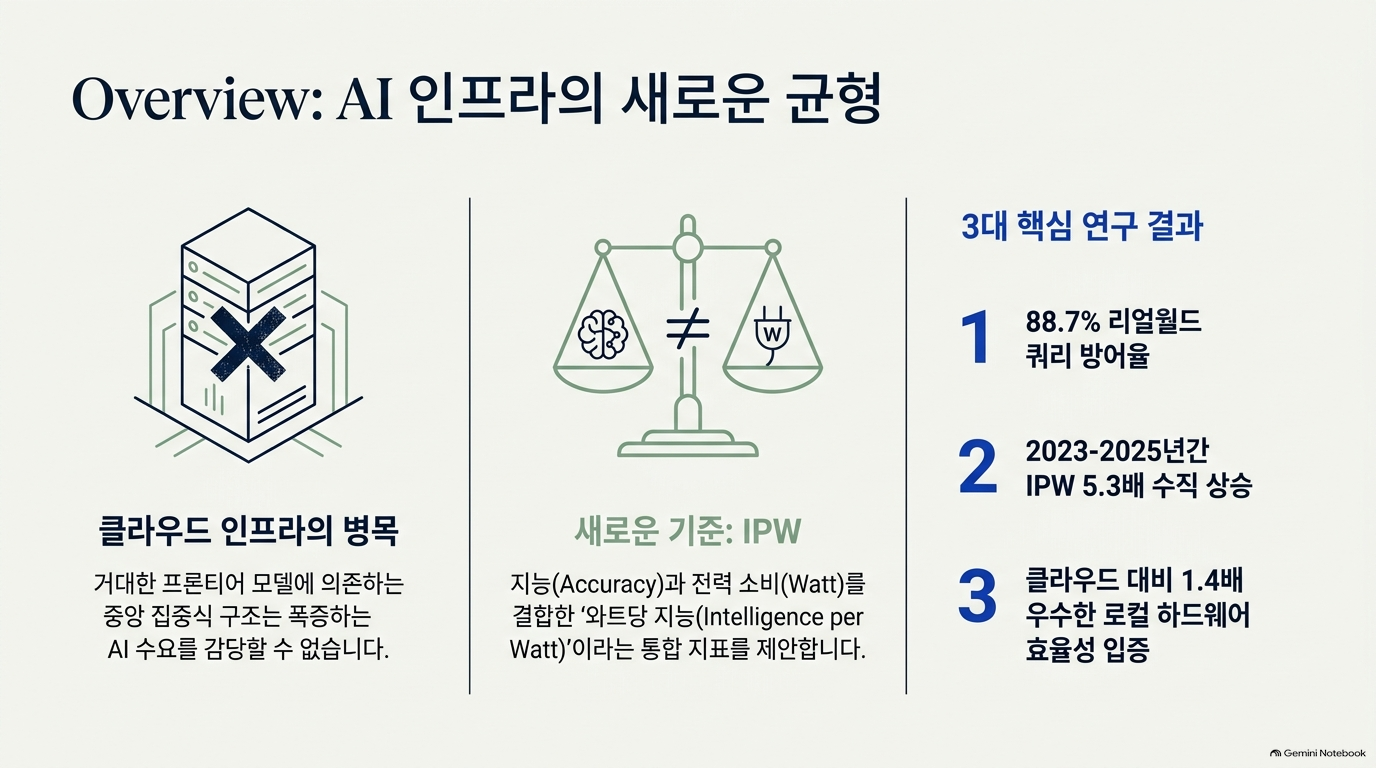
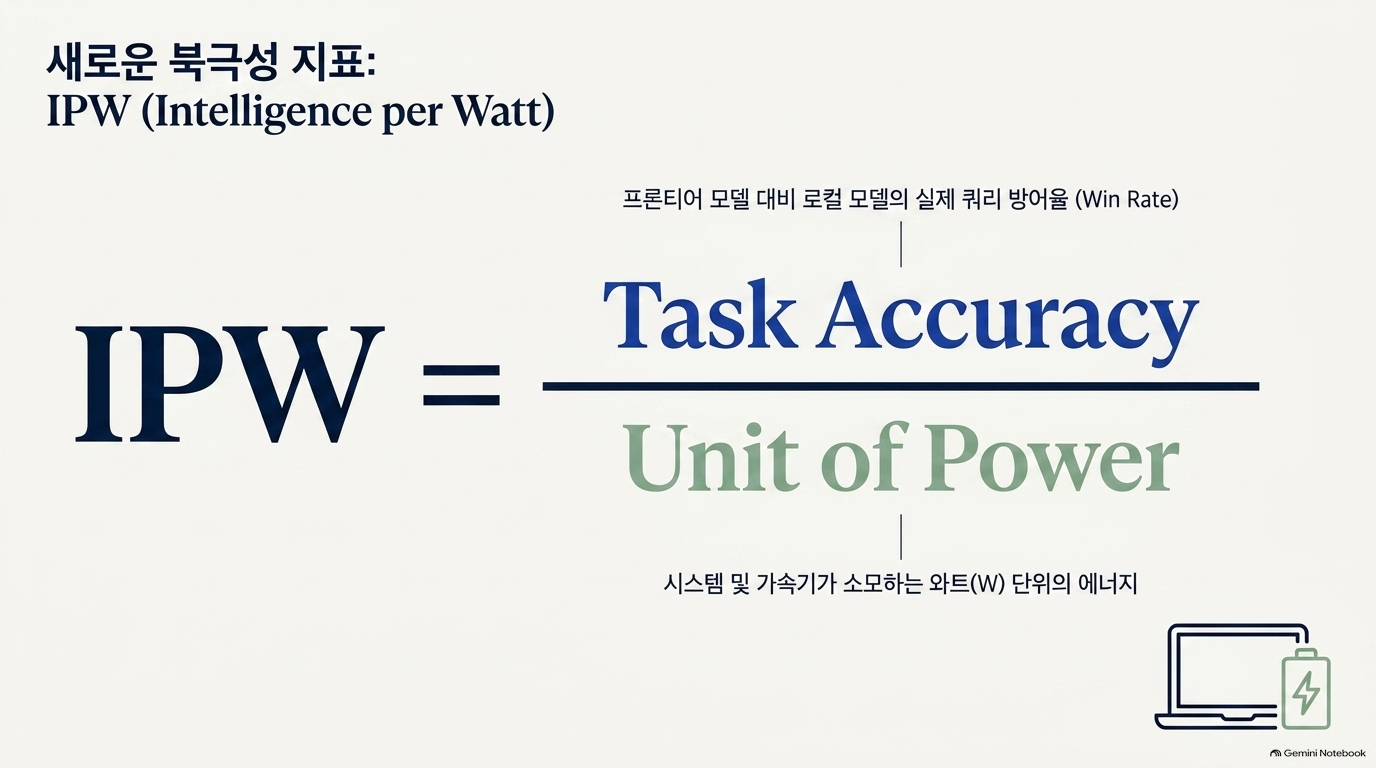
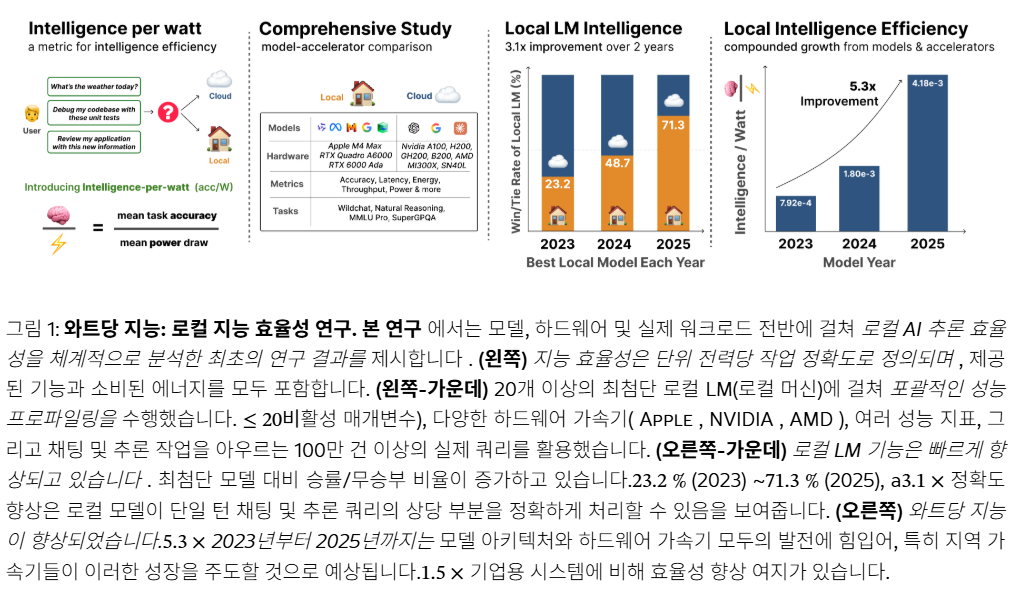
핵심 지표 제안: Intelligence per Watt(IPW) = 작업 정확도 ÷ 전력 소비량 — 로컬 추론의 역량과 효율을 동시에 포착하는 통합 지표.
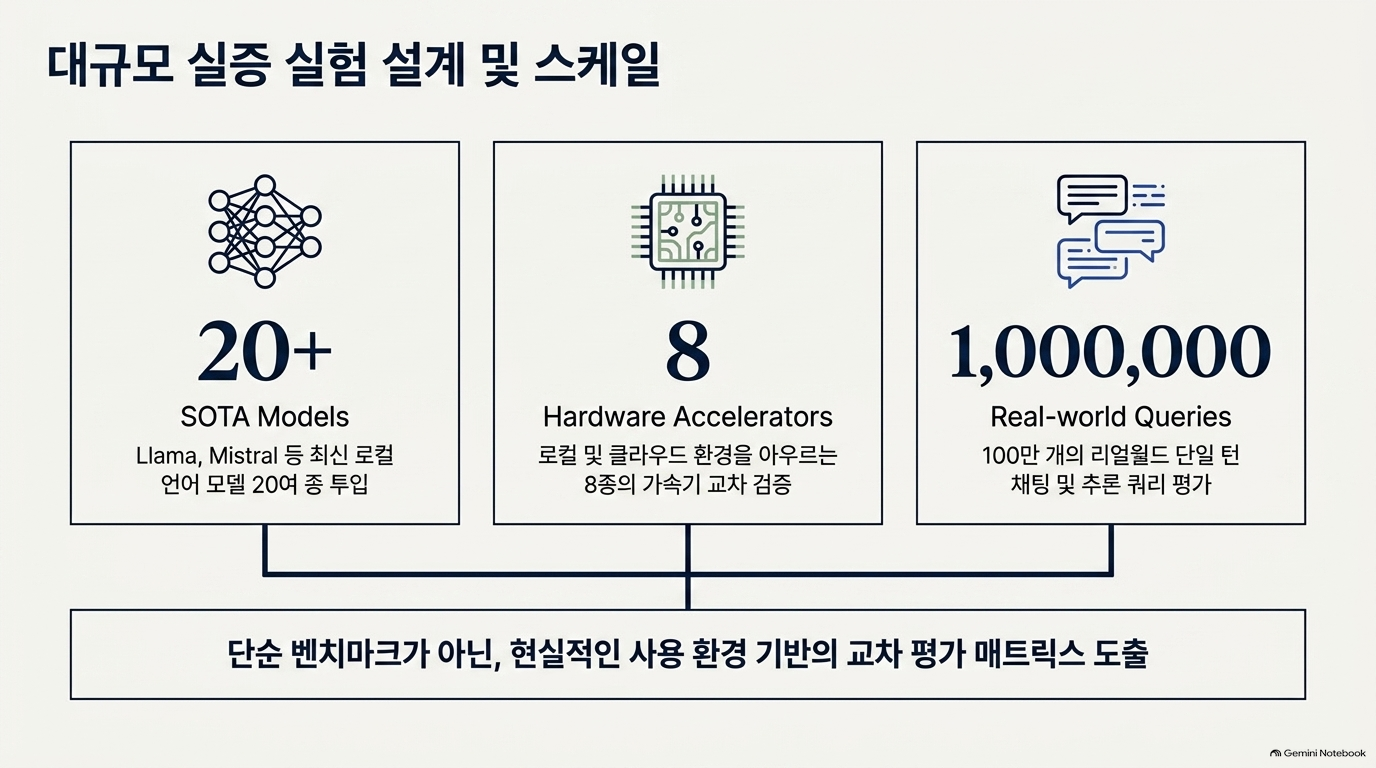
대규모 실증 연구: 20개 이상의 최신 로컬 LM × 8개 하드웨어 가속기 × 실제 사용자 질의 100만 건(단일턴 채팅·추론)을 대상으로 정확도·에너지·지연·전력을 측정.
3대 핵심 발견:
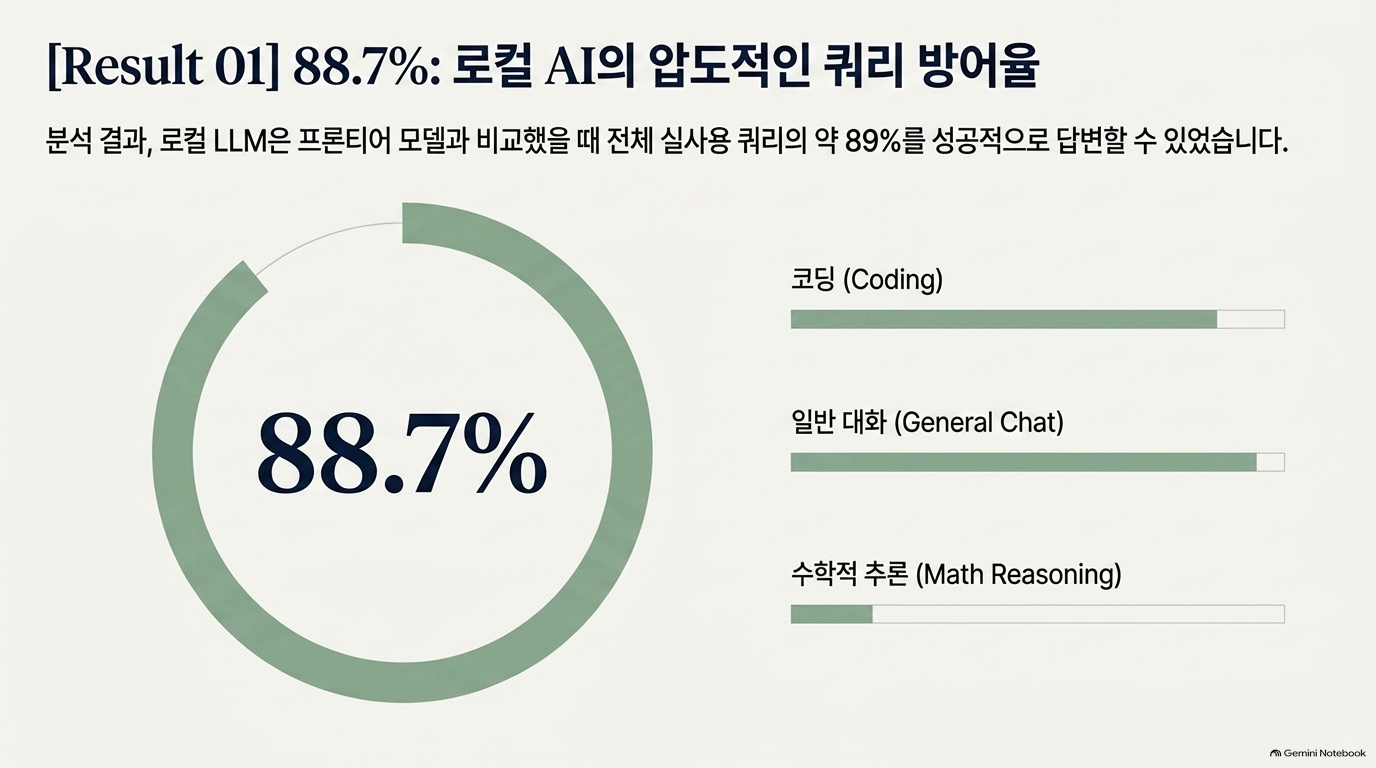
- 로컬 LM이 단일턴 채팅·추론 질의의 **88.7%**를 성공적으로 처리 가능(도메인별 편차 존재).
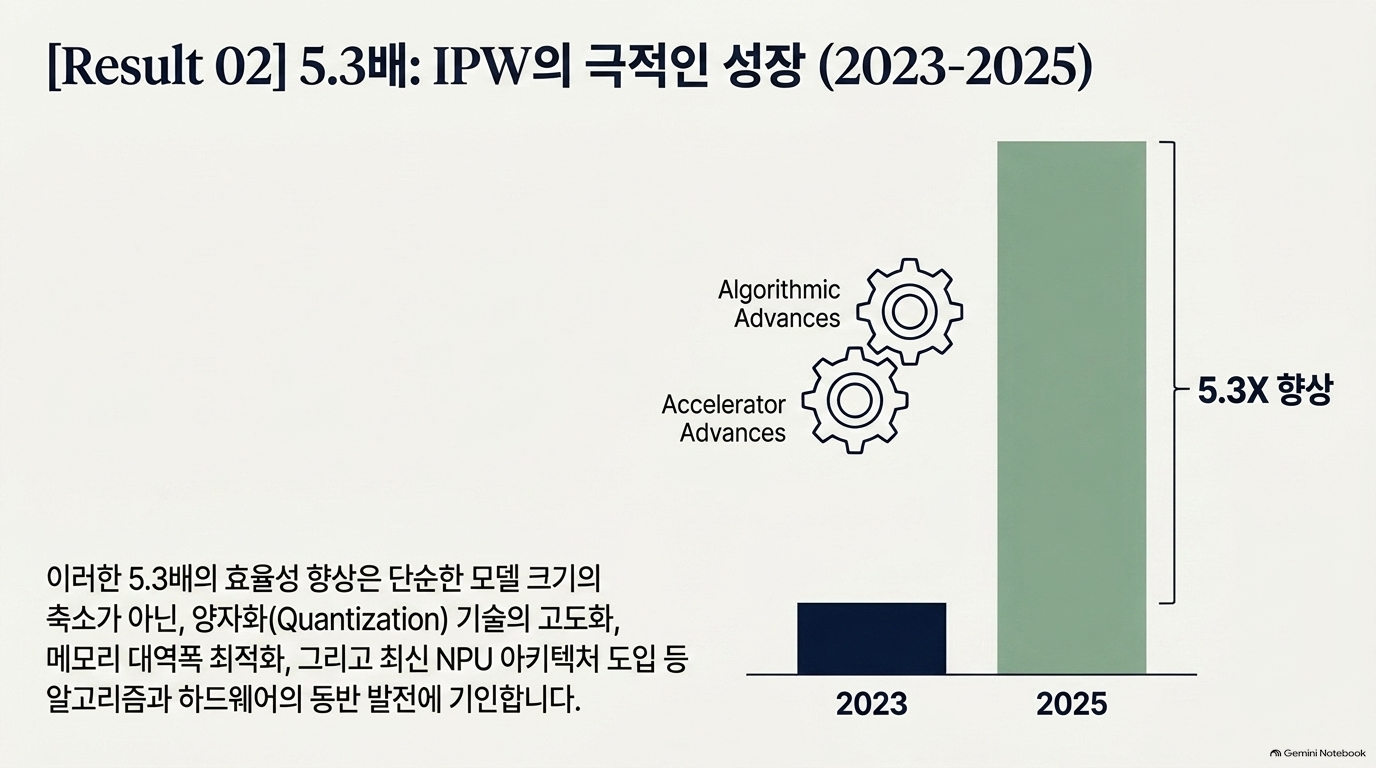
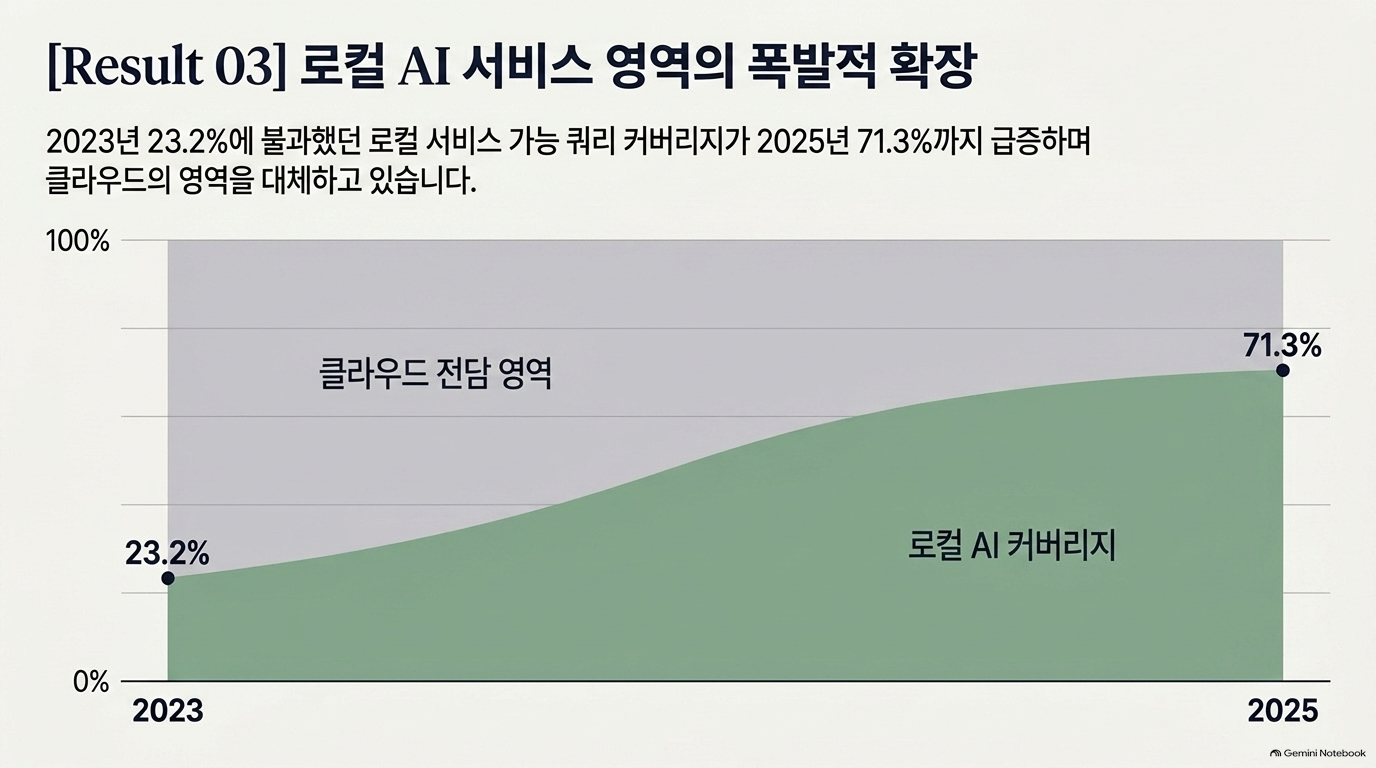
- 2023~2025년 종단 분석: IPW가 5.3배 개선(알고리즘 발전 + 가속기 발전 동시 기여), 로컬 처리 가능 비율은 23.2%→71.3%로 증가.
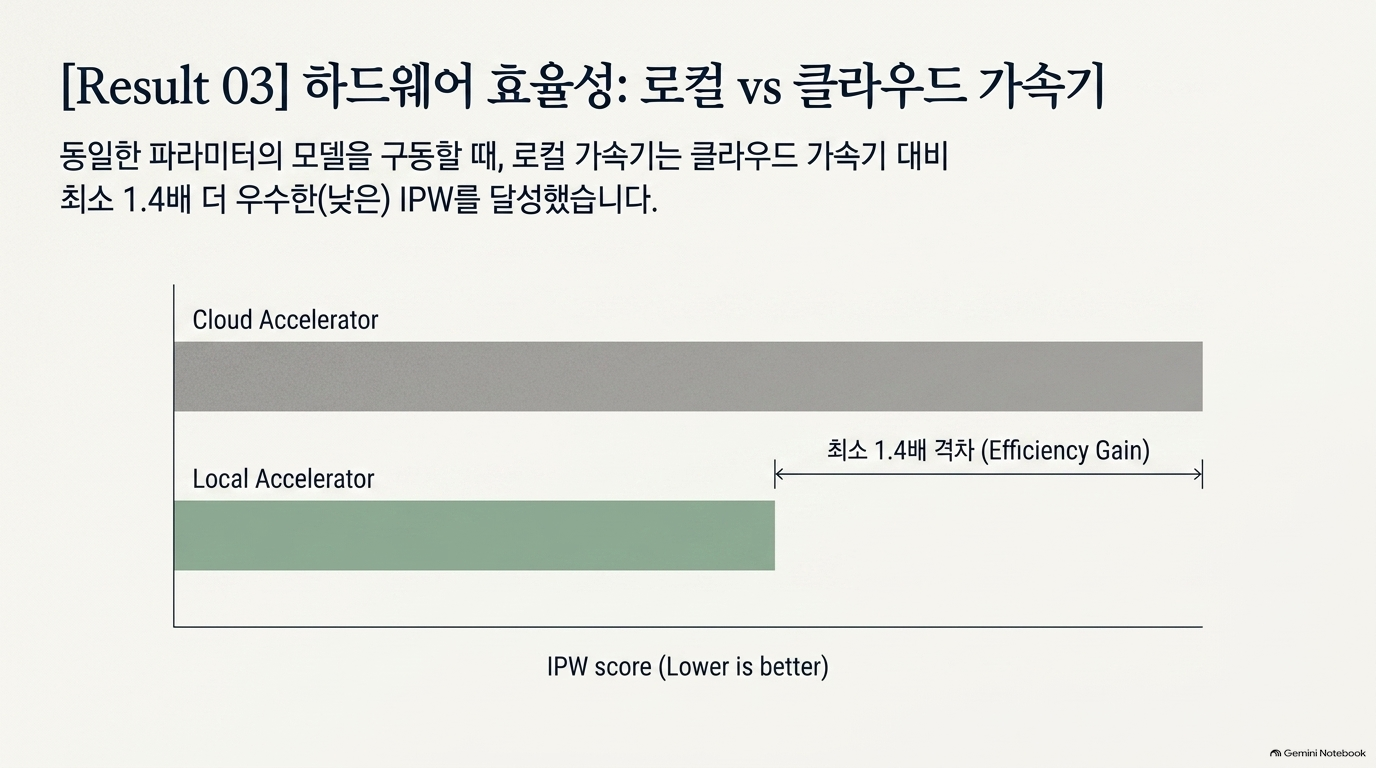
- 동일 모델 기준 로컬 가속기는 클라우드 가속기 대비 최소 1.4배 낮은 IPW — 로컬 가속기 최적화 여지가 상당함.
연구 질문 3가지: Q1) 현재 워크로드 중 로컬로 처리 가능한 비율과 시간에 따른 변화는? Q2) 모델·가속기 세대에 걸쳐 IPW가 어떻게 개선되었고 각각의 기여도는? Q3) 로컬·클라우드 간 라우팅으로 얼마나 자원을 절약할 수 있는가?
3대 기여: (1) IPW를 통합 지표로 제안하고 2023~2025년에 걸친 첫 대규모 종단 연구 수행, (2) 88.7% 커버리지 입증 + IPW 5.3배 개선(모델 3.1배 × 하드웨어 1.7배)을 정량화, (3) 하이브리드 로컬-클라우드 라우팅이 배치된 클라우드 베이스라인 대비 에너지·연산·비용을 60~80% 절감함을 입증(80% 정확도의 현실적 라우터도 오라클 이득의 약 80%를 포착).
2. Background (2장 Preliminaries + 부록 A 관련 연구)
추론 인프라 정식화
- 질의 스트림 Q, 로컬 모델 M_local(활성 파라미터 ≤20B), 클라우드 모델 M_cloud(≥100B), 로컬 가속기 H_local, 클라우드 가속기 H_cloud로 정의.
- "활성" 파라미터 기준을 쓰는 이유: 질의당 추론 효율은 순전파당 실제로 사용되는 파라미터 수에 좌우되기 때문(총 파라미터는 저장 용량이라는 별개의 제약을 규정).
- 라우팅 함수 r: Q → M_local ∪ M_cloud.
4가지 효율 지표 정의
- 전력 기반: Accuracy per Watt(APW) = E[정확도]/E[전력]; Perplexity per Watt(PPW)
- 에너지 기반: Accuracy per Joule(APJ) = E[정확도]/E[전력×지연시간]; Perplexity per Joule(PPJ)
- 전력 기반 지표는 순간적 효율(하드웨어가 주어진 전력에서 내는 성능)을, 에너지 기반 지표는 지연시간까지 포함한 질의당 종단간 효율을 포착. 두 관점 모두 논문 전체에서 함께 보고되며, 정성적 경향은 일관되지만 절대적 개선폭은 다를 수 있음(하드웨어 발전이 전력과 지연시간을 동시에 줄이기 때문에 조율당 이득이 와트당 이득보다 큼).
- 정확도는 이진 지표로 정의: 정답이 있는 벤치마크(MMLU Pro, SuperGPQA, NaturalReasoning)는 정확 일치, 개방형 채팅(WildChat)은 LLM 심사자가 로컬 모델의 승리 또는 동점 판정을 내린 경우로 정의.
관련 연구(부록 A): LLM 라우팅 분야는 임베딩 기반 라우터(RouteLLM 등, 초기엔 2-모델 이진 라우팅)와 생성/디코더 기반 라우터로 나뉘며, FrugalGPT·RouterDC·Avengers Pro 등은 여러 소형 모델을 조합해 대형 모델에 필적하는 성능을 보여줌. 기존 라우팅 벤치마크(RouterBench, RouteLLM, RouterEval)는 학술 벤치마크나 오래된 모델(2024년 7월 이전)에 국한된 반면, 이 논문은 2025년 5월 이후 출시된 최신 모델과 실제 사용자 질의 100만 건, 그리고 비용뿐 아니라 지연·에너지·메모리까지 포괄한다는 점에서 차별화됩니다. 로컬-클라우드 협업 추론(Minions, 추측 디코딩, SLED, HAT)은 토큰/레이어 단위의 세밀한 협업을 다루는 반면, 이 논문은 더 거친 단위인 "질의 단위 라우팅"에 집중. Green AI/효율적 AI 문헌 중 가장 밀접한 선행연구(Fernandez et al.)는 클라우드 GPU에서 고정된 형식의 과제만 다뤘던 반면, 이 논문은 로컬 가속기 + 자연스러운 실사용 질의 분포 + 종단적 분해 + 하이브리드 라우팅까지 포괄한다는 점에서 상보적.
3. Methods (3장 데이터셋과 프로파일링 하네스)
데이터셋 구성 (3.1) — 총 100만+ 질의를 4개 벤치마크에서 큐레이션:
- WildChat(자연스러운 채팅, 실제 ChatGPT 프롬프트 100만 건 중 1개월치 트래픽) → 50만 건 샘플링
- NaturalReasoning(일반 추론, 수학·물리·화학 등 약 120만 건) → 50만 건
- MMLU Pro(표준화된 지식평가, 10지선다) → 1.2만 건
- SuperGPQA(대학원 수준 전문 추론, 285개 학문분야) → 2.65만 건
- 데이터 정제 후, GPT-4o-mini로 각 질의에 Anthropic Economic Index의 22개 직업 범주(미 노동부 O*NET 매핑) 라벨 부여.
하드웨어 가속기: NVIDIA A100·H200·GH200·B200·Quadro RTX 6000·RTX 6000 Ada, AMD MI300X, Apple M4 Max, SambaNova SN40L(부록에서는 스마트폰급 Apple A18 Pro도 추가 평가) — 메모리 40GB~768GB, 대역폭 546GB/s~8TB/s, 전력 145W~1000W로 다양하게 구성.
모델: Qwen3(4B/8B/14B/32B/235B), GPT-OSS(20B/120B), Gemma3(1B/4B/12B Instruct), IBM Granite 4.0(H-Micro/H-Tiny/H-Small). 클라우드 비교 대상: Claude Sonnet 4.5, Gemini 2.5 Pro, GPT-5(2025-08-07). 종단 분석용 구세대 모델: Mixtral-8x7B(2023), Llama-3.1-8B(2024).
평가 방식: WildChat은 Qwen3-235B(2025년 8월 기준 LMArena 최고 오픈소스 모델)의 응답을 기준으로 LLM 심사, 나머지 3개 벤치마크는 정답 데이터 사용.
프로파일링 하네스 (3.2): NVIDIA·macOS(Apple Silicon)·AMD를 아우르는 자체 개발 크로스플랫폼 하네스(분산 다중 GPU 추론, 응답 평가, 시스템 레벨 텔레메트리 3요소). 에너지는 NVML(NVIDIA)/ROCm SMI(AMD)/powermetrics(macOS, GPU 서브시스템만 분리 측정)로 수집, 50ms 간격으로 샘플링(기존 연구의 100ms/15s보다 세밀). CodeCarbon 대신 자체 하네스를 쓴 이유: CodeCarbon의 기본 15초 샘플링이 짧은 생성 작업의 질의별 귀속에 너무 성겨서, 그리고 AMD·Apple Silicon 지원이 없어서. 소프트웨어 기반 전력 측정은 10~15%의 오차를 유발할 수 있음을 명시.
4. Experiments (4장 Intelligence Efficiency Study)
4.1 (Q1) 로컬 모델·가속기가 현재 워크로드를 처리할 수 있는가?
- 개별 모델 커버리지는 규모·시간에 비례: Qwen3-4B 49.6% → Qwen3-8B 57.5% → Qwen3-14B 60.0% → GPT-OSS-120B 71.4%(2025년 최고 개별 모델).
- 2023→2025년 개선폭: 채팅 질의 상대적으로 +32.2%, 추론 질의 +50.1%.
- 모델 다양성이 커버리지를 크게 높임: 20개 이상 모델 중 질의별 최적 모델로 라우팅하는 "best-of-local"은 전체 88.7% 커버리지 달성 — 이는 하나의 최고 모델(Qwen3-14B)보다 28.8%p, GPT-OSS-120B 개별 성능보다 16.3%p 높음. 추론 벤치마크에서는 best-of-local이 best-of-cloud(프론티어 3개 모델 중 최선)조차 능가하는데, 이는 20여 개의 다양한 로컬 모델 풀에서 고르는 best-of-N 선택 효과 때문이라고 저자들은 설명합니다.
- 채팅이 추론보다 로컬 처리에 유리: 최고 로컬 모델이 WildChat에서 88.9% vs NaturalReasoning에서 64.9% (24.0%p 격차) — 실제 ChatGPT 질의의 77%가 실용적 조언·정보 탐색·글쓰기라는 선행 연구와 부합.
- MMLU Pro·SuperGPQA에서도 best-of-local이 각각 93.4%·83.6% 커버리지(개별 최고 모델은 80.4%·51.5%)를 달성하지만, 창작/인문 분야는 93% 이상인 반면 건축·공학 같은 기술 분야는 60%까지 떨어짐.
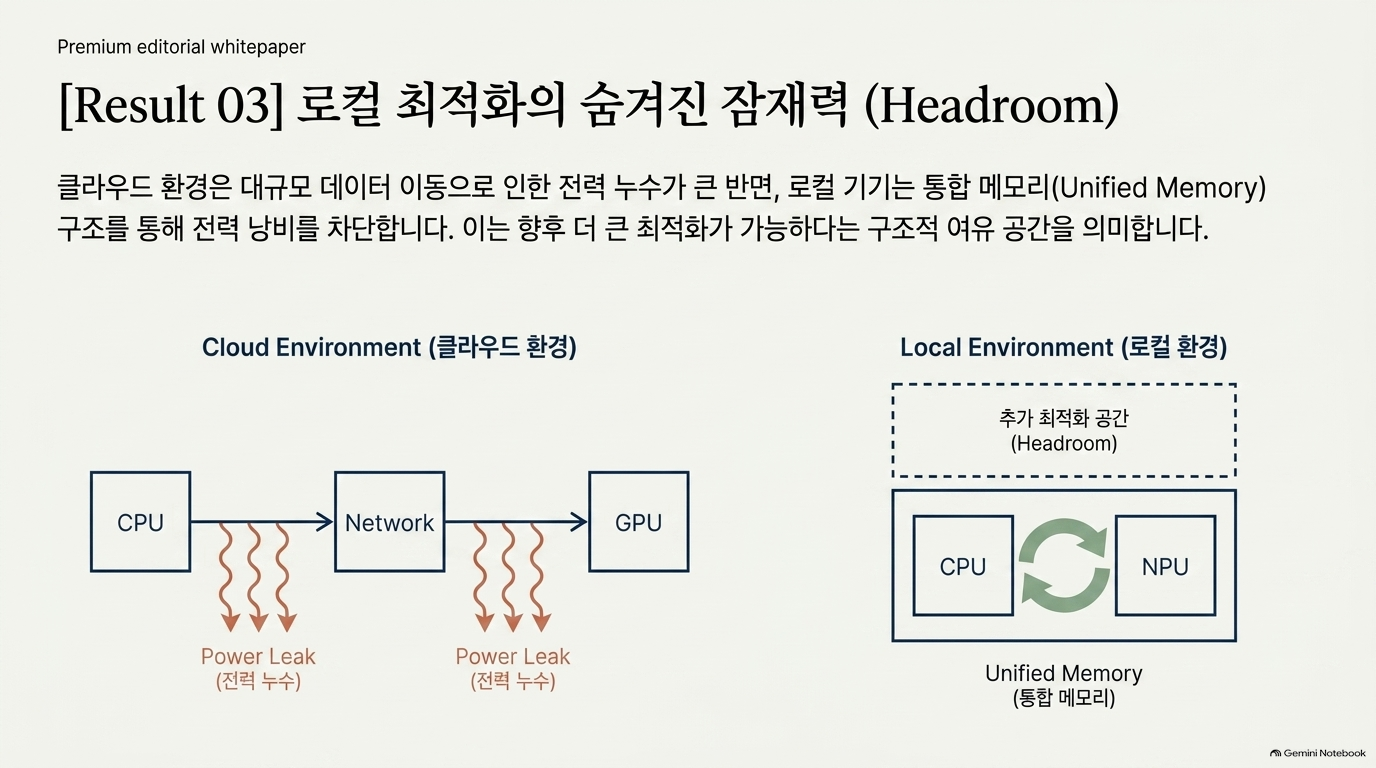
- 로컬 가속기 메모리 용량은 2012~2025년 사이 약 126배 증가 — 20GB 미만에서 200GB 이상으로의 도약(Apple Silicon 통합 메모리 등)이 클라우드로 밀려났던 워크로드를 로컬로 되돌리는 핵심 동인이라고 설명.
4.2 (Q2) 로컬 추론은 얼마나 지능효율적인가?
표 2 — 연도별 IPW 진화
| 연도 | 최고 로컬 모델 | 최고 가속기 | 성공률 | IPW | 전년비 개선 |
| 2023 | Mixtral-8x7B | NVIDIA Quadro RTX 6000 | 23.2±1.9% | 7.92×10⁻⁴ | — |
| 2024 | Llama-3.1-8B-Instruct | NVIDIA RTX 6000 Ada | 48.7±2.7% | 1.80×10⁻³ | 2.27× |
| 2025 | GPT-OSS-120B | Apple M4 Max | 71.3±2.2% | 4.18×10⁻³ | 2.32× |
- 2년간 IPW 5.3배 개선. 지표에 따라 분해 결과가 다름: 와트당 정확도 기준으로는 모델 기여 3.1배 × 하드웨어 기여 1.7배; 줄(joule)당 정확도 기준으로는 모델 3.1배 × 하드웨어 5.9배(총 18.0배) — 최신 가속기가 전력뿐 아니라 지연시간까지 줄이기 때문에 하드웨어 기여가 줄 단위에서 더 크게 나타남. 이 패턴은 9개 모델 계열(Llama, Phi, Gemma, Mistral, Falcon, DeepSeek, Qwen, GPT-OSS)에서 일관되게 확인.
- FP4 양자화는 정밀도 단계마다 3~3.5배 에너지 절감, 클라우드 배치 크기 64는 배치 1 대비 11~20배 높은 IPJ, vLLM/SGLang/llama.cpp 등 서빙 프레임워크 간 IPW 순위는 유지.
- 로컬 가속기는 아직 개선 여지가 큼: 동일 모델 기준 NVIDIA B200이 Apple M4 Max보다 IPW 1.40배, IPJ 1.6~2.3배 높고, SambaNova SN40L은 IPW 최대 1.78배, IPJ 6.5~7.4배 높음 — HBM3e·전용 텐서 유닛 등 클라우드 가속기의 목적특화 설계 대 로컬 가속기의 범용 통합메모리 설계 차이에서 기인.
4.3 (Q3) 효과적인 질의 라우팅으로 얻는 효율 이득은?
- 24시간·8,020만 건 질의 시뮬레이션: 4개 소형 로컬 모델(Qwen3-4B/8B/14B, GPT-OSS-20B, Apple M4 Max, bs=1)과 프론티어 모델(Qwen3-235B, NVIDIA H200, bs=16 실제 서빙 조건 반영) 간 라우팅.
- 오라클 라우팅(완벽한 질의-모델 배정): 클라우드 전용 배치 대비 에너지 80.4%, 연산 77.3%, 비용 73.8% 절감. 질의의 80.7%가 훨씬 작은 로컬 모델로 정확히 처리되고, 나머지 19.3%만 프론티어 연산을 씀 — 지배적 효과는 하드웨어 효율 우위가 아니라 모델 크기 축소 자체.
- 현실적 라우터: 정확도 80%인 라우터(RouteLLM 등 선행연구가 실제 워크로드에서 70~85%를 보고한 현실적 목표)는 오라클 이득의 약 80%인 에너지 64.3%, 연산 61.8%, 비용 59.0% 절감을 달성. 60% 정확도 라우터도 48.4%/46.7%/44.5% 절감. 잘못 라우팅된 질의는 프론티어 모델로 폴백되어 답변 품질을 유지.
- 하루 수십억 건 규모에서는 이 절감이 연간 테라와트시(TWh) 단위로 확장됨. 효율적 AI 인프라의 핵심은 로컬 하드웨어가 클라우드 효율을 따라잡는 것이 아니라, 양쪽을 아우르는 라우팅에 있다는 결론.
부록 하이라이트 (E.1–E.12, 방대하므로 핵심만)
- 8가지 실무 원칙(E.1): 메모리가 넉넉한 로컬 기기에서는 MoE 구조가 최고 IPW를 냄; FP16→FP4 양자화는 단계당 정확도 손실 약 2.5%p로 에너지 3~3.5배 절감(정밀도보다 모델 크기를 먼저 키우고 공격적으로 양자화); 라우터 정확도는 80% 수준까지만 투자하고 그 이상은 로컬 모델 앙상블 다양성 확장이 더 중요; 로컬의 병목은 연산력(FLOPs)이 아니라 메모리 대역폭.
- 난이도별 분석(E.2): 가장 어려운 "레벨 5" 추론 문제(전체 추론 데이터셋의 16.5%)는 2025년에도 95%가 미해결 상태로 남아있어, 쉬운 문제의 빠른 개선과 대조적인 "정체된 최전선"을 보여줌.
- 오픈소스 vs 폐쇄형 모델(E.6): 최고 오픈소스 모델(Qwen3-235B)이 평균 정확도 71.8%로 최고 폐쇄형 모델(GPT-5, 77.9%)에 6.1%p 뒤처지며, 격차는 NaturalReasoning에서 가장 큼(12.9%p).
- GDP 연관 분석(E.7): 모델 정확도를 미 노동부 직업 범주와 GDP 기여도에 가중 평균하면, 채팅 과제는 미국 GDP의 69.6%에 해당하는 영역을 커버하지만 추론 과제는 23.3%만 커버 — 저자들은 이를 "실현된 경제적 영향의 예측이 아니라, 로컬 LM이 다룰 수 있는 범위의 상한 추정치"라고 스스로 경계하며 이상화된 지표임을 명시합니다.
- 스마트폰급 가속기(E.11): iPhone 16 Pro(A18 Pro, 약 12W)는 워크스테이션 GPU 대비 약 7배 높은 IPW를 보이지만, 지연시간이 9~26배 길어 줄(joule)당 효율 우위는 비교 대상에 따라 좁아지거나 역전됨.
- 멀티턴 에이전트 워크로드(E.12): GAIA·TerminalBenchV2에서도 단일턴에서 관찰된 패턴이 정성적으로 재현됨(클라우드가 줄당 2.4~3.0배, 로컬이 와트당 3.7~3.8배 효율적, 정확도 차이는 약 2.2%p에 불과) — 다만 245건의 소규모 평가라 "예비 점검" 수준이라고 저자들이 스스로 단서를 답니다.
5. Conclusion (5장 결론 + 부록 C·D)
로컬 추론이 중앙집중식 클라우드 인프라의 수요를 실질적으로 재분배할 수 있는지를 묻고, 이를 위해 **intelligence per watt(IPW)**를 통합 지표로 제안했습니다. 20개 이상 모델, 8개 가속기, 100만 건 질의(2023~2025년 종단)를 통해 첫걸음을 뗀 결과: 단일턴 채팅·추론 질의의 88.7%가 로컬로 처리 가능하고, IPW는 모델(3.1배)과 하드웨어(1.7배) 발전이 복합되어 2년간 5.3배 개선되었으며, 클라우드 가속기가 질의당 1.4~7.4배의 효율 우위를 유지함에도 하이브리드 라우팅이 현실적인 라우팅 정확도에서 에너지·연산·비용을 60~80% 절감할 수 있음을 확인했습니다.
3대 실무 시사점: MoE 구조가 메모리가 넉넉한 로컬 기기에서 최고 IPW를 냄; 공격적인 FP4 양자화가 정밀도는 높지만 작은 모델보다 나음; 라우터 정확도는 ~80%를 넘어서면 그보다 로컬 모델 앙상블 확장이 더 중요.
한계(7가지): (1) 소프트웨어 텔레메트리 기반 측정의 10~15% 오차 가능성, (2) 단일턴 중심 분석(멀티턴 확장은 부록에서 정성적으로만 검증), (3) LLM 심사자에 내재된 편향, (4) 8개 가속기로는 로컬 하드웨어 전체를 대표 못함, (5) 클라우드 비교에 bs=1을 써서 클라우드에 보수적, (6) vLLM으로 단일화(다른 프레임워크에서도 순위는 유지됨을 별도 확인), (7) 2025년 10월 시점 스냅샷이라 DRAM/HBM 가격 변동이 로컬 배포 가능성의 향후 속도에 영향 줄 수 있음.
폭넓은 영향과 위험: 로컬 추론 확대는 에너지·인프라 비용·접근성(클라우드 연결이 불안정하거나 비싸거나 프라이버시가 중요한 상황)에 이점이 있지만, 저자들은 세 가지 잠재적 부정 영향도 명시합니다 — ① 로컬 배포된 유능한 모델은 클라우드처럼 사용정책을 적용하기 어려워 오남용 모니터링이 힘들어질 수 있음, ② 로컬 추론은 에너지 소비를 "없애는" 것이 아니라 가정용 전력망으로 "재배치"하는 것이며, 상시 구동되는 로컬 에이전트가 확산되면 질의당 효율 개선에도 불구하고 총 에너지 소비가 오히려 늘어나는 제번스 역설(Jevons paradox) 우려가 있으나 이를 정량화하지는 않았다고 명시, ③ 비용·에너지 비교치가 근사값이라 특정 조달·정책 결정에 그대로 인용되면 오용될 수 있음.
[보완 내용] 외부 확인 사항
- 이 논문은 2025년 11월 최초 게재 이후 v5(2026년 8월)까지 5차례 개정되며 꾸준히 업데이트되었고, Hugging Face Daily Papers·alphaXiv·ResearchGate·반도체 전문매체(Semiconductor Engineering) 등에서 폭넓게 다뤄진, 학계에서 어느 정도 자리 잡은 연구로 확인됩니다. GitHub 저장소(HazyResearch/intelligence-per-watt)도 공개되어 있습니다.
- Hugging Face 논문 페이지에는 모델 기여도가 "3.2배"로 표기된 버전이 있었으나(초기 버전 기준으로 추정), 이번에 제공하신 v5 본문에는 일관되게 3.1배로 명시되어 있어 원문 기준으로 3.1배를 사용했습니다. [수치 확인 필요: 버전 간 근소한 수치 차이가 있을 수 있음]