07.AI/4.AI 비용
추론 서빙(Serving) 최적화 - AI 첫 응답 속도(TTFT) 최적화
Mr. Slumber
2026. 8. 28. 17:43
반응형
2026.8.18
[The GPU Is Not Your Time-to-First-Token Bottleneck]
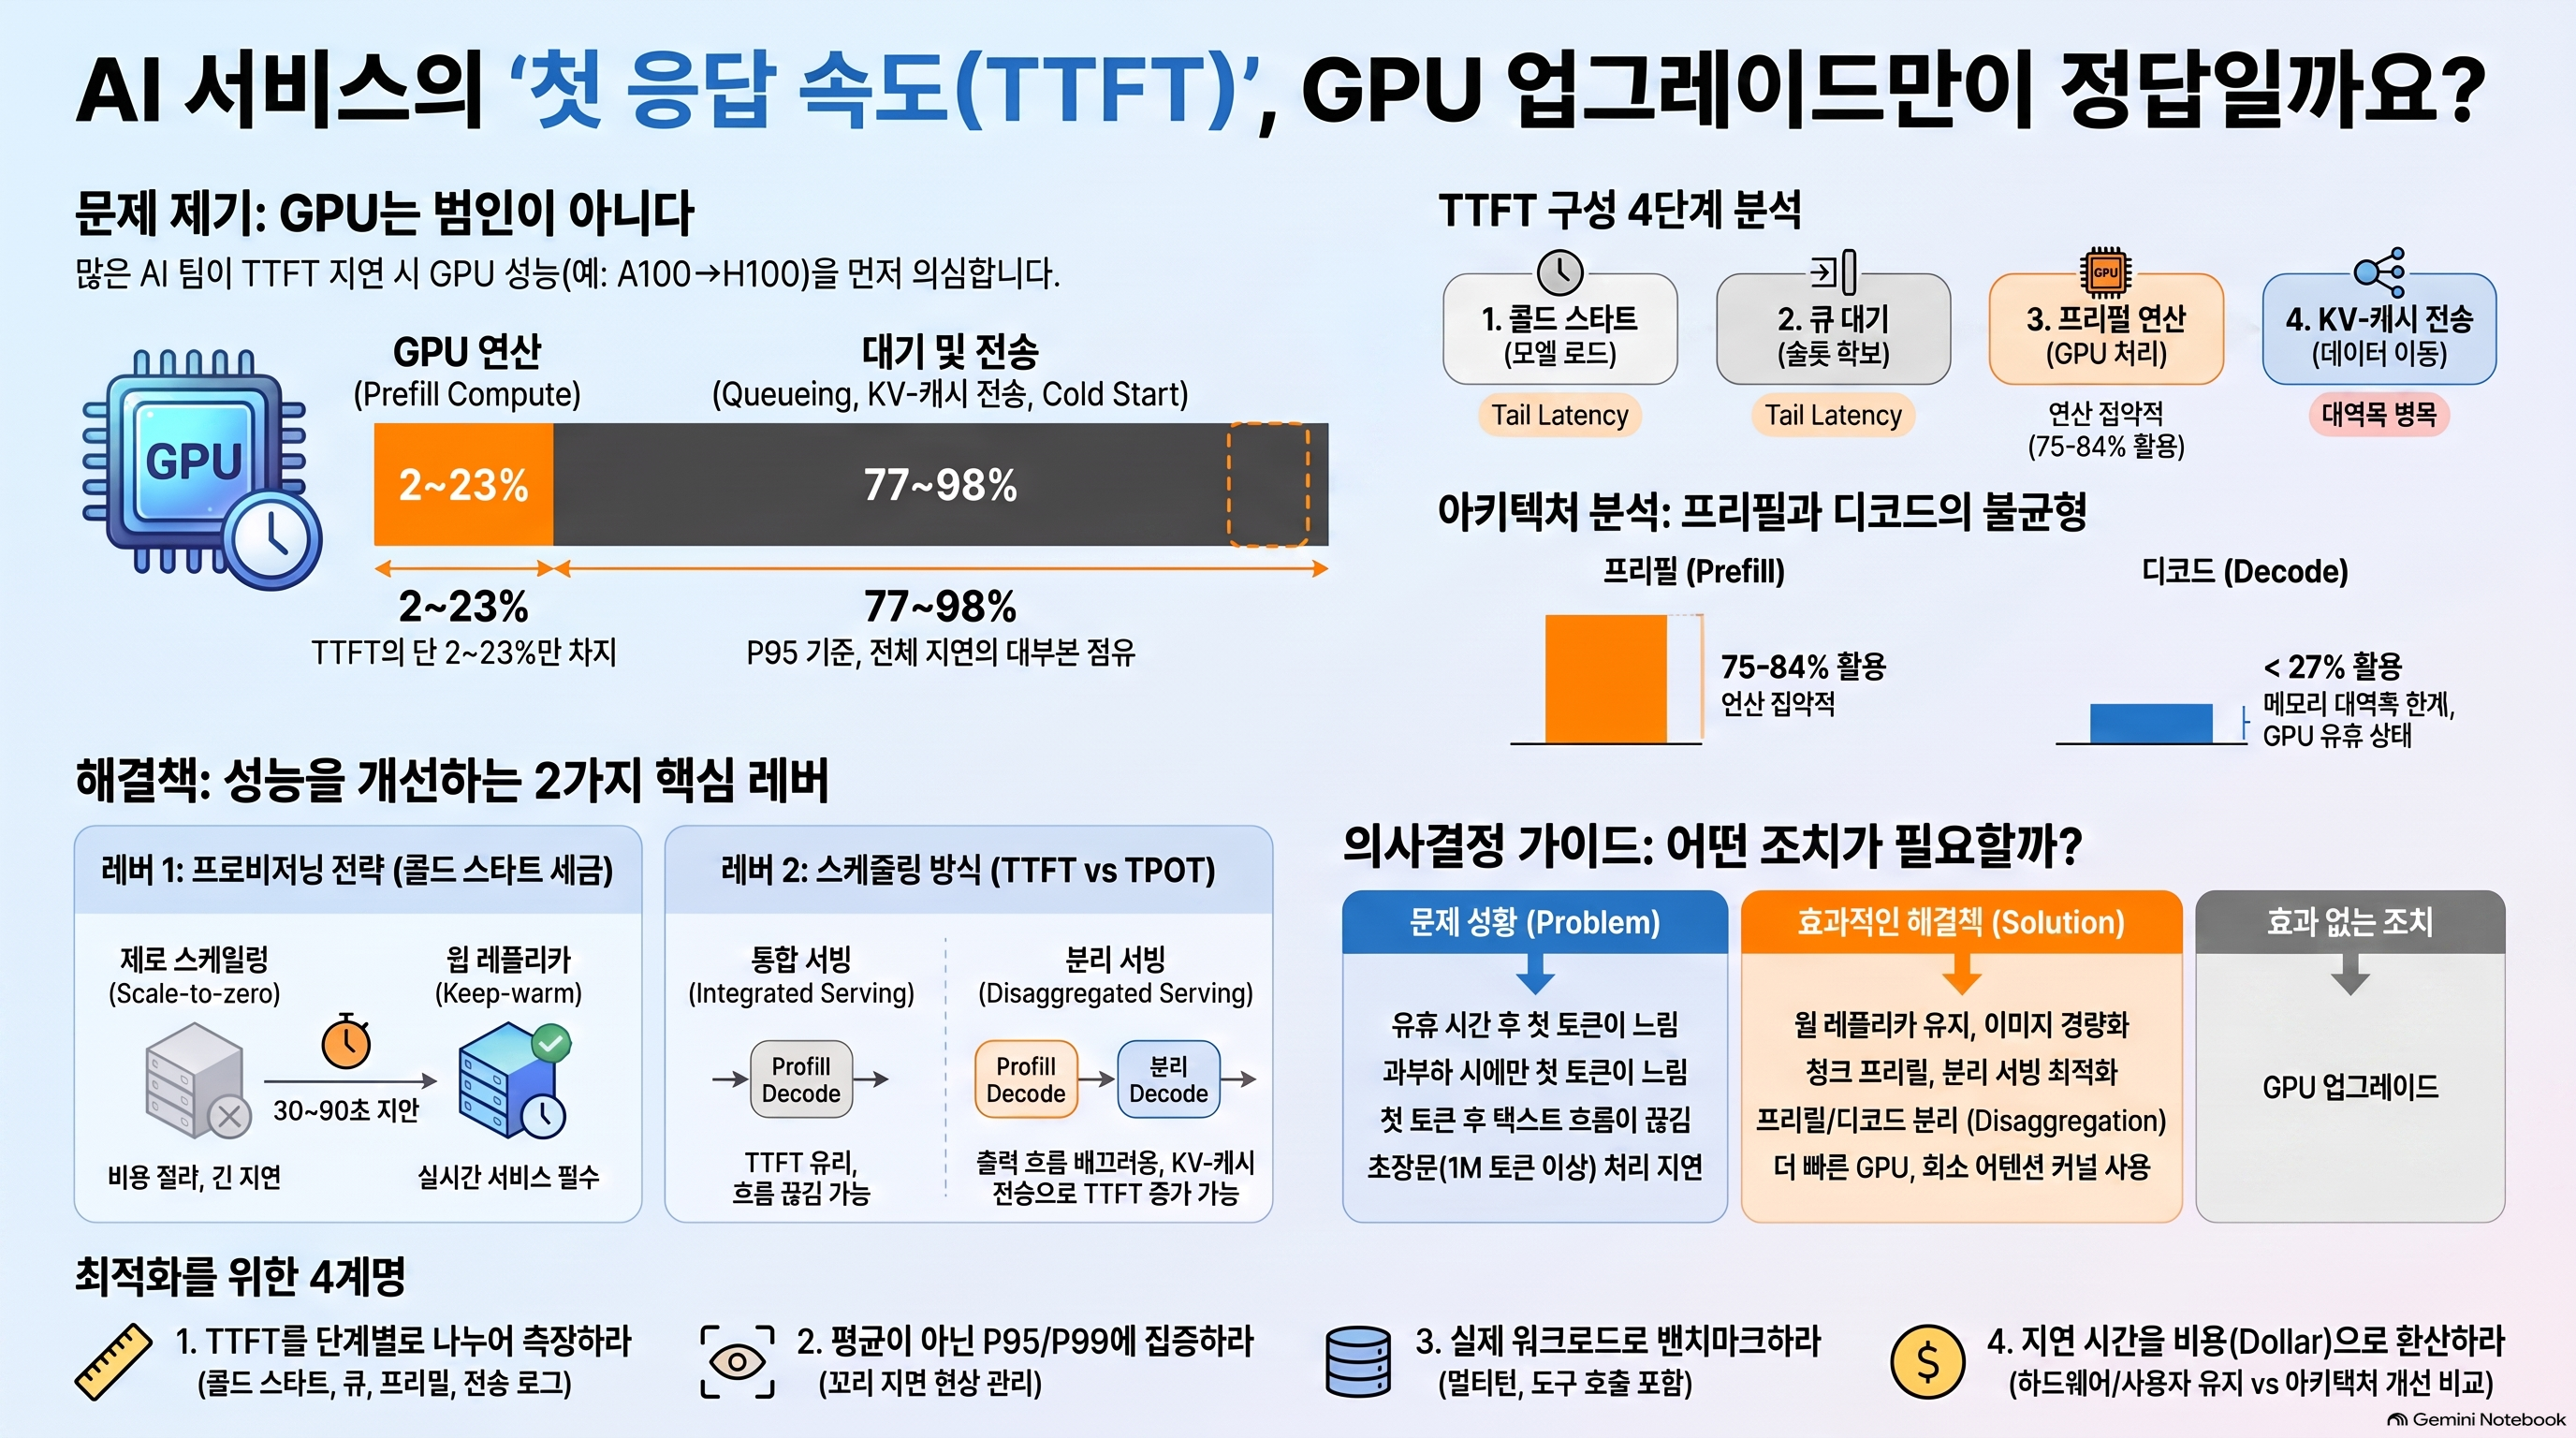
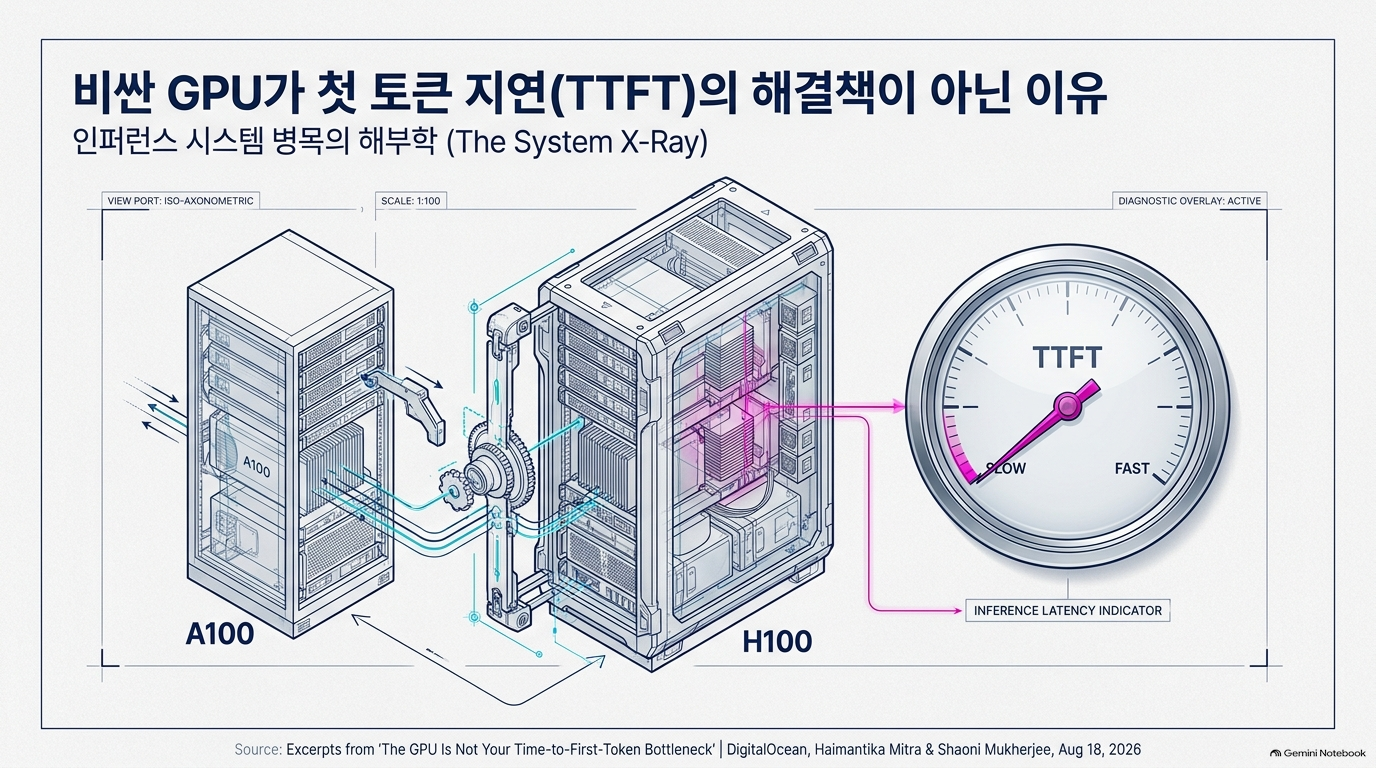
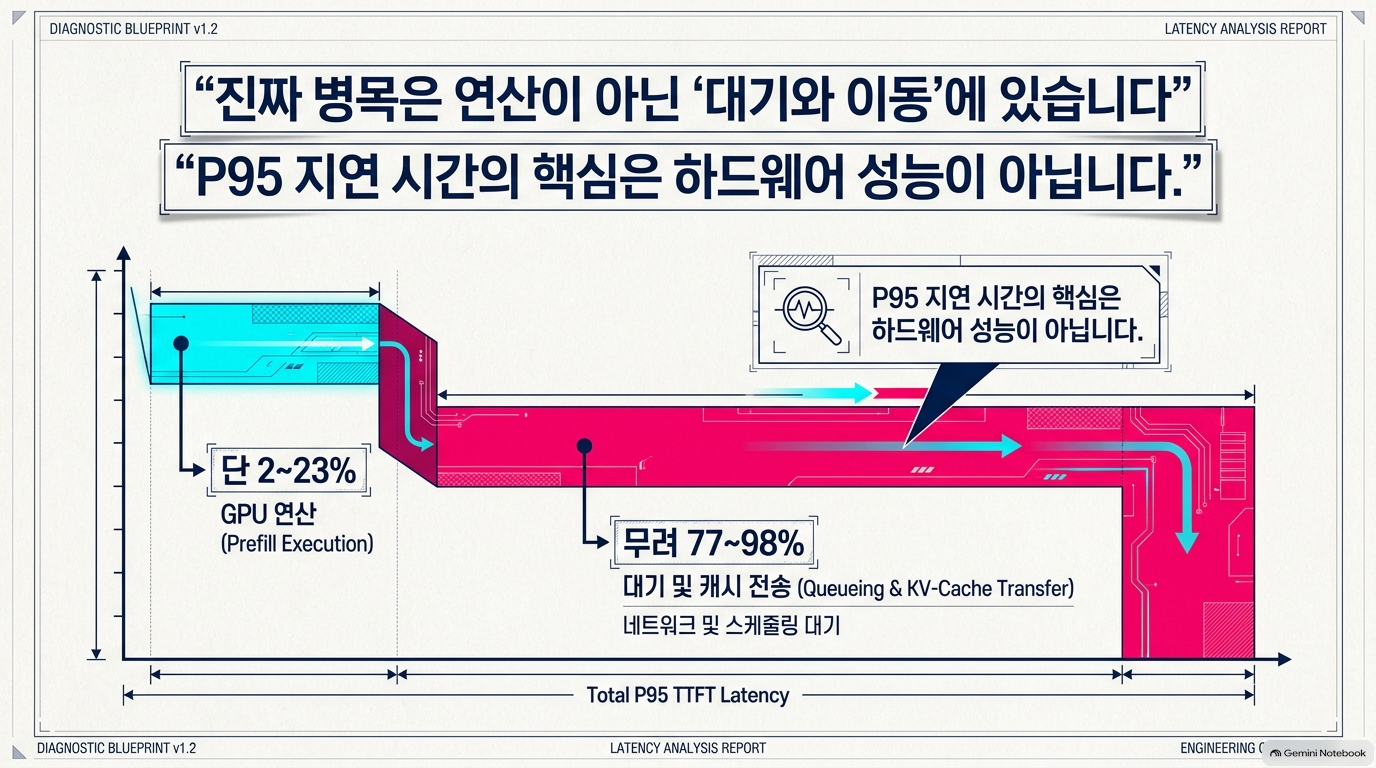
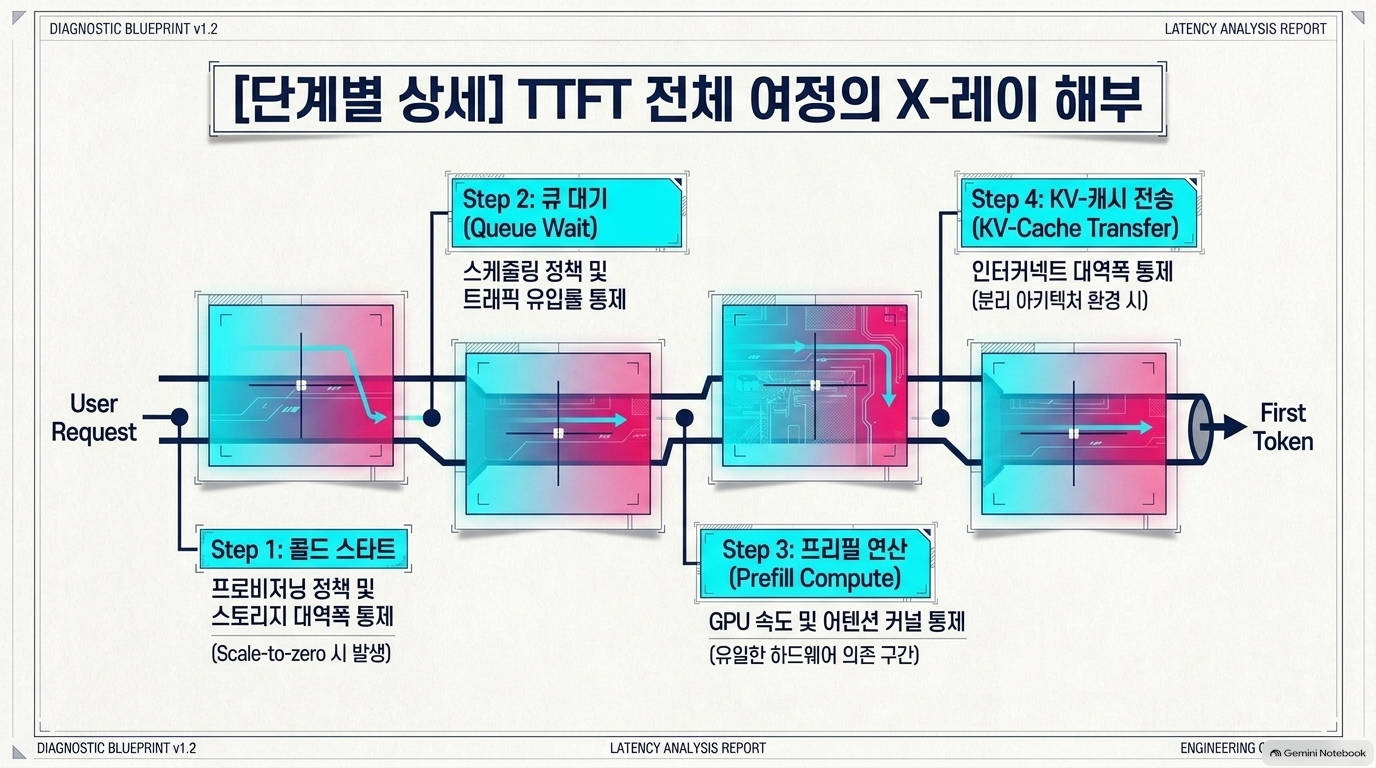
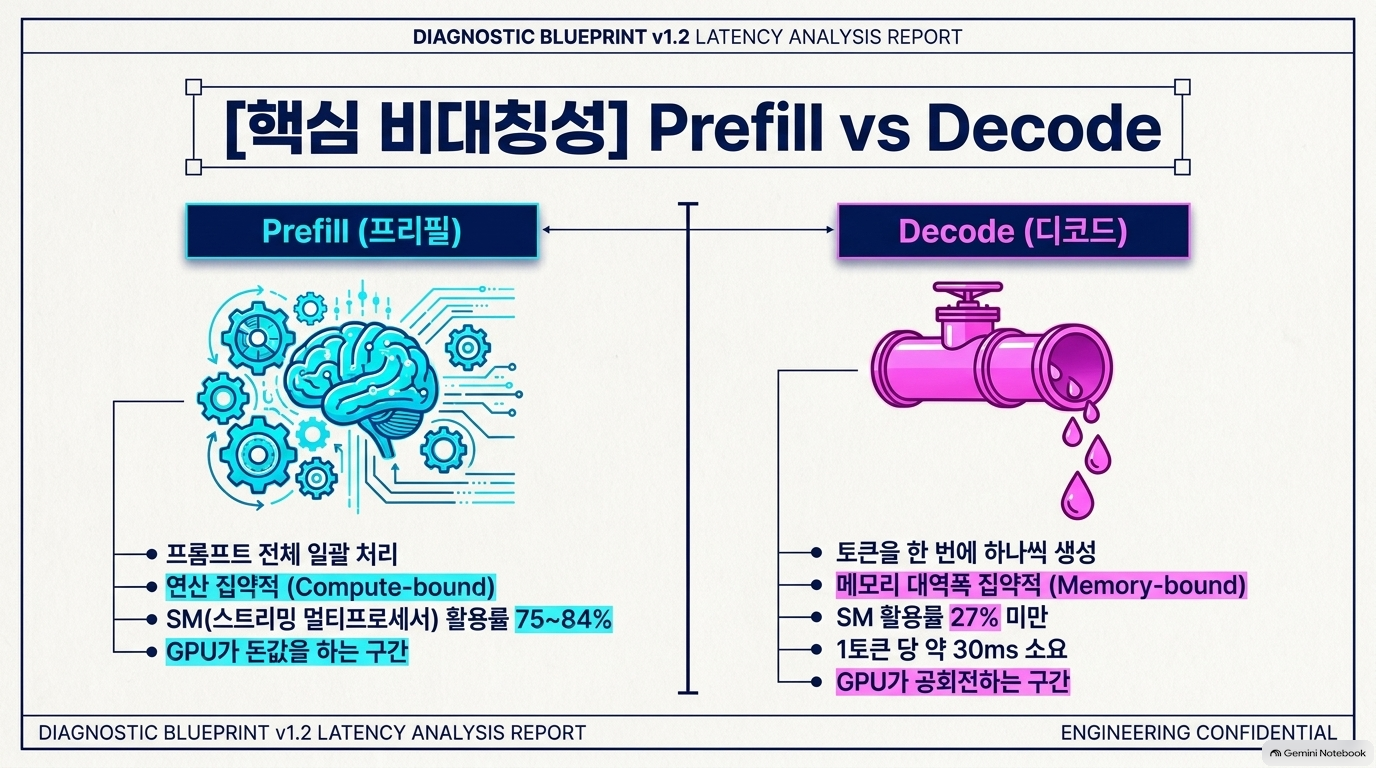
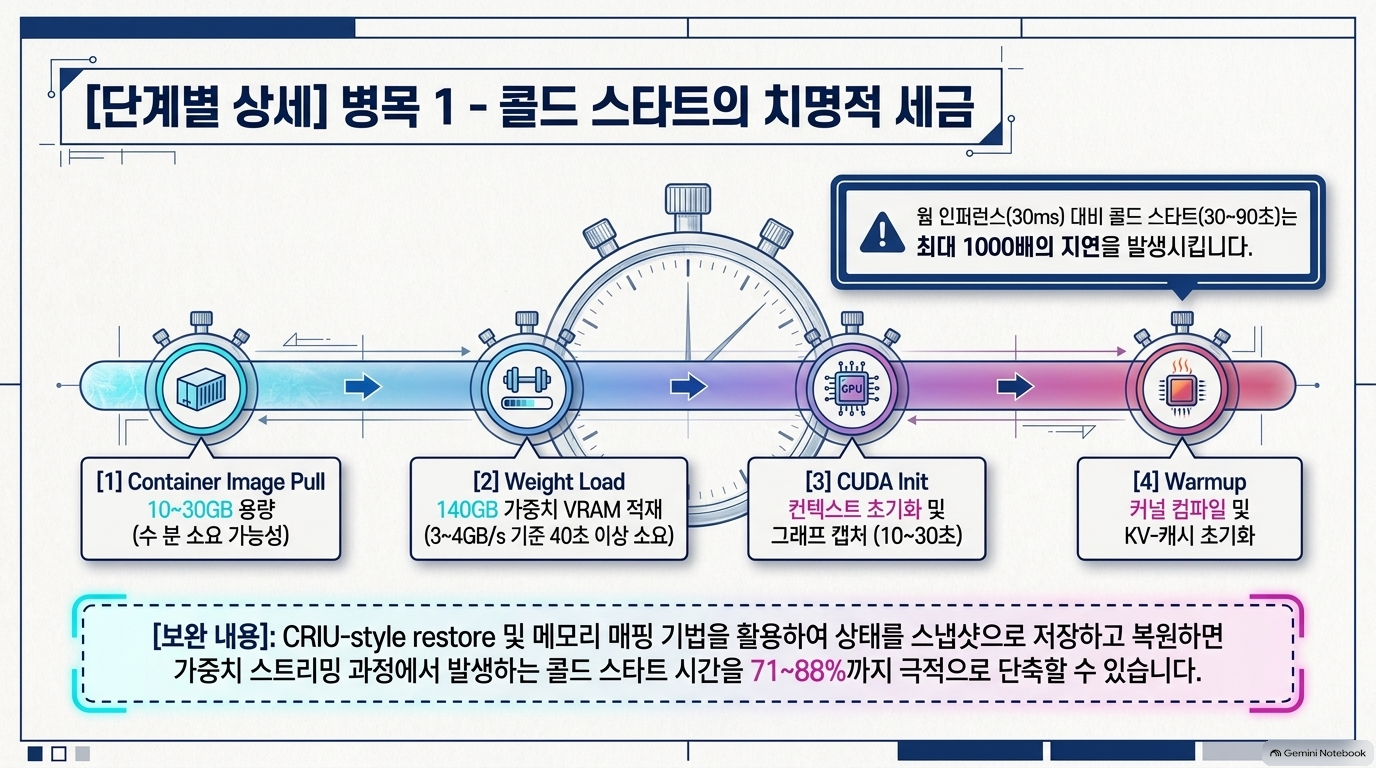
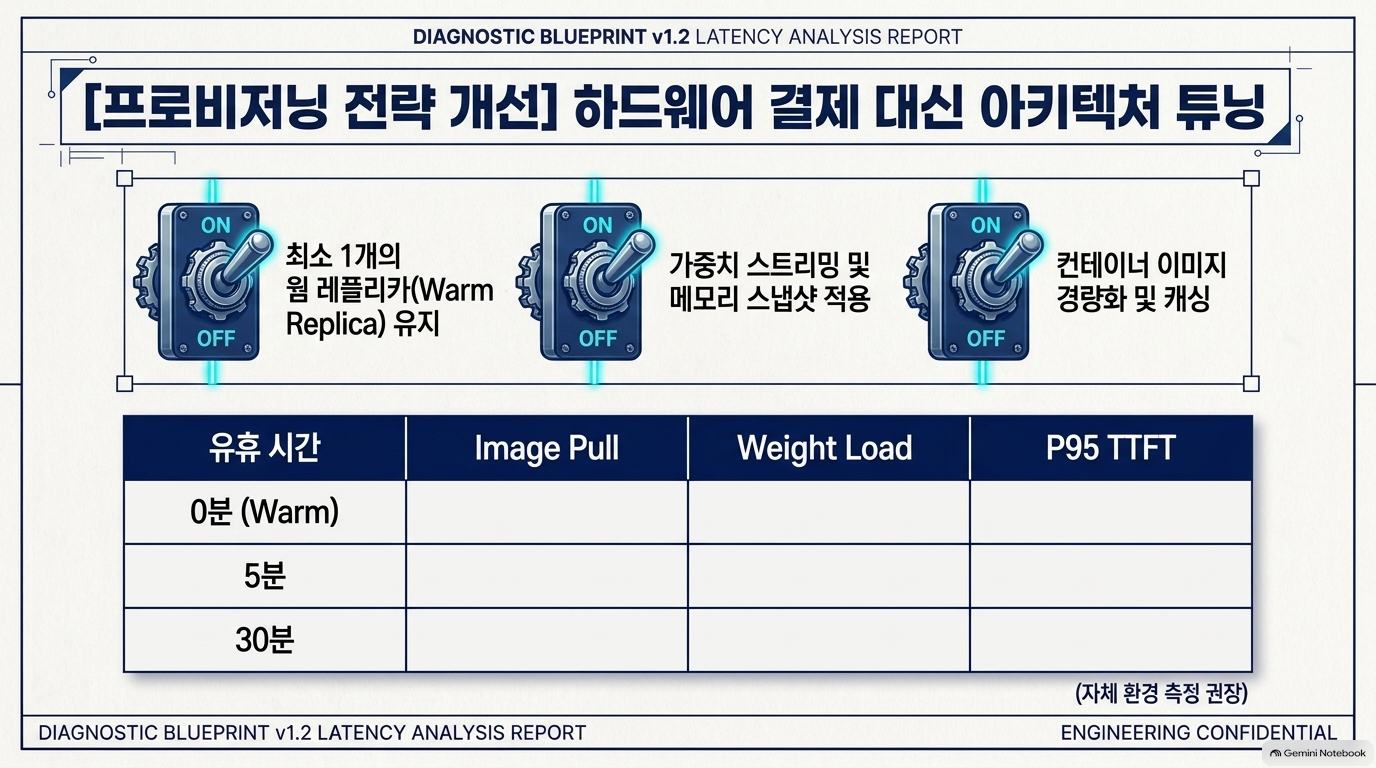
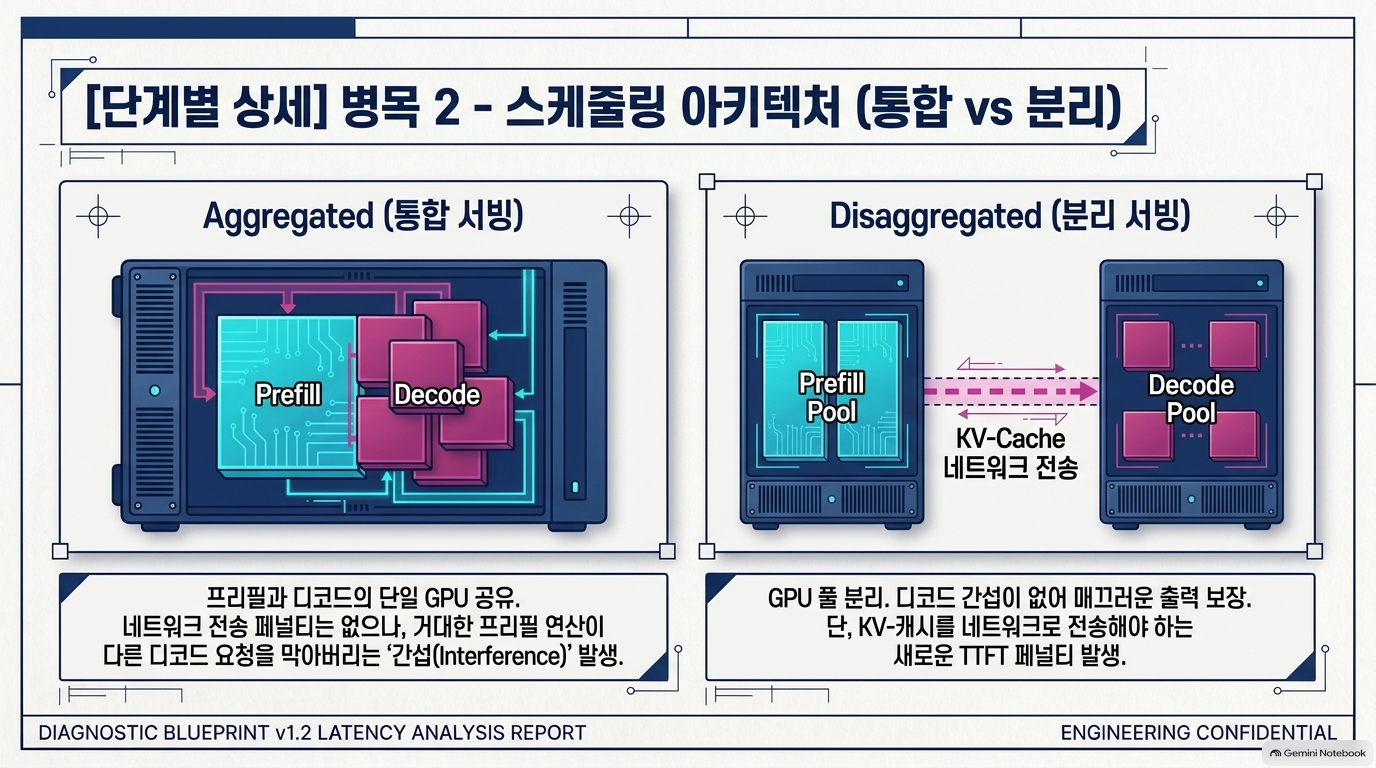
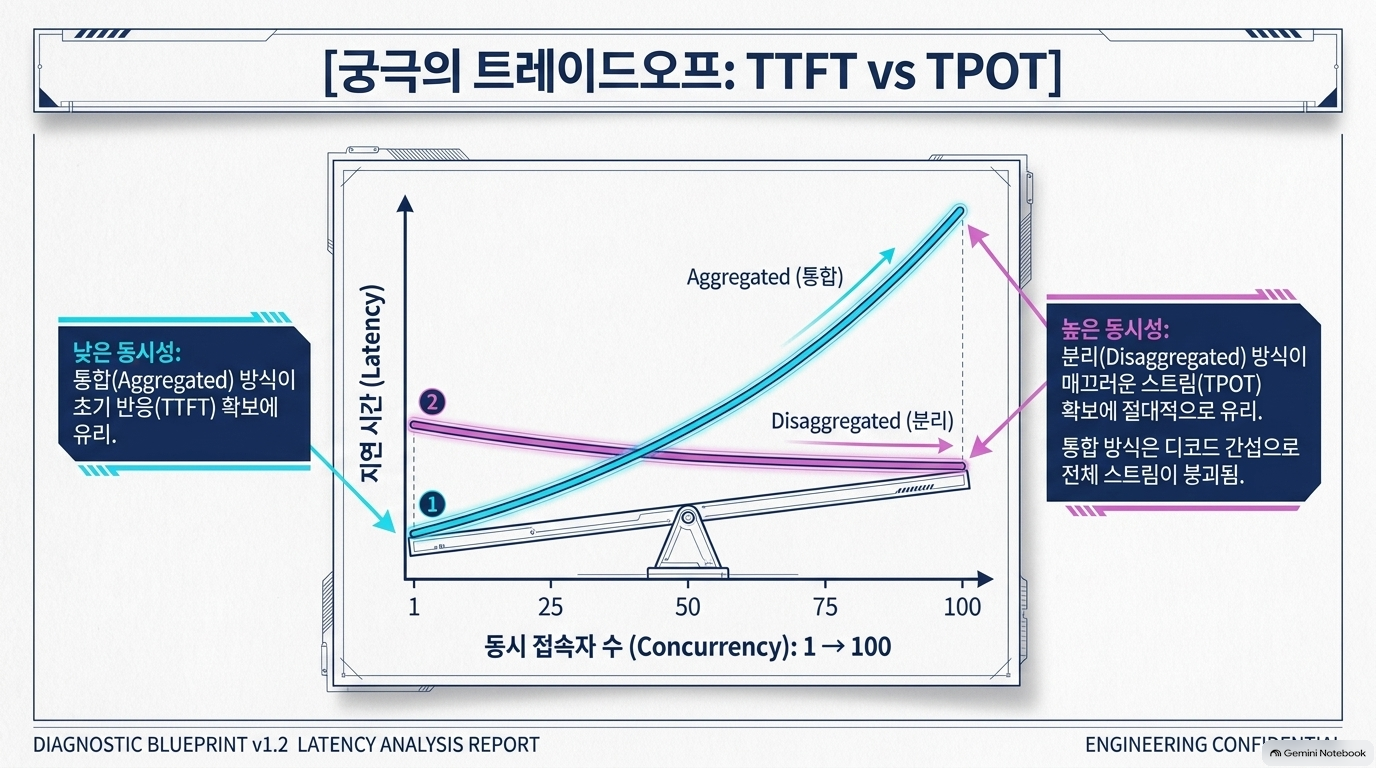
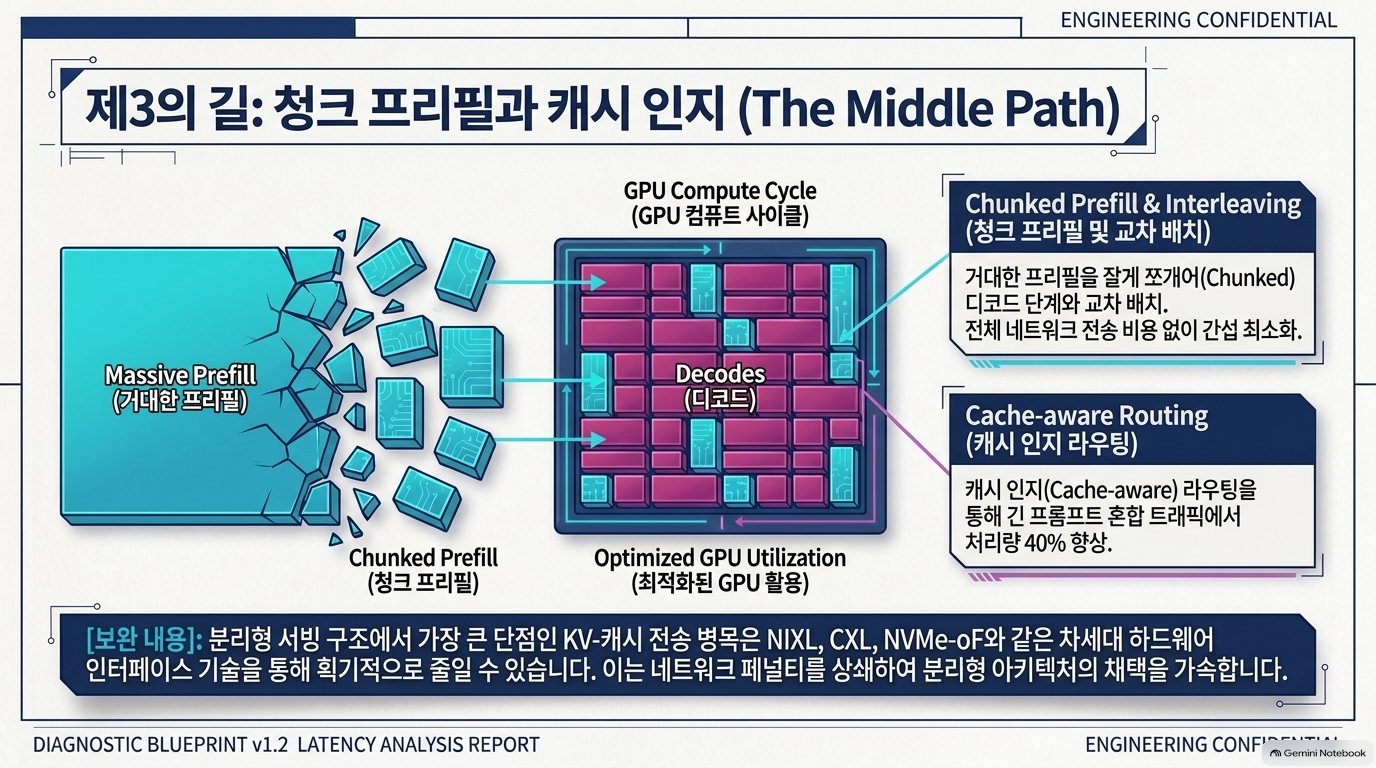
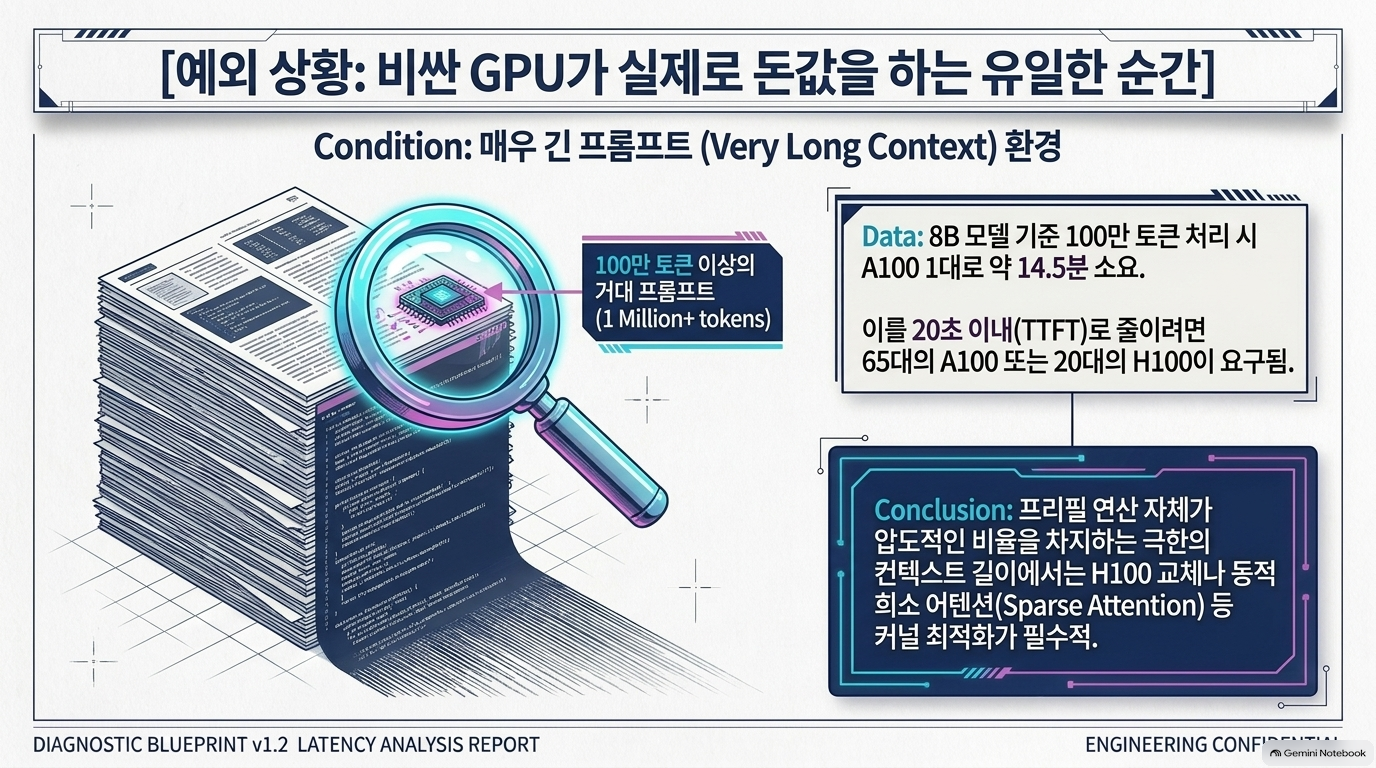
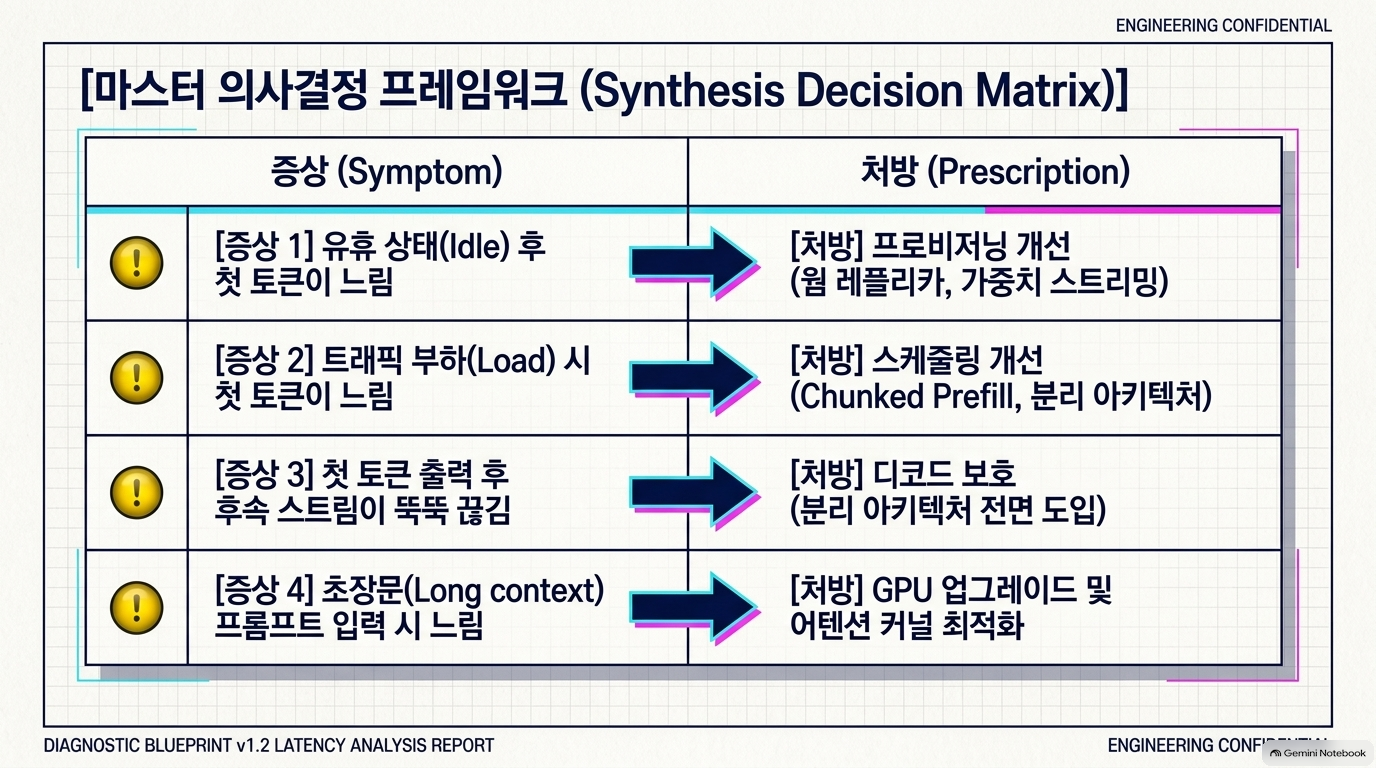
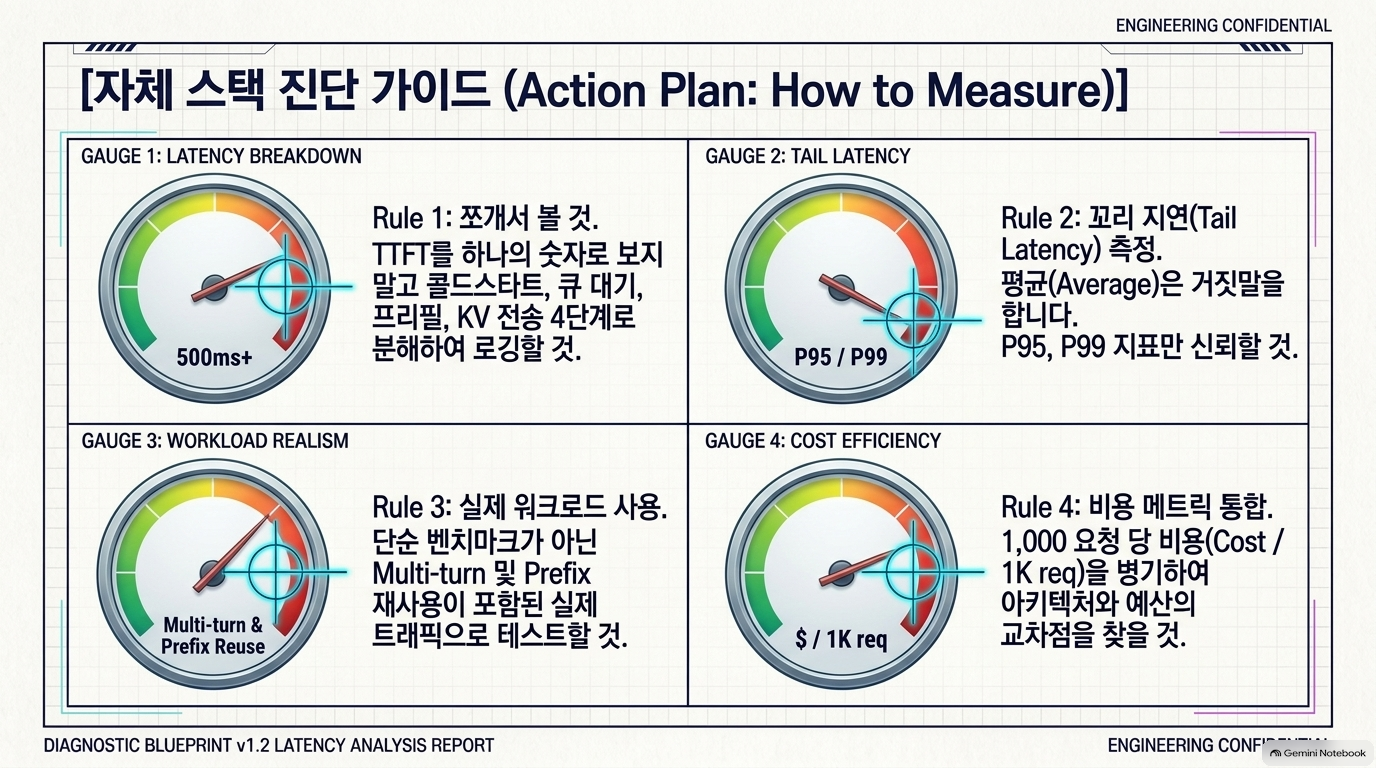
이 글은 AI 모델이 첫 번째 결과물을 출력할 때 발생하는 지연 시간인 Time-to-First-Token(TTFT)을 줄이기 위해서는 단순한 하드웨어 업그레이드보다 아키텍처 및 시스템 관리의 최적화가 훨씬 더 중요하다는 사실을 역설합니다. 실제 운영 환경에서 지연의 주된 원인은 GPU 연산 능력 부족이 아니라, 시스템을 처음 가동할 때 발생하는 콜드 스타트(Cold Start)나 요청이 밀려 발생하는 대기열 정체, 그리고 데이터를 전송하는 과정에서 생기는 병목 현상에 기인합니다. 필자는 연산 집약적인 프레필(Prefill) 단계와 메모리 대역폭이 중요한 디코드(Decode) 단계를 분리하여 관리하는 분리 서빙(Disaggregated Serving) 전략이나 상시 가동 복제본 유지와 같은 운영상의 선택이 성능 개선의 핵심이라고 설명합니다. 결과적으로 이 텍스트는 성능의 문제를 단순한 장비 탓으로 돌리기 전에 시스템 지표를 세분화하여 측정하고, 자신의 작업 부하가 연산 속도가 중요한 '초대형 컨텍스트' 영역인지 아니면 효율적인 스케줄링이 필요한 '일반적인 추론' 영역인지를 먼저 파악할 것을 권고하는 전략적 가이드라인을 제공합니다.
728x90
반응형